只是一个默认分类

算力商品化:远期曲线优化云GPU租赁实操

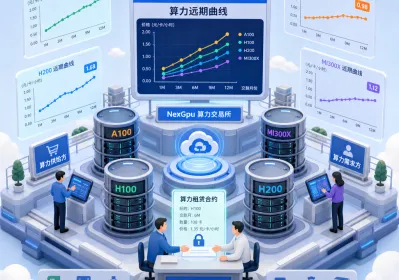
算力真的开始像油一样了最近两周,GPU租赁市场最扎眼的变化,不是哪款新卡上线,而是价格发现机制突然成熟了一截。预测市场平台推出了基于自身交易数据的GPU算力远期曲线,覆盖B200、H200和A100,直接给出市场对未来几周到几个月每小时租金的隐含预期。这玩意儿以前只存在于原油、天然气这类成熟商品里。现在算力也被这么对待了。简单说,远期曲线不是直接可交易...

云GPU利用率仅5%?MIG分区实操提效

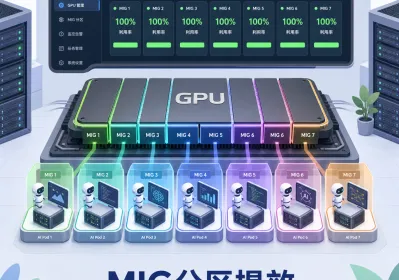
最近一份覆盖数万Kubernetes集群的分析数据,把AI基础设施的尴尬摊开了:GPU平均利用率只有5%。CPU大概8%,内存20%,GPU反而垫底。这意味着企业掏钱买来的昂贵算力,95%时间在空转。健康水平大约在50%左右,差距巨大。有人把整机房的H100、H200囤着,却因为“怕抢不到”而长期闲置,结果账单照付,产出寥寥。问题不在卡本身性能差,而在...
Blackwell云GPU:软件硬件联手砍token成本实操

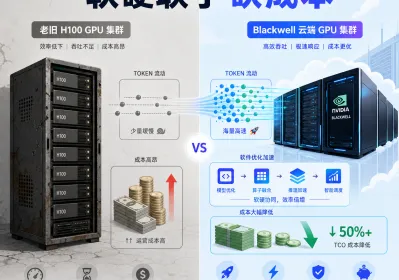
很多团队还在H100上跑推理,看着小时价觉得够用了。其实算token成本时,新一代Blackwell已经悄悄拉开差距。不是单纯换卡,而是硬件原生FP4吞吐叠加推理软件栈的持续迭代,让同样预算能吐出更多token。云端弹性租赁正好适合中小团队先试水,不用一次性砸钱买整机。先看硬件层面的变化。B200这类Blackwell GPU带来192GB级别显存和更...

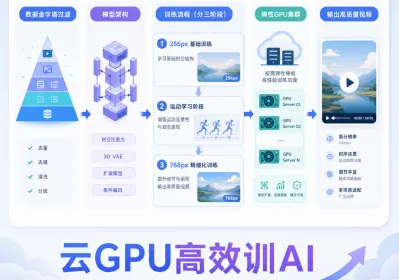
20万美金训商业级视频AI:云GPU实操

AI视频生成最近又火了一波,但很多人一算账就头疼。闭源模型训练动辄数百万美元,推理生成一段短视频的GPU小时数也居高不下。中小团队和创业者想自己做商业级质量,硬件门槛和运维成本直接卡死进度。好消息是,开源路线已经证明:通过精细数据筛选、分阶段训练和高压缩自编码器,总训练成本可以压到20万美元左右,性能却能和头部闭源产品掰手腕。Open-Sora 2.0...

云GPU推理:拆分服务KV优化实操

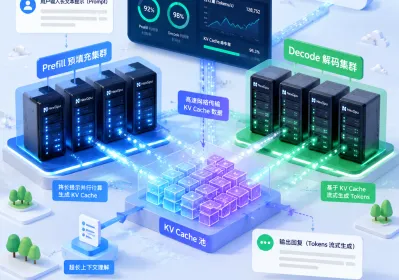
很多团队租了云GPU跑大模型推理,看着卡在那里却利用率上不去。看着监控,SM利用率常常只有二三十,甚至更低,钱却一分没少花。这不是卡不够强,而是推理本身的特性在作怪。推理分两段:prefill把长prompt或上下文一次性算完,生成KV cache;decode则一个token一个token往外吐。prefill偏计算密集,decode偏内存带宽。两者...