 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
先给答案:要不要实名认证、要不要提前申请配额,取决于你租的是哪一类平台,而不是"租 GPU"这件事本身有统一规则。
三句话版本:
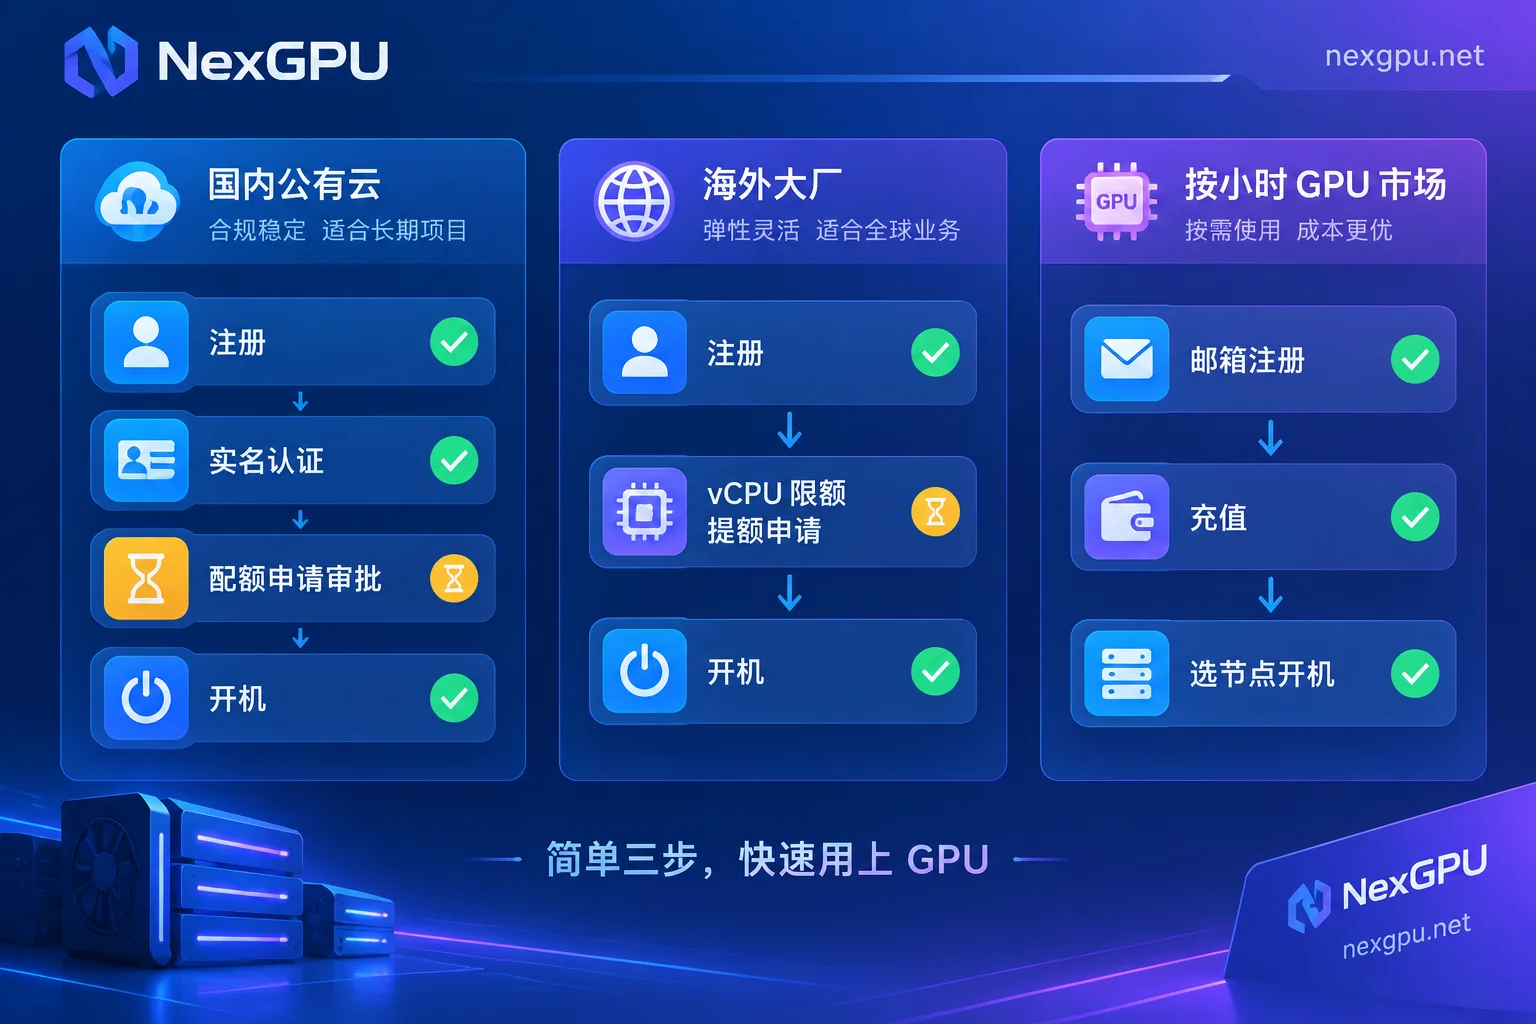
- 国内传统公有云(阿里云、腾讯云这类):实名认证是硬前置,GPU 实例的配额通常还要单独申请,两道门都得过。
- 海外大厂(以 AWS 为例):不需要交中国身份证做实名,但 GPU 机型受 vCPU 限额管着,新账号常常连一台完整 GPU 机器都开不起来,得先提额。
- 按小时计费的 GPU 算力市场(NexGPU 属于这一类):一般是邮箱注册、充值即用,没有工单式的事前配额审批,目标节点有库存就能直接开机。
下面分别说清各自的具体流程,以及你如果正卡在审批里该怎么办。
国内公有云:实名是第一道门,配额是第二道
在阿里云买 GPU 云服务器之前,个人账号要过身份证加人脸识别,企业账号要提交营业执照等资质,这一步不做完后面什么都开不了。这不是平台自己加的环节,是法规和风控层面的要求。腾讯云同样把"完成个人或企业实名认证"写进了云服务器的购买约束条件里。
过了实名还有第二道门:配额。ECS 对单个账号在特定地域的 GPU 卡数、vCPU 数量设有上限,而且新账号的高规格 GPU 资源配额默认就很低,甚至是零。你在控制台选好了机型,点创建时报错说配额不足,就是撞上了这个限制。处理方式是去配额中心发起配额提升申请,等人工审批通过之后才能创建实例。腾讯云也是类似逻辑——实例购买数量受账号配额限制,超出可用配额就得在控制台提交提升配额的申请。
有两个容易踩的细节:配额是按地域算的,A 地域批过了不代表 B 地域能开;配额是按规格族算的,批了一种卡不等于另一种卡也能开。所以如果你打算换卡或者换地区,可能要重新走一遍。
海外大厂:不用实名,但 vCPU 限额一样会拦住你
AWS 这边不要求中国身份证实名,但它用 Service Quotas 管着 GPU 资源。限额的计量单位不是"几张卡",而是按需运行的 G 系列、P 系列实例的 vCPU 总数。这个口径很关键:一台 GPU 机型往往带几十个 vCPU,新注册或者没有消费历史的账号,默认额度经常连一台都启动不了。
流程是去 Service Quotas 控制台提交提额申请,把使用场景写清楚,然后等审核。所以"AWS 不用实名所以更快"是个误解——省掉的是身份认证,没省掉的是审批等待。
按小时的 GPU 算力市场:没有工单,但有另外三个边界
轻量级的 GPU 算力市场走的是另一条路。通常邮箱注册就能建账号,不强制上传身份证或营业执照,也没有事前的工单式配额审批。只要市场里目标节点有可用库存,充值之后就能按小时拉起实例、加载镜像开始跑。对第一次租卡的创作者、要临时跑个开源模型的开发者来说,省掉的主要是等待时间。
但"没有配额申请"不等于没有任何约束,真正会影响你的是这三件事:
一是库存,而不是审批。 公有云那边你申请到了配额,资源大概率给你留着;市场这边是有货就能开、没货就得换节点或者换型号。所以计划跑大任务之前,先去价格与可租节点页看一眼目标卡型现在有没有在线节点,比提前一周准备材料更实际。NexGPU 的单价是下单时锁定、一直到销毁为止,这点对跑长任务的人有意义:中途市场价波动不会追加到你这台实例上。
二是支付和风控环节。 免身份实名不代表没有任何账户校验,充值方式、异常行为检测这些仍然存在。另外,单账户能同时开多少台卡,各家平台是否设有防滥用的并发上限、上限是多少,这类规则不在公开文档里的话不要靠猜——要开多机多卡或者集群规模的任务,直接问客服确认一句更省事,NexGPU 有中英双语的 Telegram 客服,团队和多卡方案也可以走联系页。
三是费用的边界,这是最容易吃亏的一项。 门槛低意味着你可能几分钟就开机了,但还没看清账单怎么算。NexGPU 的账单只有算力、存储、流量三项,其中停机只停算力,存储还在继续计费,只有销毁才全部停止。第一次租卡的人经常以为"关机了就不花钱",过几天回来发现还在扣。这部分可以先看GPU 实例关机还收不收费和云 GPU 存储费怎么算,把口径搞清楚再开机。
你该走哪条路
按你手上这件事的性质来定,不用纠结哪个平台"更好":
- 今天就要跑通一个任务(出图、跑个开源模型、做一次微调验证):选免配额审批的算力市场,实名和工单的等待时间在这种场景下纯属成本。
- 公司要求发票、合规审计、等保资质,或者要和已有的国内云内网打通:走国内公有云,实名和配额该办就办,提前留出审批时间。
- 要长期占用大规模集群、需要预留容量和承诺折扣:大厂的配额体系反而是优势,值得走完流程。
- 不确定要哪张卡、只是先验证方案可行:先在按小时的市场上用小规格跑通,摸清显存和耗时,再决定是否去申请大规格配额。这样即使审批被拒或者拖久了,方案验证也没停。
卡在配额审批里的时候怎么办
如果你已经提了申请在等结果,有几个动作可以并行:
换地域试试,配额是按地域独立的;降一档规格,小显存的机型默认配额往往更宽松;把使用场景写具体一点再提交——"跑机器学习"不如"用 vLLM 部署 7B 模型做推理服务,预计并发 X",审核方能判断合理性;同时在按小时的市场上把流程先跑一遍,环境、代码、数据链路都验证好,等配额批下来直接搬过去,不浪费等待期。
免了配额申请之后,开机前真正要准备的三件事
门槛低的平台把前置条件从"审批"挪到了"你自己想清楚",这三件事没想好,钱和时间照样会浪费:
镜像选对,别在实例里现编译。 开机后手动装 CUDA、编译依赖,动辄一两个小时,这段时间卡是在计费的。按任务直接挑现成模板——推理服务用 vLLM 或 TGI,本地对话用 Ollama,训练微调用 PyTorch,出图用 ComfyUI,语音转写用 Whisper,都可以在镜像模板页一键部署。挑选思路可以参考云 GPU 镜像模板怎么选。
数据先想好放哪。 停机保盘、销毁清空,这个边界决定了你的权重和产出该不该留在实例里。做法见租的 GPU 实例数据怎么保存。
选卡按显存门槛来,不靠感觉。 每个模型需要多少显存、该租哪张卡,官网的模型选卡指南按模型列得比较细,比自己试错快。
把这三件事定下来,"不用实名、不用等配额"带来的那点速度优势才真的落到你手上。



评论(0)