 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
结论先行:多模态显存三档卡型怎么落位
多模态大模型GPU显存配置推荐可以先记住三个落点:11B 级视觉模型至少 32GB 显存卡型(如 RTX 5090、L40S),单卡吃紧或高并发时上 80GB(如 A100 80GB),90B 级必须 8 卡 TP=8 张量并行。
视觉模型上云后,显存规划比纯文本模型更容易失准,原因在于多出三笔增量开销。下面这份速查表可直接参考:
| 模型规模 | 权重量级 | 建议卡型 | 典型场景 |
|---|---|---|---|
| 11B 级 | FP16 约 22GB | 32GB(RTX 5090 / L40S) | 单图、低并发、分辨率适中 |
| 11B 级高并发 | FP16 约 22GB | 80GB(A100 / H100) | 多图、高分辨率、高并发 |
| 90B 级 | 多卡分摊 | 8 卡 TP=8 | 长文档、复杂图文、高吞吐 |
后文按固定项、变动项、并发项三笔增量拆解,帮你把账算清。
为什么纯文本的“参数量×2”算不准多模态显存
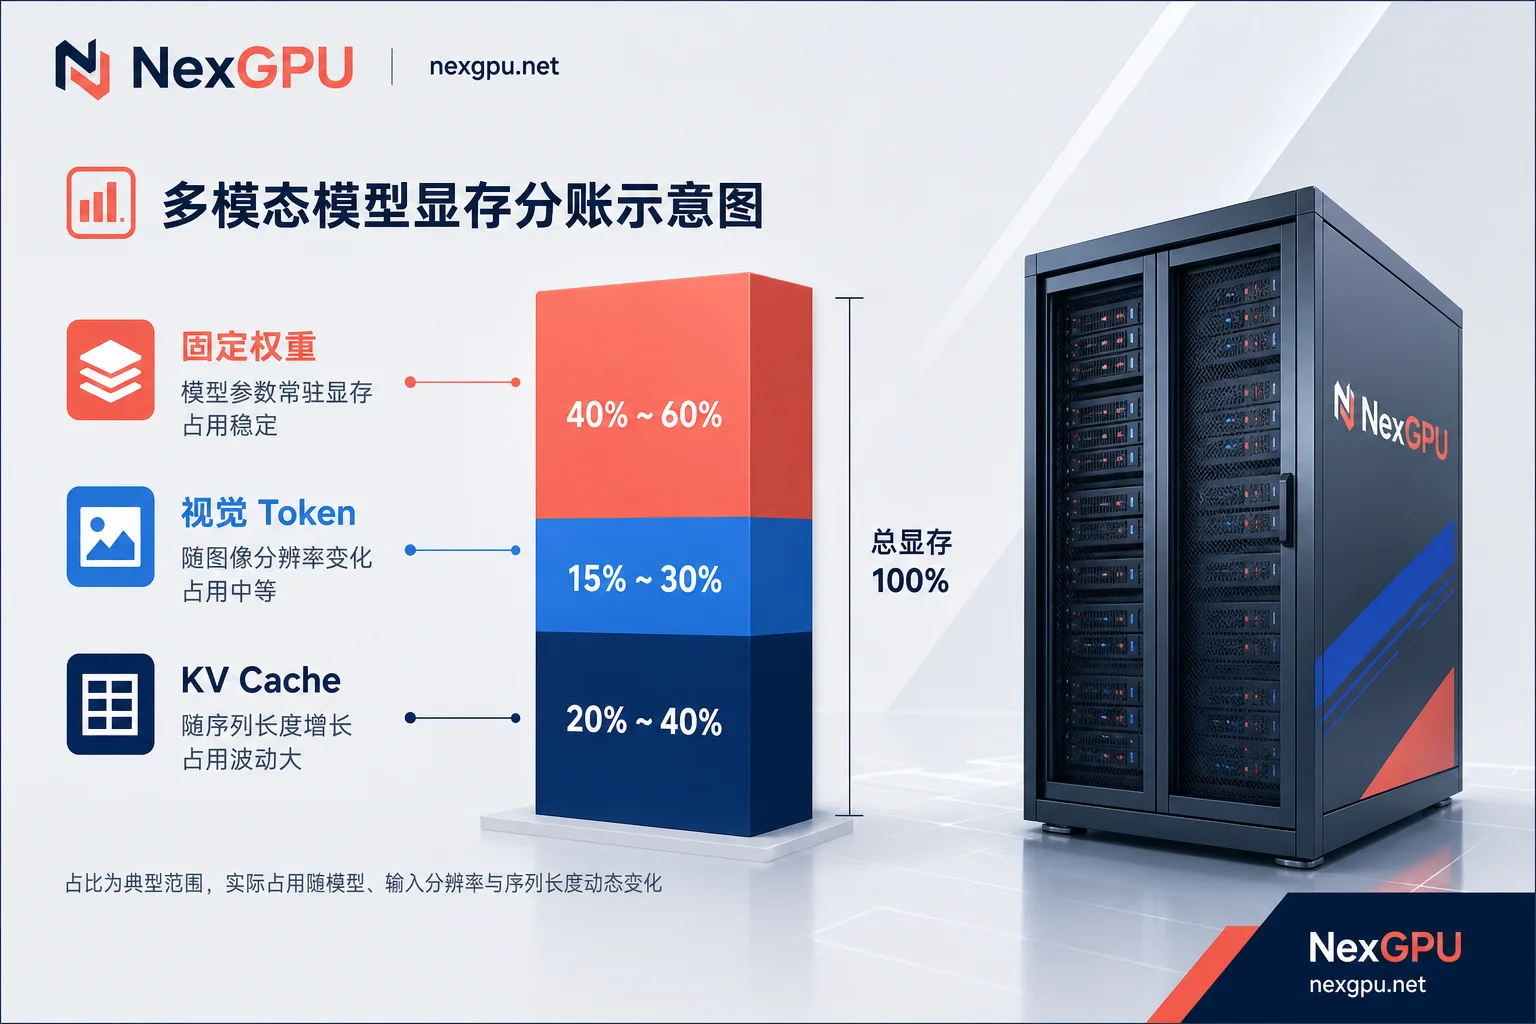
很多开发者直接套用纯文本模型的粗估公式,可以参考 Qwen部署要多少显存 了解文本基线。但这个公式在多模态上必然失准,因为它漏掉了三块:图像编码器与投影层的固定权重、单图展开后的序列膨胀、Cross-Attention 带来的额外 KV。
比如在 24GB 显卡(如 RTX 4090)上跑 11B 视觉模型,权重就占去约 22GB,剩余 2GB 根本扛不住视觉 Token 的 KV Cache,反复 OOM 是常态。多模态模型显存怎么算?按固定项、变动项、并发项三类拆,比套公式靠谱得多。
第一档增量(固定项):视觉编码器与投影层权重怎么算
视觉编码器与投影层是常驻权重,与请求无关,开机即占用。以 11B Vision 模型 FP16 权重约 22GB 为锚点,这比同参数级别的纯文本模型多出一块固定开销(视觉塔和投影层),而且这块开销不随并发数下降,必须全额预留。
这部分没有技巧,只能按权重量级实打实计入静态底盘。
第二档增量(变动项):一张图展开成多少 Token
视觉模型采用动态分辨率 ViT 架构(如 Qwen2.5-VL),图像会被动态编码为可变数量视觉 Token。官方给出常规推荐范围 256~1280 个 Token,极限可达 16384 个。因此,视觉模型图像 Token 占多少显存没有固定答案,取决于分辨率与切图策略。
分辨率提高、多图输入、长文档切页都会让序列长度成倍拉长,激活值与自注意力 KV 随之非线性增长。比如一张高分辨率图可能展开上千 Token,而多图输入则直接叠加,显存压力陡增。
第三档增量(并发项):Cross-Attention 的额外 KV 为什么先爆
Llama 3.2 Vision 这类模型通过交叉注意力接入视觉特征,会产生额外 KV 开销。叠加图像 Token 后,KV Cache 通常需按权重的 20%~30% 预留。并发一上来,最先撑爆显存的往往不是权重,而是 KV 池。
怎么反推最大并发?按官方给出的 20%~30% 权重比例圈出 KV 预留区间,再用单请求实际占用的 KV 去除,即可得到并发上限的量级;单请求 KV 占用取决于视觉 Token 数与序列长度,必须以实测收敛,不能靠公式定值。
11B 级模型落哪一档:32GB 卡型的可用余量与请求上限
以约 22GB 权重为底,32GB 卡型留给视觉激活、KV Cache 与框架碎片的余量不足 10GB,实际可用值还要扣掉运行时开销,需以实测为准。
因此,80GB 卡型在高分辨率多图、高并发场景下是必要的。至于 24GB 消费级卡,跑 11B 视觉模型的长上下文全分辨率服务基本不现实,权重占掉 22GB 后余量太少。
90B 级模型为什么必须多卡:TP=8 的切分与显存分摊
90B 级视觉模型在云端部署需要 8 卡集群配合 TP=8 张量并行。权重按 8 张卡均分后单卡压力明显下降,但每卡仍要承担各自分片的 KV 与激活,具体单卡占用取决于切分方式与框架实现,需实测确认。
实操顺序是先确认单节点 8 卡互联(如 NVLink),再确认框架对视觉模型的 TP 支持(vLLM多卡张量并行配置指南)。90b多模态模型要几张卡?答案是 8 张,这是并行切分的基本要求。
反过来用:从业务图片规格倒推卡型的四步顺序
与其照搬通用清单,不如用业务数据自己推一份多模态大模型GPU显存配置推荐。按这四步从业务倒推:
- 统计业务真实图片分辨率与单请求图片数量。
- 估算视觉 Token 区间(对照 256~1280 常规范围,极限 16384)。
- 加上固定权重(如 22GB)得到静态底盘。
- 按目标并发预留 KV 比例(20%~30%),落到 32GB / 80GB / 多卡三档。
Token 数是区间不是定值,最终需实测收敛。这样算出来的配置才贴合你的业务,而不是拍脑袋。
做一次显存峰值实测:单图、多图、高分辨率三组记录什么
实测方案建议记录:静态权重占用、首次请求后的峰值、KV 池水位、触发 OOM 的并发阈值、请求延迟变化。
在 32GB 级卡型上跑通三组请求,实测峰值后再决定是否上 80GB 或多卡。NexGPU 的按量 GPU 资源支持先租 32GB 卡型做验证,也有预制模型与应用模板缩短环境配置时间,适合起步阶段。
配置检查清单与四个常见误判
| 误判 | 纠正动作 | 卡型调整 |
|---|---|---|
| 只算权重没算视觉 Token | 按分辨率估算 Token 区间 | 可能需要更大显存 |
| 把 Token 数当固定值 | 按区间留余量 | 预留 20%~30% KV |
| 忽略 Cross-Attention KV | 计入额外 KV 开销 | 增加显存或并发限制 |
| 用低分辨率样例验证 | 用真实业务分辨率测试 | 调整档位 |
逐条核对后,你的多模态大模型GPU显存配置推荐才算落到真实业务上。
另外,可参考 GPU Out of Memory显存溢出解决方法 处理 OOM 问题,以及 FP8与INT4量化对GPU显存的影响 了解量化降低显存的可能。
常见问题
Llama 3.2 Vision 11B 需要多少显存?
FP16 权重约 22GB,叠加图像 Token 与 20%~30% KV Cache,建议至少 32GB 显存。若追求高分辨率或多图并发,推荐 80GB 卡型。24GB 卡型跑简单场景可能勉强,但长上下文或高并发会 OOM。
24G显存能跑多模态大模型吗?
能跑小规模或低分辨率场景,但 11B 级视觉模型权重就 22GB,剩余空间不足以支撑长序列或高并发。实测中很容易因 KV Cache 不足 OOM。建议至少 32GB,若业务复杂直接上 80GB。
Qwen2.5-VL 部署用什么显卡?
Qwen2.5-VL 采用动态分辨率,Token 展开区间大。常规使用 32GB 卡即可,如果常处理高分辨率或多图,选 80GB 更稳妥。可参考 Qwen部署要多少显存 了解文本基线。
视觉模型图像Token占多少显存?
取决于分辨率与切图策略,常规 256~1280 Token,极限 16384。每个 Token 影响激活与 KV 大小,显存占用非线性增长。建议估算区间并预留 20%~30% KV 余量。
90B多模态模型要几张卡?
需要 8 卡集群配合 TP=8 张量并行,权重按卡切分,每卡仍需承担分片 KV。单卡无法放下权重,多卡是必需。先确认节点互联与框架支持。
多模态推理显存不够怎么办?
先按四步倒推卡型,再实测三组请求看峰值。若仍不够,可尝试降低分辨率、限制图片数量、调整 KV 预留比例,或使用量化(如 FP8)减小权重占用。若业务需要高并发,直接升级 80GB 卡或多卡方案。



评论(0)