 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
先分清 Prefill 阶段的算力开销与 Decode 阶段的带宽开销各占哪一段,再据此确定硬件规格。
推理GPU的开销构成:算力、显存带宽与常驻显存各买到了什么
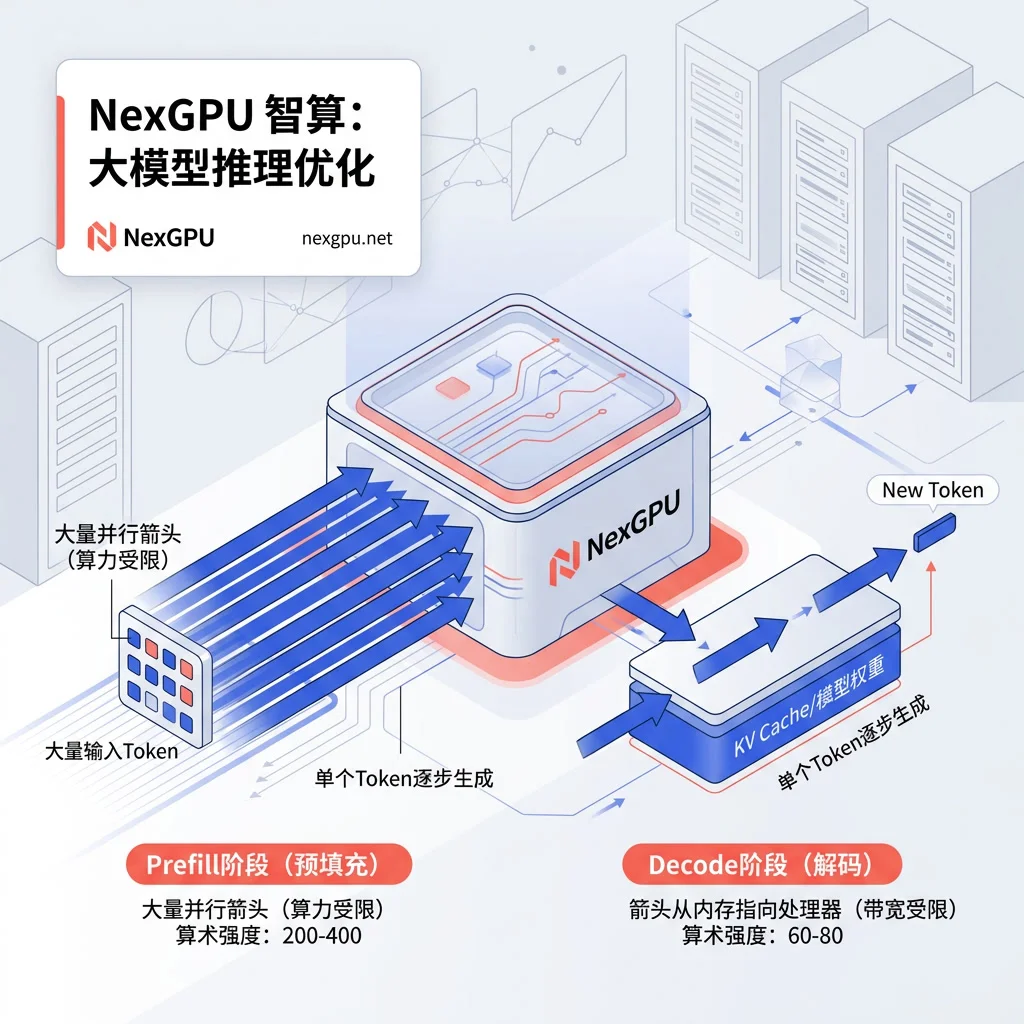
一张大模型推理GPU的价值并非单一维度的峰值算力,而是由三笔可分别核算的开销构成:并行处理输入 Prompt 所消耗的算力、逐 Token 生成时反复搬运权重与 KV Cache 所消耗的显存带宽、以及必须常驻的模型权重与运行时占用。在 Prefill 阶段,模型并行计算所有输入 Token,算术强度高达 200-400 ops/byte,此时负载属于典型的算力受限(Compute-bound)。然而进入 Decode 阶段后,自回归生成每一步都必须完整读取模型权重与 KV Cache,算术强度骤降至 60-80 ops/byte,负载性质转变为显存带宽受限(Memory-bandwidth-bound)。这意味着同一张卡在两段负载里的性价比完全不同。如果业务特征是长输入短输出,主要在为算力付费;若是短输入长输出,则主要在为带宽付费。
解码延迟为什么由带宽决定:算力核心大多在等显存数据
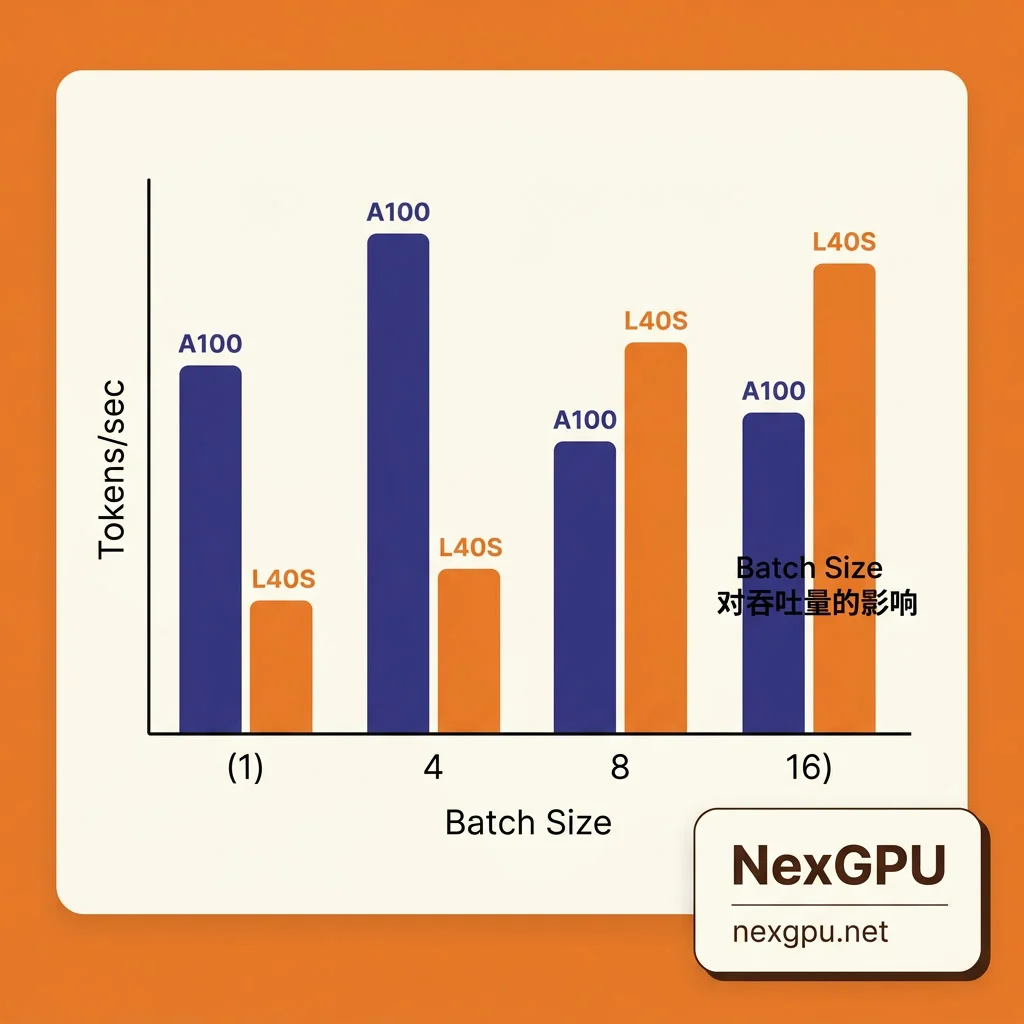
许多团队遇到推理慢是算力不够还是显存带宽不够的疑问时,往往倾向于堆叠算力卡,但这通常是误判。单字生成延迟(ITL)直接由显存带宽决定,因为 Decode 阶段的核心任务是从显存中读取数据,而非进行复杂计算。以 L40S 与 A100 80GB 为例,前者采用 GDDR6 显存,带宽为 864 GB/s;后者采用 HBM2e 显存,带宽达 2,039 GB/s。L40S 的带宽仅约为 A100 的 42%。在 Batch 1-4 的低并发场景或长上下文单流场景下,由于瓶颈完全卡在数据搬运上,A100 凭借带宽优势带来了接近 1.9 倍的解码吞吐提升。此时即便 L40S 拥有更高的 FP8 理论算力,也无法弥补带宽短板导致的等待时间。
显存下限怎么反推:权重、KV Cache 与运行时常驻三项分开算
确定大模型推理GPU的显存容量时,不能仅看模型参数大小,需按加法顺序预算:模型权重按实际精度落盘大小计算、KV Cache 随并发数与上下文长度成乘法增长、推理引擎与中间张量还有一块固定常驻开销。针对 MoE 架构模型,严禁按激活参数量估算显存,因为所有专家权重必须完整驻留以供动态路由。例如 671B 级模型在 FP8 精度下的物理显存门槛依然在 700GB 以上,远超单卡能力。对于常见的 48GB 显存档位,它通常只能承载经过深度量化的小型模型或作为多卡集群的一部分,无法独立运行大型稠密模型。若需评估具体模型的显存需求,建议参考FP8与INT4量化对GPU显存的影响中的详细算法逻辑,结合自身业务的上下文长度进行精确推导。
L40S 与 A100 80GB 卡型对照:低并发单流与高并发批处理各归谁
在选型时,需根据并发深度区分适用场景。下表展示了两种主流卡型的关键参数与适配区间:
| 参数项 | NVIDIA L40S | NVIDIA A100 80GB |
|---|---|---|
| 显存容量 | 48GB GDDR6 | 80GB HBM2e |
| 显存带宽 | 864 GB/s | 2,039 GB/s |
| 关键算力指标 | 原生 FP8: 733 TFLOPS | BF16: 312 TFLOPS |
| 最佳适配场景 | Batch 8+ 高并发批处理 | Batch 1-4 低并发/长上下文单流 |
| 带宽相对占比 | 约 42% (vs A100) | 基准 100% |
L40S 在高并发 Batch 8+ 场景下,凭借 Ada Lovelace 架构的原生 FP8 Tensor Core 算力,能在吞吐量上反超 A100 的 BF16 算力。但在低并发或对延迟敏感的长文本生成中,其带宽劣势明显。在长期锁定卡型之前,可以用NexGPU的多卡型可选与按量计费的能力,把同一负载分别在 48GB 中端卡与 80GB HBM 卡上各跑一次,用实测数据代替参数表判断,避免按峰值参数选错。
精度档位与硬件代际绑定:FP16、FP8、FP4 各需要什么 Tensor Core
量化收益必须有硬件指令支撑,不同代际的大模型推理GPU支持的精度档位差异巨大。Ampere 架构的 A100 搭载第三代 Tensor Core,缺少原生 FP4 硬件支持,软件模拟不会带来吞吐提升,因此“FP4量化在A100上能加速吗”的答案是否定的。Ada Lovelace 架构的 L40S 具备原生 FP8 支持,能有效降低显存占用并提升算力利用率。而 Blackwell B200 的第五代 Tensor Core 原生支持 FP4,Dense 算力达 9,000 TFLOPS。读者需确认手上的卡型能否吃到特定精度的红利,量化方案应在选卡前依据硬件代际确定,而非事后强行迁移。
从多卡集群迁到 B200 级节点:什么负载值得等,什么负载现在就够
Blackwell B200 单卡配备 192GB HBM3e 显存与 8TB/s 带宽,这一规格使得万亿参数或 671B 级 MoE 模型的显存与计算拓扑得以收缩进更少节点,从而大幅降低跨机张量并行的通信开销。对于受跨节点通信拖累的超大模型密集推理负载,规划迁移至 B200 级节点具有显著价值。但对于中小模型的高并发服务,现有卡型如 A100 或 L40S 已能接住需求,无需盲目等待新架构。供给方面,B200 多以邀测与商务定制形式交付,具体价格仍在动态调整。在决策前,应先固定同一负载与上下文长度作为对照基准,评估现有集群的通信瓶颈占比。
把时租折成每百万 Token 成本:按真实利用率修正的一笔账
最终选型需回归成本账。每百万 Token 的综合成本公式为:Cost per 1M tokens =(GPU 每小时租金 ÷(实际 TPS × 3,600))× 1,000,000。在实际业务中,由于请求潮汐效应,GPU 平均利用率通常处于 30% 至 60% 之间。若未启用连续批处理(Continuous Batching)提升有效吞吐,实际 Token 成本往往比峰值满载测算高出 2 到 3 倍。以假设租金变量代入,读者需将自身的报价填入公式自行折算。例如,若某卡小时租金为 $R$,在 Batch Size=1 时的实际 TPS 为 $T_1$,则单位成本直接取决于 $T_1$ 而非理论最大值。通过DeepSeek-R1私有化部署GPU配置中的案例可以看出,不同并发深度下的 TPS 变化会剧烈改写单位成本,切勿仅凭标称算力做预算。
常见问题
如何快速判断推理瓶颈是在算力还是带宽?
观察 Prefill 与 Decode 阶段的耗时比例。若输入极长且首字延迟高,多为算力受限;若输出很长且后续每个 Token 生成缓慢,即使 GPU 利用率看似不高,也通常是显存带宽受限。可通过监控内存带宽利用率来验证,若接近饱和则为带宽瓶颈。
48GB显存能跑多大的模型?
这取决于量化精度。FP16 下 48GB 仅能容纳约 24B 参数的模型权重,加上 KV Cache 和运行时开销,实际可运行的稠密模型规模更小。若使用 INT4 或 FP8 量化,理论上可容纳更大参数量的模型,但需注意 MoE 模型需全部专家权重驻留,48GB 单卡难以运行大型 MoE。
旧架构卡做低比特量化能拿到与新架构相同的吞吐收益吗?
不能。A100 等 Ampere 架构卡缺乏原生 FP4 支持,软件模拟不仅无法提升吞吐,反而可能因转换开销降低效率。只有像 Blackwell 这样原生支持 FP4 的新一代架构,才能从低比特量化中获得显著的算力密度提升。
按量租用推理卡时如何折算才不至于亏?
关键在于引入“实际利用率”修正系数。不要直接用峰值 TPS 计算,而应基于历史流量的平均并发度估算 TPS。同时,务必启用连续批处理技术以提升空闲时间的资源复用率,否则在潮汐流量下,闲置成本会将单位 Token 价格拉高 2-3 倍。
低并发低延迟场景与高并发吞吐场景该分别倾向哪一类卡?
低并发、对首字和间隔延迟敏感的场景,应优先选择 HBM 带宽高的卡型(如 A100/H100),以减少数据等待时间。高并发、追求整体吞吐量最大化的批量处理场景,可选择具备强大原生 FP8/FP16 算力且显存容量足够的卡型(如 L40S),以摊薄单次计算成本。



评论(0)