 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
单张 A100 80GB 装不下 Llama 3 70B FP16 权重,必须跨卡;但经 4-bit 量化后,8 卡 A100 可承载 DeepSeek-R1 私有化推理。评估 A100租用 价值需区分“装得下”与“跑得动”,将显存空间与数据搬运速度分开核算。
A100 80GB 的显存分账与带宽线
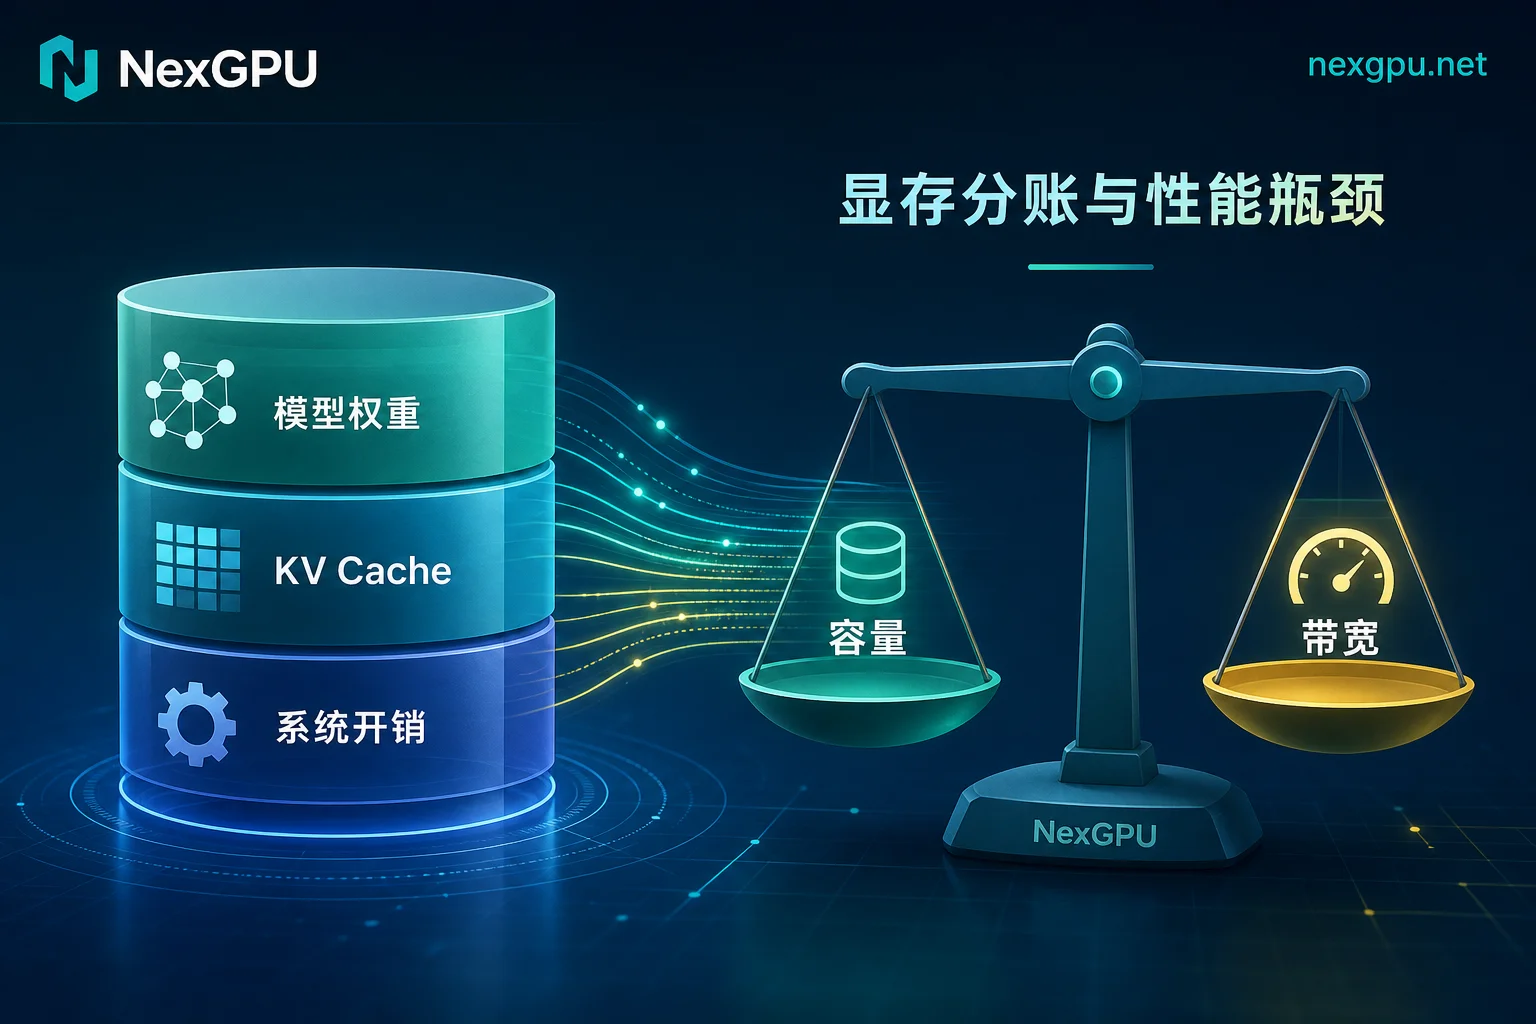
单张 80GB 显存的可用空间并非全部用于存放权重,需拆分为模型权重、KV Cache、运行时与推理引擎常驻三项。以 Llama 3 70B 为例,FP16 全精度下权重约 140GB,显然无法装入单张 80GB 卡,必须采用 TP=2(张量并行)拆分至双卡运行。此时,瓶颈不再仅仅是算力,而是跨卡通信带来的延迟。
容量线决定“装得下装不下”,带宽线则决定解码阶段每个 Token 的数据搬运速度。若 KV Cache 余量不足,并发数与上下文长度将被强制压低,导致 GPU 利用率低下。因此,判断是否需要更大显存,首先要看剩余空间能否支撑预期的业务峰值。
671B 量化后的落位:八卡 A100 的边界
针对 DeepSeek-R1 这类 671B 总参数(单 Token 激活 37B)的 MoE 模型,FP8 精度下权重及 MTP 模块需约 685GB 显存,通常需要 8×H200 或 16 张 80GB 卡才能跑满。然而,经 AWQ/INT4 等 4-bit量化 后,权重占用降至约 335~400GB。这一压缩使得单机 8×A100 80GB(合计 640GB)成为可行的私有化推理配置。
但需注意,640GB 中扣除权重后,剩余空间需为 KV Cache、通信缓冲与引擎常驻留出余量。余量的多少直接决定了能开启多大并发以及支持多长的上下文窗口。如果余量捉襟见肘,即便理论参数达标,实际服务体验也会因请求排队、块驱逐或重算、并发与最大上下文被迫下调而大幅劣化。
A100、H100 与 H200 的显存容量与落位对照
纠结 a100和h100租用差价值不值 前,需明确两者在 70B FP16 场景下同样受 80GB 容量线约束,均需 TP=2。真正的差异在于 H200 的容量与带宽升级。NVIDIA 官方数据显示,H200 采用 Hopper 架构 GH100 芯片,其计算单元与密集 FP8 算力(1,979 TFLOPS)与 H100 完全相同。H200 的优势仅在于搭载 141GB HBM3e 显存及 4.8TB/s 带宽,较 H100 80GB HBM3 提升 76% 容量与 1.4 倍带宽。
| 指标 | A100 80GB | H100 80GB | H200 141GB |
|---|---|---|---|
| 单卡显存容量 | 80 GB | 80 GB | 141 GB |
| 70B FP16 权重装载 | 否 (需 TP=2) | 否 (需 TP=2) | 是 (单卡常驻) |
| 671B 4-bit 权重所需卡数 | 8 卡 | 8 卡 | 4 卡 |
| 跨卡通信开销影响 | 高 (TP=2) | 高 (TP=2) | 低 (单卡常驻) |
这意味着,在 H200 上运行 70B FP16 模型可省掉跨卡张量并行的通信延迟。同代内多付的租金,买到的不是更快的计算,而是更大的常驻空间与更顺畅的数据搬运能力。
按量时租折算每百万 Token 成本
要准确评估 A100租用 的经济性,不能只看时租单价,必须建立每百万 Token 成本的折算口径:
每百万 Token 成本 = (卡数 × 单卡时租 ÷ 实测每小时输出 Token 数) × 100 万
分母中的“实测每小时输出 Token 数”必须来自真实负载测试,而非标称算力。折算前需采集以下变量:卡数与并行方式、平均输入与输出长度、并发数、prefill 与 decode 分别的吞吐、显存峰值,以及包含排队与空闲时间在内的真实利用率。
特别提醒,TP=2 时卡数翻倍并不等于吞吐翻倍,因为张量并行的通信开销主要压在逐 Token 的解码阶段。因此,折算必须以整机每小时产出为准。在动手算账前,建议先在目标卡型上跑一轮真实负载。如果需要灵活切换卡型进行对照测试,可以借助 NexGPU 的按量计费与多 GPU 型号选择功能,快速完成这轮基准测试,避免在没有实测数据前锁定长期资源。
按负载分流:继续租 A100 还是换大显存卡
不同场景对显存的需求截然不同。以下是基于典型负载的分流建议,帮助您在 A100 与更大显存卡型之间做出抉择。
| 典型负载场景 | 推荐方案 | 核心判据 |
|---|---|---|
| 32B及以下模型的中低并发在线服务 | 继续租 A100 (单卡或多卡) | 权重未被迫跨卡切分,KV Cache 余量充足 |
| 70B FP16 长上下文高并发 | 换 H200 或 多卡 A100/H100 | 单卡装不下,跨卡通信成为主要瓶颈 |
| 671B级MoE的4-bit私有化推理 | 8卡 A100 或 4卡 H200 | 4-bit量化后权重落入单机承载区间 |
| 离线批处理为主的短上下文任务 | 继续租 A100 | 对首Token延迟不敏感,吞吐量优先 |
| 低优先级吞吐换成本任务 | 继续租 A100 | 允许较高延迟,追求最低单位成本 |
对于希望深入理解 DeepSeek-R1私有化部署GPU配置 的用户,当发现解码阶段的跨卡通信已成为主要瓶颈,或者 KV Cache 余量严重限制并发上限时,就是考虑从 A100 升级到 H200 等大显存卡型的信号。此外,Qwen2.5-72B多卡量化部署教程 也提供了类似的拓扑参考。
常见问题
a100 80gb跑70b推理够不够
单张 A100 80GB 不够。Llama 3 70B 的 FP16 权重约 140GB,超出单卡容量,必须使用 TP=2 拆分到两张卡上运行。虽然双卡能解决容量问题,但会引入跨卡通信延迟,影响解码速度。
a100 80g能跑671b量化模型吗
单卡无法容纳,半机(4卡)也不足。DeepSeek-R1 经 4-bit 量化后权重约 335~400GB,通常建议使用 8 张 A100 80GB 组合。卡数下限不能用权重除以单卡容量直接取整,必须为 KV Cache 与常驻开销留余量。
高并发场景下a100和h100租用差价值不值
两卡同为 80GB,70B FP16 都要 TP=2,容量线上并不解决问题。带宽与算力差异因缺乏可核对的公开规格不下结论,建议用本文的每百万 Token 折算口径在两种卡上各跑一轮实测后自行判定。
按量租a100怎么折算每百万token成本
公式为:(卡数 × 单卡时租 ÷ 实测每小时输出 Token 数) × 100 万。关键在于分母必须是真实负载下的整机每小时输出量,而非理论峰值。需记录显存峰值、并发数及 prefill/decode 分离吞吐。
长上下文场景下a100什么时候该换成h200
当业务出现两个信号时:一是 70B FP16 模型因 TP=2 导致解码延迟过高,二是长上下文或高并发场景下 KV Cache 频繁溢出。此时 H200 的 141GB 大容量可消除跨卡通信,提升有效利用率。
建议在做卡型决策前,先按文中口径跑一轮真实负载,把显存峰值、整机每小时输出 Token 数和真实利用率记下来;需要在同一套负载上对比不同卡型时,可用 NexGPU 的按量资源做一次短时对照,再决定是否升级。



评论(0)