 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
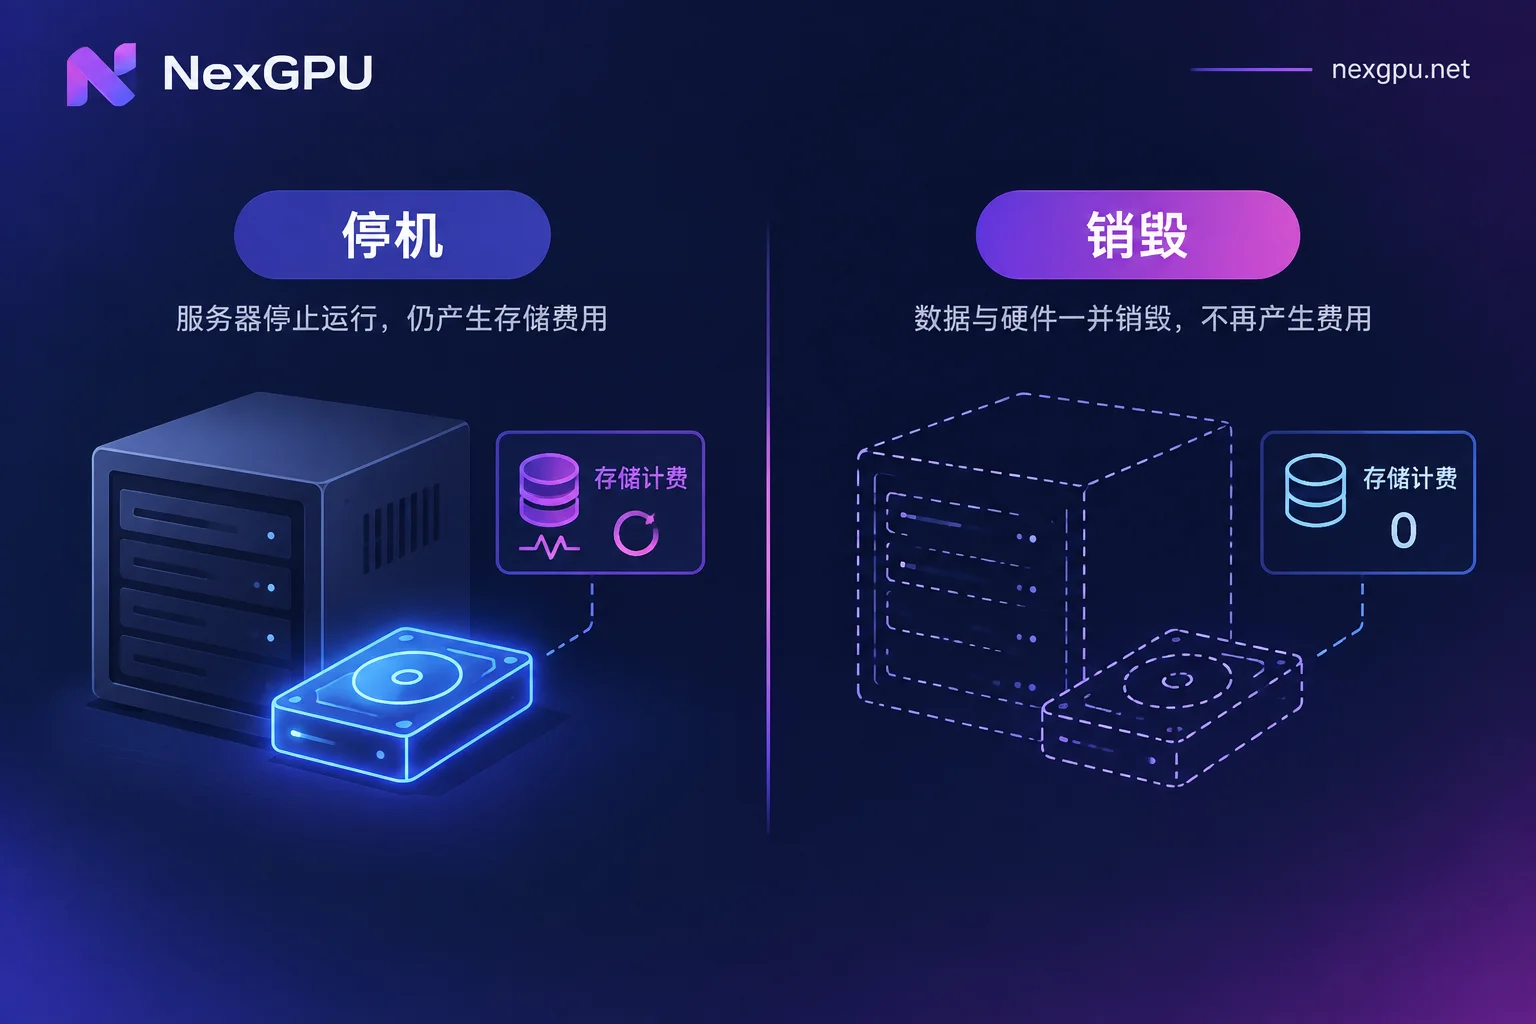
先把结论放前面:租来的 GPU 实例上,你的模型、数据集和生成结果默认只活在这台实例的磁盘里。停机(Stop)保留磁盘但不保留算力,文件、环境、装了半天的依赖都还在,代价是存储费继续按容量计收;销毁(Destroy)才是全停,算力、存储、流量三项一起停止,同时磁盘被彻底清空,找不回来。
所以「保存数据」真正要做的只有一件事:在销毁之前,把需要长期留着的东西搬到实例外面。搬完再销毁,账单才归零。
先决定这台实例还要不要继续用
这个判断决定了你该走停机还是销毁:
- 今天调完明天接着调,环境和依赖不想重装一遍 —— 停机。文件都在,下次开机直接继续,但停机期间存储费照收。
- 任务跑完了,或者接下来几天不会碰 —— 把成果搬走,然后销毁。这是任务结束后的默认做法。
- 拿不准 —— 先搬数据,再决定停机还是销毁。搬走是可逆的,销毁不可逆。
还有一个容易忽略的因素:在 NexGPU 上,下单时的单价会锁定到销毁为止。如果你租到的是一台单价合适的机器,销毁后重开要按当时的价格重新下单。长期占用的实例要不要销毁,可以把这点和存储费一起算进去;计费口径的细节在计费与规则说明页。
文件该放在哪个目录
很多人丢数据不是因为忘了备份,而是从一开始就写错了位置。
在容器化或虚拟化的 GPU 实例里,/tmp 以及未做持久化的容器临时层,可能在重启、重建或镜像更新后被清掉。关键输出不要放这两类路径,要写到分配给你的数据盘挂载点或主工作目录下。
开跑之前先做一次对照,把这些路径显式指到数据盘:
- 训练脚本的
output_dir/logging_dir/ checkpoint 保存目录 - ComfyUI 的
output和models目录、Stable Diffusion 的输出路径 - Hugging Face 缓存(
HF_HOME或HF_HUB_CACHE),权重动辄几十 GB,放错地方既占临时层又可能重下 - 数据集解压后的落地目录
具体挂载点和数据盘容量以控制台实际显示为准,不同机型和镜像可能不一样。选镜像时顺手确认工作目录约定,可以省掉后面很多事,参考云 GPU 镜像模板怎么选。
三条把数据搬出实例的路线
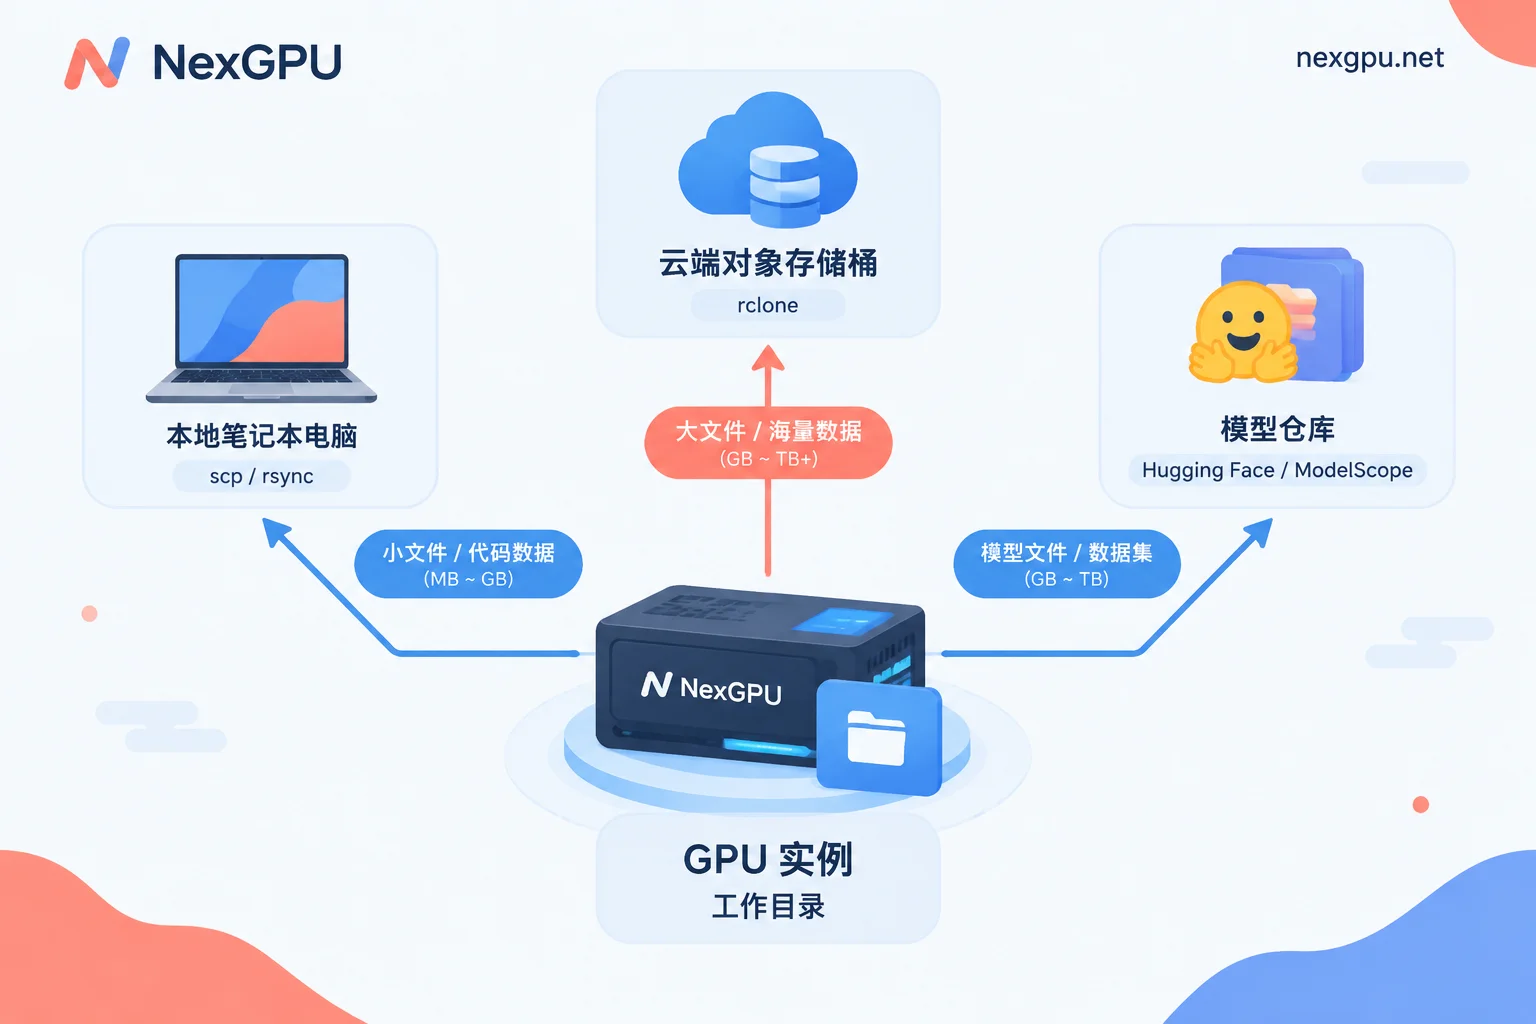
路线一:直接拉回本地(几百 MB 到几 GB 的成果)
适合出图、短视频、日志、代码、小体量的微调权重。
用标准 SSH 通道走 scp 或 rsync 就够了:
# 单个目录整体拉回
scp -P <端口> -r root@<实例地址>:/workspace/outputs ./outputs

# 大文件或断点续传用 rsync,中断后重跑会接着传
rsync -avP -e "ssh -p <端口>" root@<实例地址>:/workspace/outputs/ ./outputs/
rsync -P 的续传能力在网络不稳时比 scp 好用得多。如果不想碰命令行,也可以在 Web 控制台的 JupyterLab 或文件管理器里先把目录打包成 tar/zip,再右键下载 —— 但浏览器下载大文件容易中断,几 GB 以上还是建议走 rsync。
SSH 连接、端口和密钥这一层如果还没跑通,先看租的 GPU 怎么用 SSH 连接。
路线二:同步到对象存储(大权重、数据集、长期归档)
模型 checkpoint、几十上百 GB 的数据集,往返本地既慢又占带宽。更省事的做法是在实例里配一个对象存储客户端,把数据同步到 S3 兼容的存储上(AWS S3、Cloudflare R2、Wasabi、自建 MinIO 等都可以)。
rclone 是这里最通用的工具:
# 交互式配置一个 remote,选 S3 及对应的 provider
rclone config

# 首次上传:只增不删,最安全
rclone copy /workspace/outputs myremote:my-bucket/exp-01 -P

# 后续增量:sync 会让目标端与源端一致,注意它会删除目标端多出来的文件
rclone sync /workspace/checkpoints myremote:my-bucket/ckpt -P
copy 和 sync 的区别值得记一下:sync 是单向对齐,源端删掉的文件目标端也会被删。首次上传和不确定的时候用 copy,确认目录结构稳定之后再用 sync 做增量。
这条路线的好处是数据和实例的生命周期彻底解耦:机器销毁、换卡、换区域都不影响存档,下次开新实例用一条 rclone copy 就能把权重和数据集拉回来,不必为了保住文件而让一台闲置实例长期停机吃存储费。
路线三:推到模型仓库(微调完的权重)
如果产出是一份要复用或要发布的模型权重,直接推到模型社区托管比自己管文件省事:
# Hugging Face,私有仓库加 --private
huggingface-cli login
huggingface-cli upload <用户名>/<仓库名> ./output_model --repo-type model
ModelScope 也提供对应的 SDK 上传方式。私有仓库同样可用,适合团队内部共享权重,不占用你的实例存储。
长任务不要等跑完才想起保存
训练跑几十个小时的时候,风险不在销毁,在中途挂掉。合理的做法是让 checkpoint 定期落盘之外,再定期同步到实例外:
# 每 30 分钟把最新 checkpoint 增量推到对象存储
while true; do rclone copy /workspace/checkpoints myremote:my-bucket/ckpt -P; sleep 1800; done
配合 tmux 或 nohup 跑在后台即可。中断恢复和 checkpoint 的参数怎么设,云端 GPU 长任务中断恢复与 Checkpoint 设置里有更完整的写法。
搬数据本身也会产生费用
NexGPU 的账单只有算力、存储、流量三项,数据传输走的是流量那一项,所以搬运方式会直接反映在账单上:
- 停机期间:算力停止计费,存储费按保留的磁盘容量继续计收。长期不用却一直停机,成本会慢慢累积到不划算。
- 销毁之后:三项全部停止,磁盘数据同时清空。
- 传输大文件:会计入流量。所以搬之前值得先在实例里做一轮清理 —— 删掉数据集解压前的原始压缩包、中间产物、无用的早期 checkpoint,再打包传输,而不是把整个盘原样搬走。
另外,不同机型提供的是本地实例盘还是可独立挂载的持久化数据卷,控制台上是否能单独创建和解绑存储卷,以你下单时控制台显示的为准。选卡和选镜像的时候顺便看一眼存储配置,可以在镜像模板页按任务挑好模板再开机。
销毁之前过一遍这五条
- 输出目录里的文件数量和体积,和你预期的对得上吗?(
du -sh看一眼,别只看文件名) - 最终权重 / 出图 / 日志是否都已经落到实例外,并且在目标端确认过?传输命令返回 0 不等于文件完整,抽查一下大小或校验值。
- 自己改过的配置文件、启动脚本、requirements 是否也一起存了?重装环境时这些比权重更容易被漏掉。
- 数据库、向量库这类还在运行的服务,是否已经正常停掉并导出?
- 确认要继续用这台机器的话,走停机而不是销毁 —— 两个按钮的后果完全不同。
这一步做完再点销毁,算力、存储、流量三项才会真正停下来。要是还在挑机型或者准备开下一台,可以先去价格与可租节点页看当前有哪些卡可用。



评论(0)