 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
2026 年的 AI 算力租赁市场正在经历一场明显的结构性迁移。如果说前两年的行业叙事完全被“万卡集群”和“千亿参数基座预训练”主导,那么近期密集披露的行业报告与财报数据则指向了另一个现实:AI 推理与智能体(Agent)应用的算力消耗占比已经正式超过 60%,成为算力需求增长的最大引擎。与此同时,大模型微调、AIGC 视频生成与 3D 渲染等高频应用,正在把算力需求从少数科技巨头扩散到成千上万的中小研发团队与独立创作者手中。
然而,市场供需呈现出了鲜明的“双轨分化”:一方面是头部大厂动辄签下数十亿、周期长达三到五年的重资产长协锁卡合同;另一方面,真正处于应用落地一线的开发者、初创团队和创作者,却常常在传统算力渠道面前遭遇高端卡排队、配额审批繁琐、环境配置耗时以及账单隐性收费等现实痛点。
当行业进入“算账时刻”,中小团队与个人开发者该如何建立一套轻量、敏捷且成本可控的 AI 算力租赁策略?
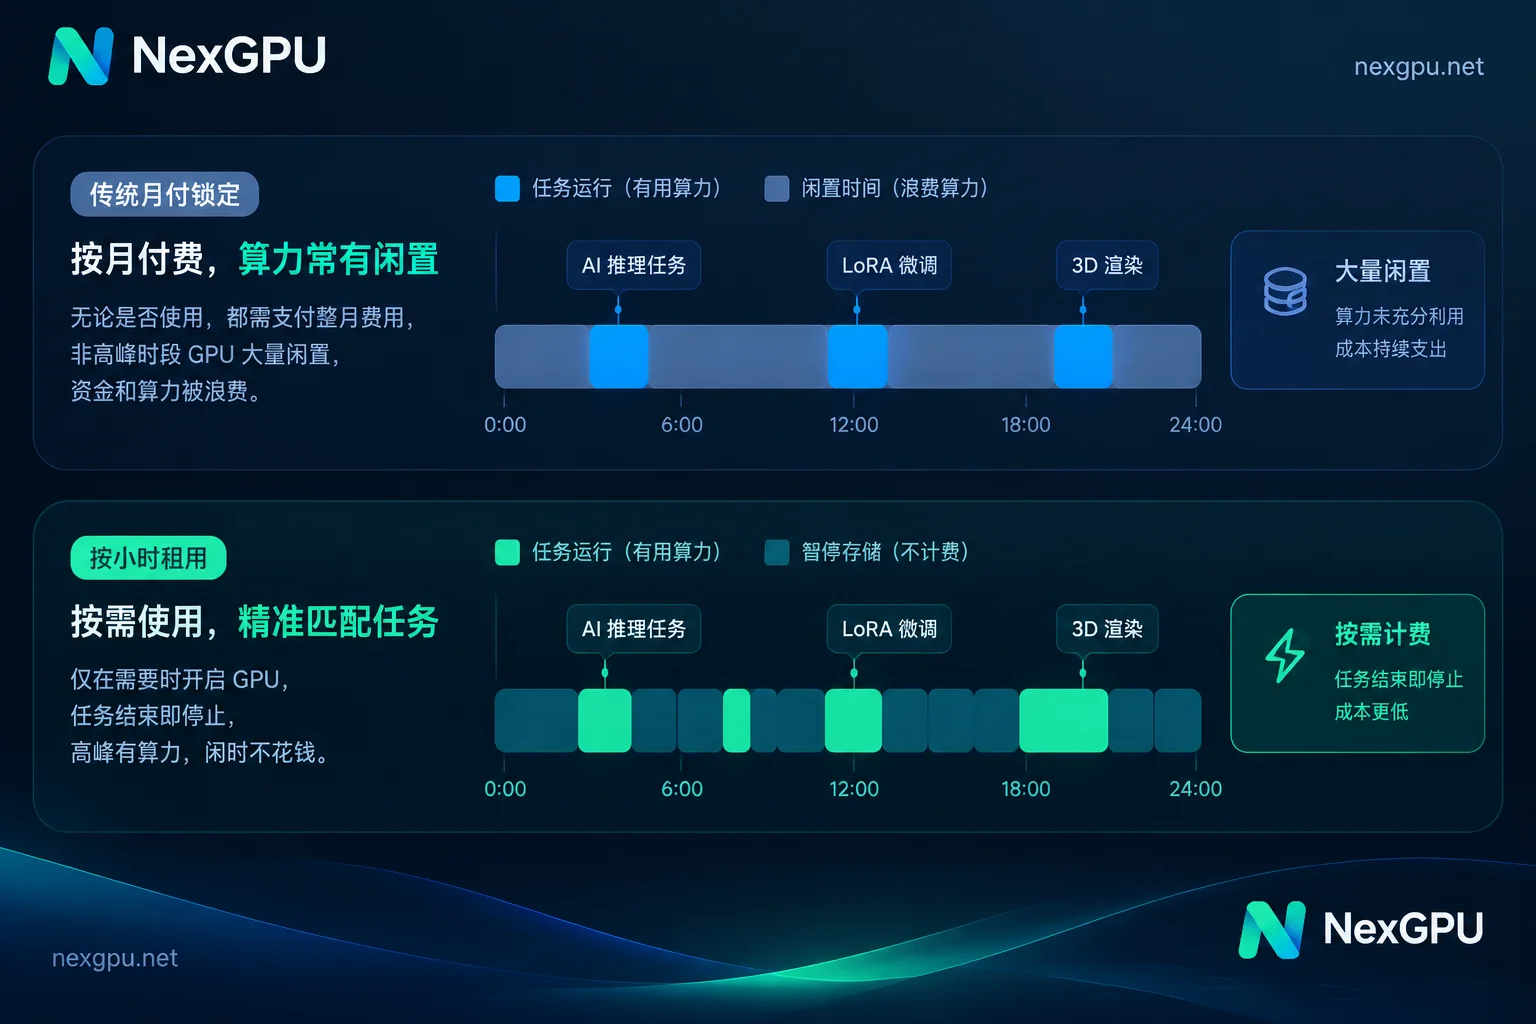
一、 2026 算力需求新常态:为什么“包月死扛”不再划算?
在实际工程落地中,除了极少数 24 小时满负荷运转的成熟期业务,绝大多数团队的算力负载都呈现出强烈的阶段性与波动性:
- 智能体(Agent)与私有化推理验证:业务初期流量存在明显的波峰波谷,或者处于多模型对比测试阶段,全天候包月租用高端卡会造成大量空闲时段的资金浪费。
- 垂直领域大模型微调(LoRA / 全量微调):数据清洗和调参往往呈现“脉冲式”节奏——跑十几个小时的训练,停下来花两天分析评估结果、调整数据集,再开启下一轮训练。
- AIGC 视觉创作与 3D 云渲染:无论是用 ComfyUI 跑视频生成工作流,还是用 Blender 渲染动画序列,本质上都是典型的“短时爆发型”任务,出片即结束。
面对这类非连续负载,如果被绑定在长周期合约或存在高额起租门槛的平台上,闲置成本往往会超过实际计算成本。这也是为什么聚合全球分布式 GPU 供给、支持按小时灵活计费的算力市场,正成为越来越多技术团队的日常底座。
二、 开发者在 AI 算力租赁中最常踩的三个“隐性坑”
在调研众多从传统云或小型撮合平台迁移过来的用户时,我们发现导致算力预算超支的核心原因通常不是显卡标价本身,而是以下三个环节的损耗:
- 选卡盲目与硬件信息不透明:只看显卡型号名称,忽略了显存容量是否匹配量化后的模型权重,或者不清楚机器的实际网络带宽与磁盘单价,开机后才发现拉取上百 GB 的模型权重慢如蜗牛,或者显存直接 OOM(内存溢出)。
- 环境搭建吃掉大量计费时间:租下空白机器后,花两三个小时处理驱动冲突、CUDA 版本兼容、编译依赖包。机器在空转,算力费却在照常扣除。
- 账单结构复杂与关机计费陷阱:部分平台表面卡时单价极低,但实际结算时叠加了开通费、端口映射费、镜像授权费或最低消费门槛;或者在实例停机保存数据期间,依然按全额算力标准收费。
要避开这些坑,关键在于将“选卡、配环境、管生命周期”三个动作标准化。关于不同平台计费规则的横向对比,也可以参考我们此前的分析《主流云厂商GPU算力价格怎么比:每小时单价之外,还要算存储、流量和起租门槛》。
三、 按场景做硬件分层:从消费级旗舰到数据中心级多卡
在 NexGPU 算力市场中,每一行展示的都是一台真实可租的物理机器,且消费级显卡与数据中心级显卡分开列价,方便团队根据任务边界做精准匹配:
1. 消费级显卡(RTX 3090 / 4090 / 5090 等):高性价比的创作与轻量微调主力
对于初次租卡跑图像与视频生成的创作者、做 7B~14B 模型 QLoRA 微调的开发者,以及需要多台实例分段并行跑 Blender / V-Ray 渲染的设计师来说(渲染方案详见《GPU云渲染怎么选方案和显卡》),消费级旗舰卡拥有极高的单卡性价比。
在筛选机器时,你可以直接按显存、价格、地区、可靠性、带宽和最少卡数进行过滤。如果你不确定某个开源模型到底需要多大显存,可以先查阅 模型选卡指南——无论是 Qwen 等文本大模型,还是各类多模态视觉、语音合成与视频生成模型,页面上都逐一写清了当前版本、量化后的显存门槛以及推荐卡型。此外,在 NexGPU 上如果采取“先选环境再筛机器”的流程,显存不够的机器会被直接标出并注明原因,从源头避免开错卡。
2. 数据中心级显卡与多卡节点(A100 / H100 / H200 / B200 等):大模型推理与分布式训练底座
当任务进入大参数模型全量微调(配合 DeepSpeed、FSDP、Megatron)、高并发长上下文推理或复杂 AI Agents 协同部署时,显存容量与卡间互联带宽成为决定性指标。(关于微调选卡的具体计算,可参考《大模型微调GPU怎么选:按显存账、微调方法与开源框架三步定卡》)。
在 NexGPU 市场中,多卡节点采用整机出租模式(下单金额 = 单卡价 × 卡数),支持按最少卡数直接筛选并自助下单。如果研发团队或企业算力采购需要评估更大规模的训练任务,企业方案还支持可选配的 RDMA 高速互联、数据隔离、私有网络与专属算力集群,并提供预留实例、包月包年、合同签署、对公付款与开票以及 PO 采购服务。
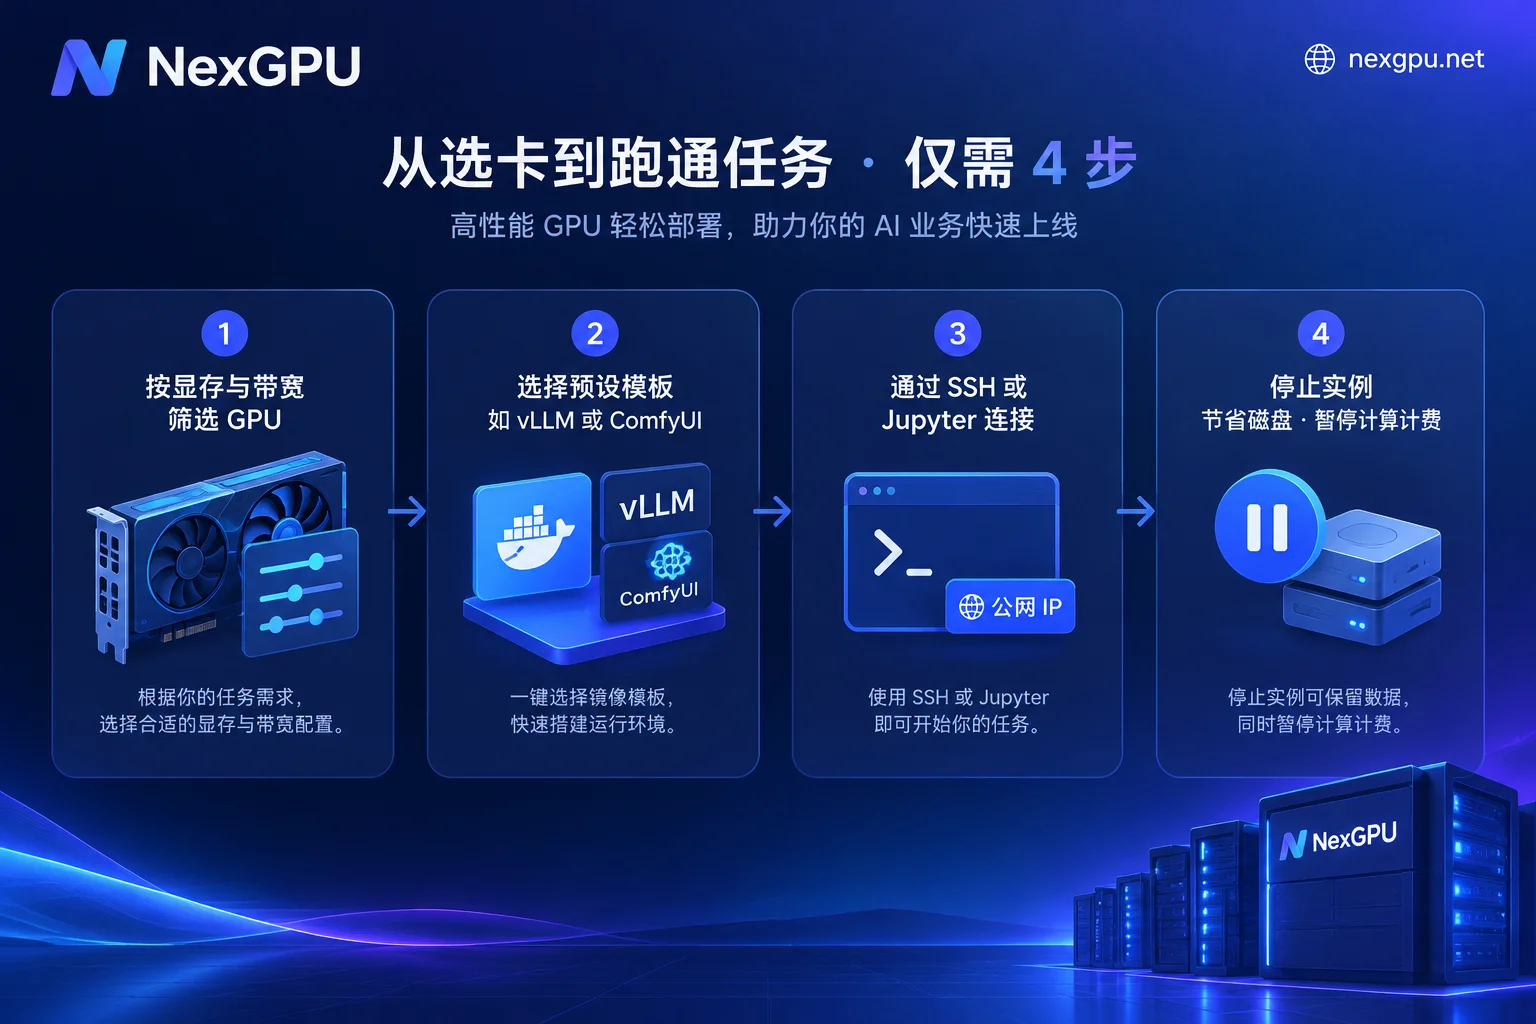
四、 缩短“开机到产出”的距离:预置镜像与直连开发
算力租赁的效率,很大程度上取决于从“点击租用”到“跑通第一行代码或第一个工作流”耗时多久。
为了省去繁琐的底层配置,NexGPU 提供了不分档次、开机即用的 预置镜像模板,底层驱动、CUDA、核心框架与依赖均已预装妥当:
- 大模型推理部署:涵盖 vLLM、TGI、Ollama、SGLang,服务拉起后直接提供 OpenAI 兼容接口,方便快速接入业务后端或 Agent 框架。
- 训练与微调:预置 PyTorch、TensorFlow、JAX 以及 LLaMA Factory、Axolotl、Unsloth 等高频微调工具链。
- AIGC 图像、视频与语音:内置 ComfyUI、AUTOMATIC1111(支持 SDXL、FLUX 及主流视频扩散模型),以及 Whisper、faster-whisper、WhisperX 等语音处理环境。
- 自定义 Docker 镜像:当团队的工程代码严格锁定特定 CUDA 版本或私有依赖时,支持直接填入公开或私有仓库的 Docker 镜像,并自定义启动命令与环境变量。
在连接与日常运维层面(实操细节可阅读《GPU云服务器怎么搭日常开发环境:从选镜像、SSH直连到停机保盘的实操指南》),每台实例均为独占容器,自带公网 IP、端口映射以及一组留给自定义服务的备用端口。开发者既可以使用浏览器内的网页 root 终端、一键免输令牌打开 Jupyter,也可以通过公网 IP 加端口进行 SSH 直连(不经跳板机,可设默认公钥)。如果不习惯纯命令行操作,还可以一键安装 aaPanel 可视化管理面板,在浏览器里直观管理文件、进程与计划任务。
想快速估算整个项目周期的硬件与环境搭配,也可以直接对照 场景做法页,查看 AI 微调、大模型私有化部署、批量数据处理等 11 类场景下的显存需求、镜像选择与大致花费。
五、 算清每一分钱:如何用好“停机保盘”与透明账单?
在成本控制上,清晰的计费颗粒度是防止预算失控的底线。
在 NexGPU 的 计费体系中,没有最低消费、开通费、端口费、镜像授权费,也没有起租时长限制,且下单时的单价会一直锁定到该实例销毁为止,不受后续市场价格波动影响。实例详情页的账单严格只分三项列出:
- 算力费:按秒计量、按小时计价。只有当实例进入“运行中”状态才开始计费,一旦执行停机或销毁操作,算力费立即停止。
- 存储费:按 GB/月计费,从实例创建时起算(包含拉取镜像期间)。
- 流量费:按实际使用的 GB 计费。
这种拆分方式为间歇性开发提供了一个极佳的省钱机制——停机保盘。当你跑完一轮微调需要下班休息,或者等待前端团队联调接口时,只需将实例“停机”。停机状态下,磁盘和里面的模型权重、环境数据完好保留,下次随时可以再次启动,而期间完全不产生算力费,仅需支付极低的按月折算存储费。直到项目彻底结束,输入实例编号确认“销毁”后,磁盘立即释放,所有计费随之终止(注意:平台不读取也不备份磁盘内容,销毁前请务必自行迁出重要产出数据)。
此外,针对预付费模式下最怕的“半夜欠费删库”问题,系统在余额偏低时会先发送预警邮件;若余额耗尽,实例会先自动停机(不销毁),只要在负余额超过设定时长之前中途充值,就能无缝恢复任务。
结语:让算力回归即用即取的工具属性
无论是应对 2026 年爆发的 Agent 推理浪潮,还是在垂直赛道打磨自己的微调模型与视觉作品,算力都不应该成为拖慢研发节奏的包袱。通过省去实名认证与配额申请环节(仅需邮箱即可注册查看实时价格,支持支付宝与 USDT 充值),NexGPU 致力于让每一次开卡、调试与释放都足够简单透明。
如果你正准备启动新的模型实验或渲染任务,不妨先前往 选卡文档 或实时算力市场看一看,按需开启你的第一台 GPU 实例。


