 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
在 AI 应用开发、模型微调与三维内容生成中,按需租用 GPU云服务器 已经成为替代本地重资产工作站的常规手段。但在实际操作中,很多开发者并不是被显存或算力卡住,而是把大量计费时长耗费在了“写代码和跑任务之前”——装驱动遇到内核冲突、拉取几十 GB 权重时断连、本地 IDE 经过多层跳板机转发端口频频掉线,或者下班忘了关机导致显卡空转一整夜。
如果你已经了解如何根据任务评估显存(可参考站内关于大模型微调GPU怎么选与AI视频生成GPU怎么选的指南),接下来的核心问题就是:怎么把一台按小时计费的 GPU云服务器,配置成顺手、稳定且不花冤枉钱的日常开发环境?
本文将围绕开机前的环境与磁盘规划、开发中的连接与端口调试,以及下机时的停机保盘策略,梳理一套可直接落地的云端开发工作流。
一、开机前:用对镜像与磁盘规划,省掉配环境的时间
在传统的云主机上,拿到一台裸机往往意味着要先花一两个小时安装 NVIDIA 驱动、配置 CUDA 工具包并对齐 PyTorch 版本。在按小时计费的 GPU云服务器上,这段排错时间同样在消耗算力费。
1. 按开发阶段选择环境交付方式
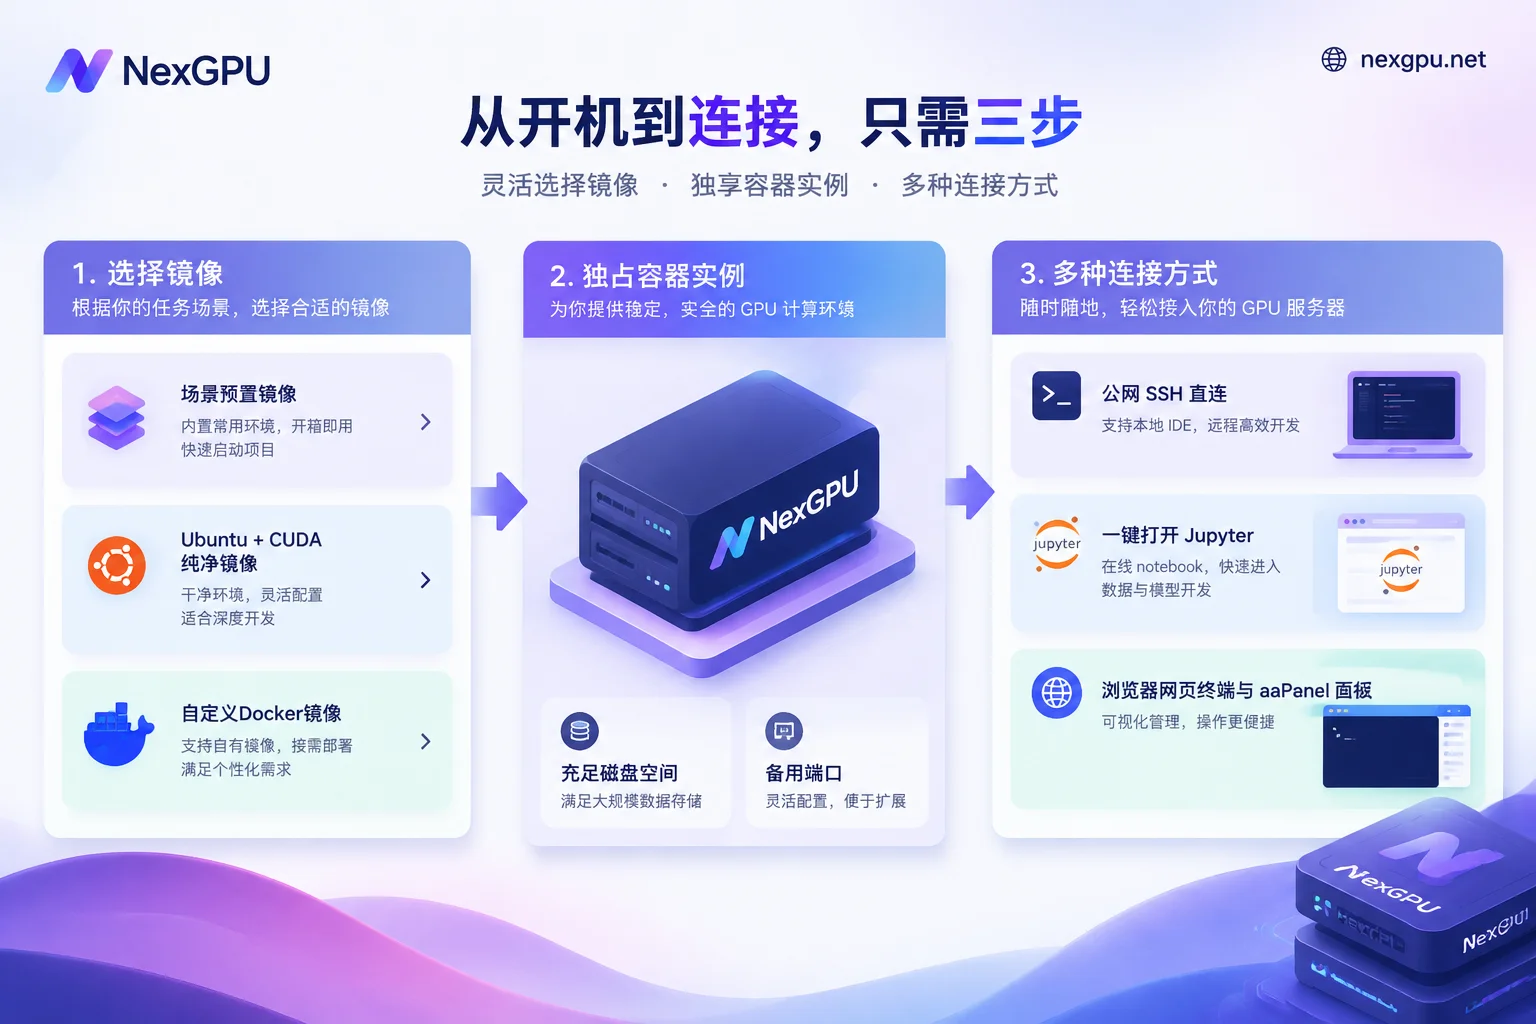
在 NexGPU 镜像模板 中,系统环境已经预装好驱动、CUDA 及对应领域的框架依赖,开机即可进入工作状态。根据日常开发习惯,通常有三种起手方式:
- 直接用场景预置镜像:如果你是跑标准工作流,直接选对应分类最高效。例如做大模型服务化可直接选 vLLM、TGI、Ollama 或 SGLang(拉起后直接提供 OpenAI 兼容接口);做微调可选 LLaMA Factory、Axolotl 或 Unsloth;跑视觉工作流直接选 ComfyUI 或 AUTOMATIC1111;做音频转写可选 Whisper、faster-whisper 或 WhisperX。
- 纯净 Ubuntu + CUDA 镜像:适合习惯用 Conda 或
uv自己在虚拟环境里洁净管理依赖的算法工程师,省去了底层驱动安装的步骤,又不会与预装的 Python 包发生冲突。 - 填入自定义 Docker 镜像:当项目代码严格锁定了特定的 CUDA 小版本或底层系统库时,官网建议直接使用你自己的 Docker 镜像(支持公开或私有仓库)。在创建实例时填入镜像地址,并自定义启动命令与环境变量,能保证多台机器或多个开发周期之间的环境绝对一致。
选机防踩坑提示:在 GPU 市场 挑选机器时,建议“先选环境再筛机器”。系统会自动校验该环境或模型对硬件的要求,显存不够的机器会被直接标出并注明原因,避免开机后才发现跑不起来。如果你对具体开源模型的硬件要求拿不准,也可以先查阅 模型选卡指南,里面逐一列出了主流模型当前版本与量化后的显存门槛及完整起服务步骤。
2. 创建实例前必须一次定好的两件事
由于独占容器实例的底层机制限制,有两项配置在实例创建后无法修改,必须在下单前规划好:
- 磁盘空间一次给够:实例创建后不支持在线扩容磁盘。计算所需空间时,除了代码和数据集,务必把模型权重(尤其是未量化的 safetensors 文件)、Checkpoint 保存目录以及 Docker 镜像解压空间算进去。GPU 市场每一行机器都会分开标出算力单价和磁盘单价,方便提前核算。
- 网络带宽按机器挑:实例创建后不能单独修改带宽上限,带宽完全由所选的物理机器决定。如果日常工作流涉及频繁从 Hugging Face 拉取大模型权重,或向云端上传大体积视频素材,筛选机器时应优先按“带宽”和“地区”指标过滤。
二、开发中:三种连接方式与备用端口调试
环境拉起后,连接体验直接决定了 GPU云服务器能不能当成主力开发机来用。不同的开发任务适合不同的接入路径,你可以根据连接实例文档按需组合:
1. SSH 直连:主力代码编写与远程 IDE 接入
NexGPU 的每台实例都分配了公网 IP 加端口,支持 SSH 直连,不经过跳板机。你可以在账户里设置默认公钥,实例开机后直接用本地的 VS Code Remote-SSH、Cursor 或 JetBrains Gateway 连上去写代码。
- 优势:没有跳板机中转带来的输入延迟和断连问题,
scp/rsync传文件、跑 Git 同步与本地操作几乎无异。
2. Jupyter 一键打开:交互式实验与数据处理
如果所选镜像模板带有 Jupyter(如数据处理类的 RAPIDS/Jupyter 镜像,或训练微调类镜像),无需在终端里复制带长串 Token 的链接并手动做本地端口转发。在实例控制台点击即可一键在浏览器打开 Jupyter 界面,访问令牌已经自动带好,适合快速验证算法逻辑、画图或做探索性数据分析。
3. 网页终端与可视化面板:轻量运维与文件管理
- 网页终端:浏览器内直接提供的 root 终端。在外出没有配置好 SSH 客户端的电脑上,或者仅需临时上去跑一条
nvidia-smi看一眼显存状态时非常方便。 - 可视化管理面板(aaPanel):如果不习惯纯命令行管理大批量素材(比如做 ComfyUI 抽卡或 Blender 渲染的创作者),可以在实例中一键安装 aaPanel,在浏览器里通过图形界面管理文件、查看进程和设置计划任务(注意安装面板会占用一部分磁盘空间)。
4. 用好“备用端口”调试自定义服务
在开发 AI Agent、大模型私有化 API 或 Gradio/Streamlit 演示界面时,往往需要把服务暴露出来供本地或前端联调。由于实例创建后不支持手动增删端口映射,平台在为每台实例配置默认服务端口映射的同时,专门预留了一组备用端口。
你只需要在启动自己的 Web 服务或推理接口(如 vLLM 的 API Server)时,将监听地址绑定到 0.0.0.0,并将端口号指定为详情页分配的备用端口,即可直接通过公网 IP 加对应端口访问该服务。
三、日常管机器:把“停机保盘”融入开发节奏
很多初次使用 GPU云服务器的开发者容易把账单跑高,核心原因在于混淆了“停机”与“销毁”的计费边界(成本结构的横向对比可参考主流云厂商GPU算力价格怎么比)。
在 NexGPU 的计费规则中,账单只有算力、存储、流量三项,并在实例管理详情页实时分项列出,没有任何开通费、端口费或最低消费门槛。
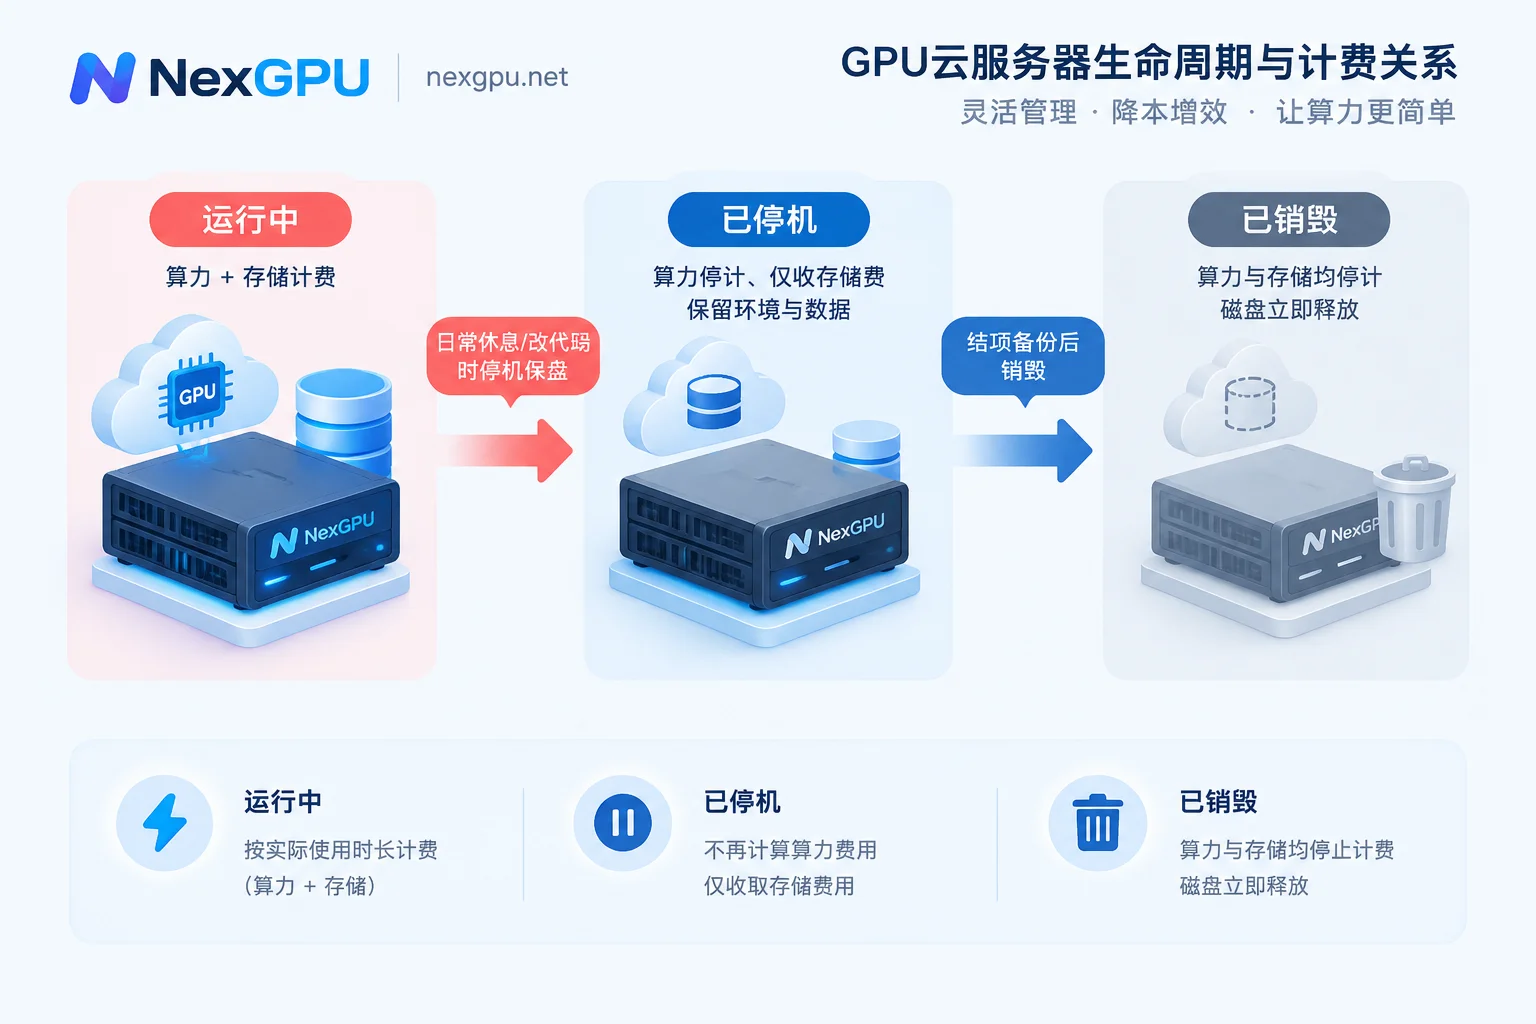
理解以下三条规则,就能把云端显卡的成本压到最低:
| 实例状态 | 算力费(按秒计量/按小时计价) | 存储费(按 GB/月计) | 数据与环境状态 | 适用场景 |
|---|---|---|---|---|
| 运行中 | 正常计费(单价锁定至销毁) | 正常计费 | 正常运行 | 正在写代码、跑训练、出图或提供推理服务 |
| 已停机 | 立即停止计费 | 继续按量计费 | 完整保留磁盘与数据,随时可再次启动 | 晚上休息、周末停工、本地改代码或整理数据集期间 |
| 已销毁 | 立即停止计费 | 立即停止计费 | 磁盘立即释放,不可恢复 | 项目彻底结项,或重要权重/产物已下载备份完毕 |
1. 间歇式开发:善用“停机”省下空转算力费
日常研发很少是 24 小时满负荷跑卡的。当你白天调通了训练脚本、晚上准备休息,或者需要先在本地花半天时间清洗数据时,直接在控制台将实例停机。
- 停机瞬间,占大头的 GPU 算力费立刻停止计算;
- 你花心思配好的 Conda 环境、下载好的几十 GB 模型权重都完好保存在磁盘里,期间只需支付极低的按月折算存储费(注意:拉取镜像创建实例期间存储费即开始计算);
- 第二天开工时重新启动实例,环境和数据都在,无需从头再拉一遍镜像。
2. 结项与换卡:先同步数据,再确认“销毁”
因为平台采用独占容器架构,不读取也不备份用户的磁盘内容。当你决定彻底结束一个实验,或者从小显存卡(如 RTX 4090)切换到大显存卡(如 A100/H200)时:
- 务必先通过 SSH/
rsync或对象存储工具,将微调好的 LoRA 权重、日志和配置文件导出; - 在控制台执行销毁操作(系统会要求输入实例编号二次确认,防止误触),此时磁盘立即释放,存储计费也随之彻底终止。
3. 预付费防中断机制
对于跑长周期训练或无人值守任务的开发者,最怕余额突然耗尽导致数据丢失。平台采用预付费机制(支持支付宝与 USDT-TRC20 充值):
- 当账户余额偏低时,系统会先发送预警邮件;
- 如果余额彻底耗尽,实例会先自动停机(不会直接销毁),保护磁盘里的 Checkpoint 不丢失;
- 只有当负余额状态超过设定时长后才会触发自动销毁,在这之前只要中途充值即可恢复启动。
四、从单卡开发到多卡扩展:无缝衔接的进阶路径
当你在单张消费级显卡(如 RTX 3090、4090、5090)上把代码逻辑和工作流跑通后,往往会遇到需要扩大规模的时刻:
- 横向并行加速:由于平台对同时开启的实例数量没有限制(仅受账户余额约束),也没有繁琐的实名认证和配额审批流程(邮箱注册即可直接查看实时价格并开机),做 3D 渲染(Blender、V-Ray)或批量数据处理的创作者,可以直接同时拉起多台实例进行分段并行处理,把几天的任务压缩到几小时内跑完。
- 纵向多卡节点扩展:如果单卡显存见顶,需要跑 DeepSpeed、FSDP 或 Megatron 分布式训练与大并发推理,可以直接在 GPU 市场 按“最少卡数”筛选 A100、H100、H200、B200 等数据中心级多卡节点。多卡节点采用整机出租模式(下单金额 = 单卡价 × 卡数),自助下单即可获得完整的节点算力。
如果你不确定当前手头的业务(如 AI Agents、音频转文字、GPU 编程或远程虚拟计算)具体该配多大显存、用哪个镜像最划算,可以先浏览 NexGPU 场景做法页 获取参考配置;如果是研发团队需要评估带 RDMA 高速互联、私有网络隔离的专属算力集群,或有包月包年、合同对公付款与开票需求,也可直接通过 联系销售 获取定制方案。


