 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
2026 年下半年,算力租赁市场出现了一个让不少人意外的信号:CoreWeave 等大型云厂商将 NVIDIA A100 的租赁合同期一路延长到了 2029 年,直接打破了早年市场盛传的“AI 芯片两年过时论”。与此同时,随着全行业算力重心向推理过半时代演进,A100 的租赁行情不仅没有崩盘,反而在中高端微调与高并发推理市场站稳了脚跟。
当顶尖大厂在争抢 H200、B200 去训练下一代超大规模基座模型时,绝大多数研发团队、独立开发者和高校课题组发现:对于 7B 到 70B 参数规模的开源模型微调、长上下文推理以及多模态生成任务,A100 依然是目前软件生态最成熟、单位显存带宽性价比最高的“甜点级”数据中心显卡。
不过,打开算力市场准备租用 A100 时,很多团队还是会踩坑:40GB 和 80GB 到底差在哪?单卡推理选 PCIe 还是 SXM?包月租用算力利用率不到 40% 怎么破?本文将从硬件细分规格、场景对号入座到按需租用控本,梳理一套完整的 A100 租用实战指南。
一、 为什么 2026 年 A100 租用依然是研发团队的“性价比主力”?
在消费级显卡(如 RTX 4090、RTX 5090)和新一代旗舰(如 H100、H200)之间,A100 卡在一个非常精准的生态位上:
- 80GB HBM2e 显存与 2TB/s 带宽的硬门槛:消费级显卡虽然单卡 FP16 算力不俗,但 24GB/32GB 的显存容量和 GDDR 显存带宽,在面对 32B/70B 模型或高并发 KV Cache 时极易触发显存溢出(OOM)或带宽瓶颈。A100 80GB 提供约 2,039 GB/s 的 HBM2e 显存带宽,在访存密集型的大模型解码(Decode)阶段依然游刃有余。
- 零踩坑的软件与算子成熟度:从 PyTorch、DeepSpeed、Megatron 到 vLLM、SGLang、LLaMA Factory,几乎所有主流开源框架和底层 CUDA 算子都是在 Ampere 架构上打磨最久的。复现论文或上线生产服务时,A100 极少遇到奇葩的算子兼容报错。
- 避开盲目追新的溢价:如果你的任务并不重度依赖 Hopper/Blackwell 架构专属的原生 FP8 特性,而是以 BF16/FP16 微调或 INT4/INT8 量化推理为主,租用 A100 往往能以明显低于新旗舰的单价,拿到同等容量的 80GB 高速显存。
二、 核心选型:40GB 还是 80GB?PCIe 还是 SXM?
在市场上搜索“A100租用”时,你会看到 40GB / 80GB 两种容量,以及 PCIe / SXM4 两种物理形态。很多人在选卡时只看“A100”三个字,结果要么买贵了浪费预算,要么卡间通信成了瓶颈。
1. 40GB vs 80GB:不只是显存容量翻倍
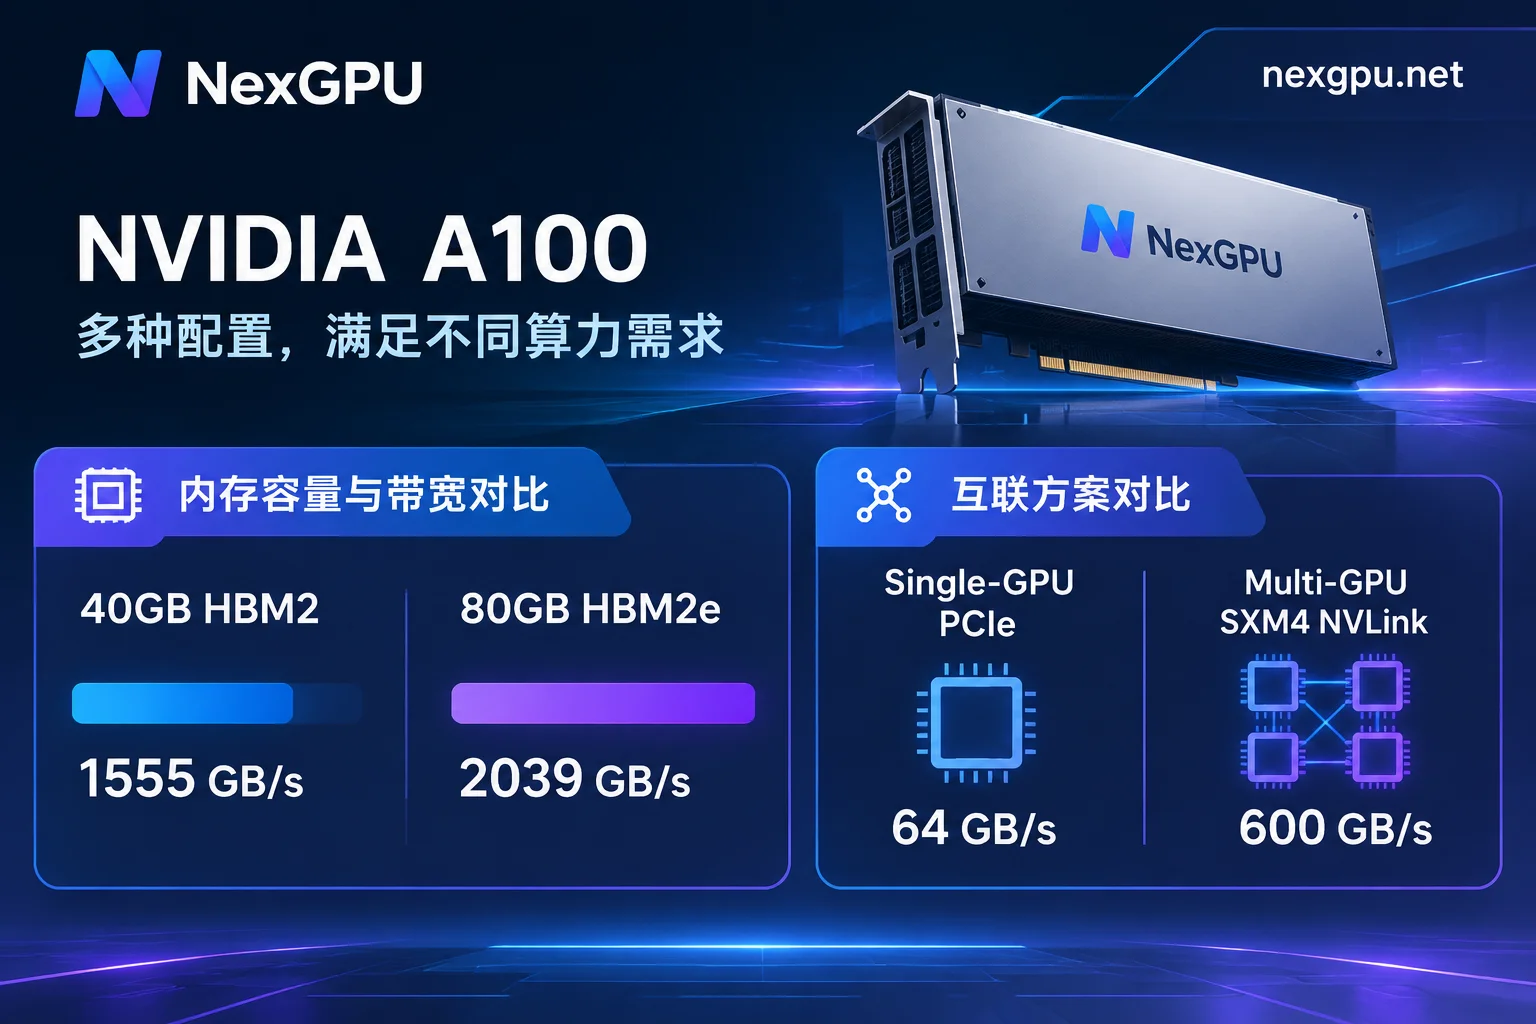
很多人以为 A100 80GB 只是在 40GB 的基础上多焊了一半显存,实际上两者的核心计算单元(6912 个 CUDA 核心,432 个第三代 Tensor Core,FP16/BF16 峰值算力 312 TFLOPS)完全一致,但显存代际与带宽存在明显差异:
| 对比维度 | NVIDIA A100 40GB | NVIDIA A100 80GB | 选型实战影响 |
|---|---|---|---|
| 显存类型 | HBM2 | HBM2e | 80GB 颗粒频率更高,能效与吞吐更强 |
| 显存带宽 | 约 1,555 GB/s | 约 1,935 GB/s (PCIe) / 2,039 GB/s (SXM) | 带宽高出约 25%~31%,直接决定推理 Token 生成速度与大 Batch 训练吞吐 |
| 单卡微调边界 | 适合 7B~13B 模型 LoRA / 轻量微调 | 可单卡压入 70B 模型 QLoRA 微调或 30B 级模型训练 | 80GB 能大幅减少跨卡切分带来的通信开销 |
| 推理并发余量 | 跑 70B INT4(权重约占 35GB~40GB)几乎无 KV Cache 余量 | 跑 70B INT4 仍剩约 40GB 显存留给长上下文与高并发 | 生产级高并发或长文本推理必选 80GB(可参考 A100 80GB 跑推理是否浪费的判断方法) |
2. PCIe vs SXM4:看你是“单兵作战”还是“多卡协同”
- 单卡任务选 PCIe 形态更划算:在单卡场景下,A100 80GB PCIe(功耗上限 300W)与 SXM4(功耗上限 400W)共享同一颗 GA100 核心,峰值算力相同,显存带宽仅相差约 5%。如果你只是租单张卡跑推理、跑单卡 LoRA 微调或数据并行任务,PCIe 版本的性价比极高。
- 多卡大模型训练/张量并行必看互联:当任务需要 4 卡或 8 卡紧密协同(例如使用 DeepSpeed、FSDP、Megatron 做多卡全参数微调,或跨卡跑超大模型张量并行推理)时,PCIe Gen4 的 64 GB/s 带宽很容易成为通信墙,而 SXM4 通过 NVLink 与 NVSwitch 可实现高达 600 GB/s 的全互联带宽。
三、 四大典型场景:你的任务该怎么租 A100?
为了避免“小马拉大车”导致任务中断,或者“大炮打蚊子”浪费预算,可以按以下四个高频场景对号入座(如果不确定具体开源模型的显存占用,可以直接查阅 NexGPU 的模型选卡指南,里面逐一列出了各主流模型当前版本与量化后的显存门槛):
中大型开源模型生产级推理(如 Qwen 32B/72B、DeepSeek 系列)
- 推荐配置:单卡或双卡 A100 80GB。
- 镜像搭配:直接使用预置的 vLLM、SGLang 或 TGI 镜像模板,开机拉起即提供标准的 OpenAI 兼容接口。
大模型微调(SFT / LoRA / QLoRA / DPO)
- 推荐配置:7B~14B 模型快速验证可选单卡 A100 40GB/80GB;32B~70B 模型微调或多卡全量微调,建议在市场中按最少卡数筛选 2×、4× 或 8× A100 80GB 整机节点。
- 镜像搭配:选择预装好 LLaMA Factory、Axolotl、Unsloth 或 PyTorch 的微调镜像,免去手动编译 CUDA 和 FlashAttention 的繁琐过程。
AI 视频生成与全精度多模态出片
- 推荐配置:单卡 A100 80GB。相比 24GB 消费级显卡在跑视频扩散模型或 FLUX 全精度加 ControlNet 时频繁卸载权重到内存,80GB 显存可以把完整管线常驻显存(详见 AI视频生成GPU选卡指南)。
- 镜像搭配:选用预置的 ComfyUI 或 AUTOMATIC1111 镜像。
科学计算、语音批量转写与数据处理
- 推荐配置:根据数据集规模选择 A100 40GB 或 80GB。
- 镜像搭配:可使用预置的 RAPIDS、Jupyter、Whisper / WhisperX 镜像,或者当项目代码严格锁定特定 CUDA 版本时,直接填入自己的公开/私有仓库 Docker 镜像并自定义启动命令。
关于各垂直领域的显存需求、推荐卡型与大致开销,也可以直接参考 NexGPU 场景做法页。
四、 破局“包月闲置浪费”:如何在 NexGPU 高效租用 A100?
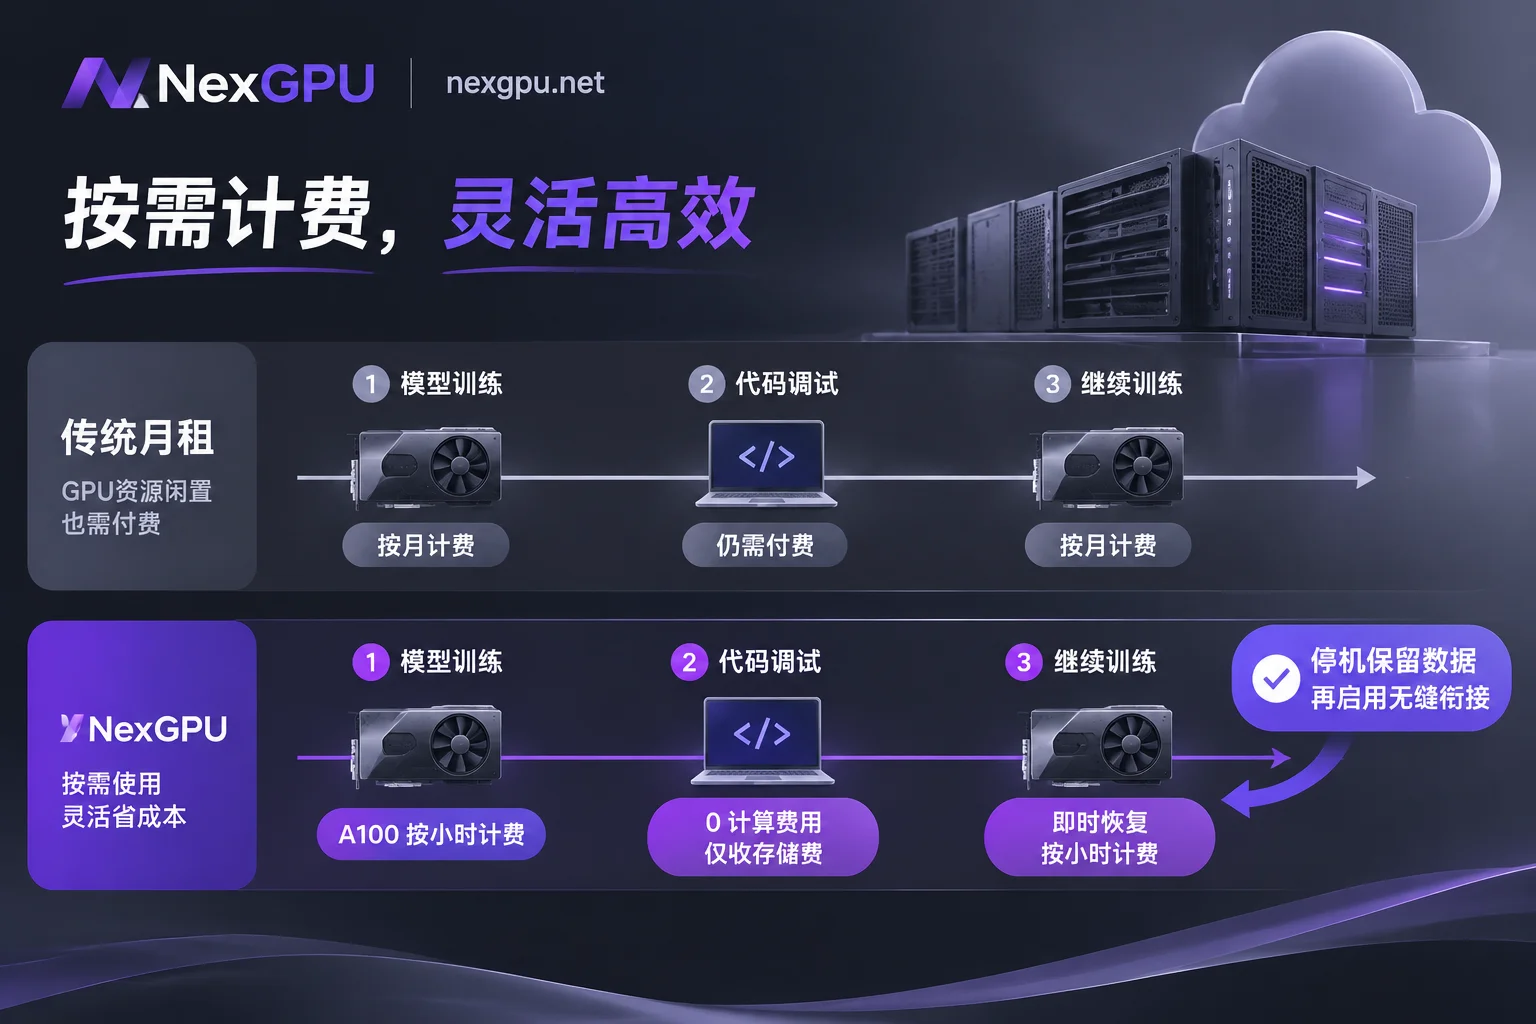
行业调研数据显示,许多中小 AI 团队采用传统固定包月模式租用 A100 时,由于数据清洗、代码调试和夜间空转,实际的 GPU 算力利用率往往只有 30%~45%,将近一半的租金白白蒸发。
在 NexGPU(nexgpu.net) 算力市场,通过透明的选卡机制与按需计费规则,可以把每一分预算都花在刀刃上:
1. 真实机器逐行比价,环境与显存智能防呆
进入 GPU 市场后,数据中心级显卡(A100、H100、H200、B200 等)与消费级显卡分开列价,每一行代表一台真实可租的物理机器。你可以直接按显存大小、价格、地区、可靠性、带宽、最少卡数进行筛选,每台机器的算力单价与磁盘单价分开标明(实时单价与可租节点以官网显示为准)。
更实用的是,如果你先选好镜像或模型环境再筛机器,系统会自动把显存不够的机器标出并注明原因,从源头避免开错卡导致 OOM(选卡细节可参阅如何选择 GPU 文档)。如果需要多卡分布式训练,多卡节点支持按最少卡数筛选并整机自助下单(下单金额 = 单卡价 × 卡数)。
2. 秒级计量、单价锁定与“停机保盘”省钱法
NexGPU 的计费规则极其干净:账单只有算力、存储、流量三项,在实例详情页分项实时列出,没有任何开通费、端口费、镜像授权费,也没有最低消费和起租时长限制。
- 下单锁价:下单时的算力单价会一直锁定到该实例销毁,不受市场价格波动影响。
- 算力按秒计量、按小时计价:实例进入“运行中”才开始计算力费,一旦停机或销毁,算力计费立即停止。
- 善用“停机保盘”砍掉空转成本:存储费按 GB/月计算(从创建拉取镜像起算,停机后照收,销毁才停)。这意味着,当你跑完一轮 A100 微调需要花半天时间分析 Loss 曲线、调整数据集或修改代码时,只需在控制台点击“停机”。此时昂贵的 A100 算力费直接归零,而你挂载的百 GB 模型权重和环境数据完好保留在磁盘里,下次需要使用时再启动即可(连接与日常管理操作详见实例连接与实例管理文档)。
⚠️ 运维防坑提醒:平台提供的是独占容器,不读取也不备份用户的磁盘内容,且实例创建后不支持动态扩容磁盘或增删端口映射。因此,在创建 A100 实例时请一次性分配充足的磁盘空间;在确认点击“销毁”(需输入实例编号确认)前,务必通过 SSH 直连、Jupyter 或选装的 aaPanel 可视化面板将重要权重与日志传出,因为销毁会立即释放磁盘且不可恢复。


