 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
先给直接结论:进入 2026 年底,除非你的团队每天连续满载跑 12 小时以上、且模型规模长期锁定在 32B QLoRA 以内,否则做大模型微调时,按小时租用云端大模型微调GPU在回本周期、显存上限和工程试错效率上都远胜自购显卡。
之所以得出这个判断,背后有三个在 2026 年下半年变得尤为尖锐的现实变量:
- 自购消费卡溢价过高:受 GDDR7 显存紧缺与芯片分配向工作站卡倾斜影响,2026 年 11 月美日欧主流零售渠道的 RTX 5090 现货价格仍普遍落在 6,300~6,999 美元(约合人民币 4.2 万~4.9 万元),是官方建议零售价的 3 倍以上。
- 微调天生是「脉冲式负载」:实际业务微调中,约 70%~80% 的时间花在数据清洗、格式校验、提示词重构和评测脚本上,真正需要 GPU 满载做反向传播的时段往往只是集中冲刺的几小时到几天。
- 24GB/32GB 单卡显存墙提前到来:从早期的 7B Dense 模型切换到如今主流的 32B 模型、长上下文 Agent 轨迹微调以及 Qwen3-30B-A3B 这类 MoE 架构后,单张消费级显卡很容易在第一步就撞上显存与通信上限。
下面我们把买卡与租卡的账目、2026 年底最新卡型边界,以及一套能直接压低单次微调费用的云端工作流一次讲透。
一、为什么2026年底自购显卡做微调更难回本?先算清脉冲式利用率账
很多团队估算“买卡还是租卡”时,习惯拿一张卡的硬件价格直接除以云端月租,得出“用半年就回本”的结论。但这个算法默认了一个在微调场景里几乎不存在的前提——GPU 7×24 小时满载运行。
我们拿 2026 年 11 月的真实市场行情做一次对齐:
- 自购本地微调主机:单张 RTX 5090(32GB)整卡当前市场成交价普遍在 4.2 万~4.9 万元左右,加上大功率电源、主板、大容量内存与散热系统,一套稳定跑训练的单卡工作站落地预算通常超过 5.5 万元;如果是双卡 RTX 4090(合计 48GB 显存)配 Threadripper 平台与 2000W 电源的工作站,海外整机组装成本也在 4,000~6,000 美元区间(约合人民币 2.8 万~4.3 万元)。
- 按小时租用云 GPU 参考水位:2026 年公开算力市场上,RTX 4090(24GB)按需时租大约在 0.34~0.69 美元/卡时(国内主流报价约 1.98~2.89 元/卡时),RTX 5090(32GB)国内参考时租约 3.25 元/卡时,A100 80GB 约 11.4 元/卡时,H100 约 22.5 元/卡时,H200 约 35 元/卡时(不同服务商与节点配置差异较大,具体需以平台实时报价为准)。
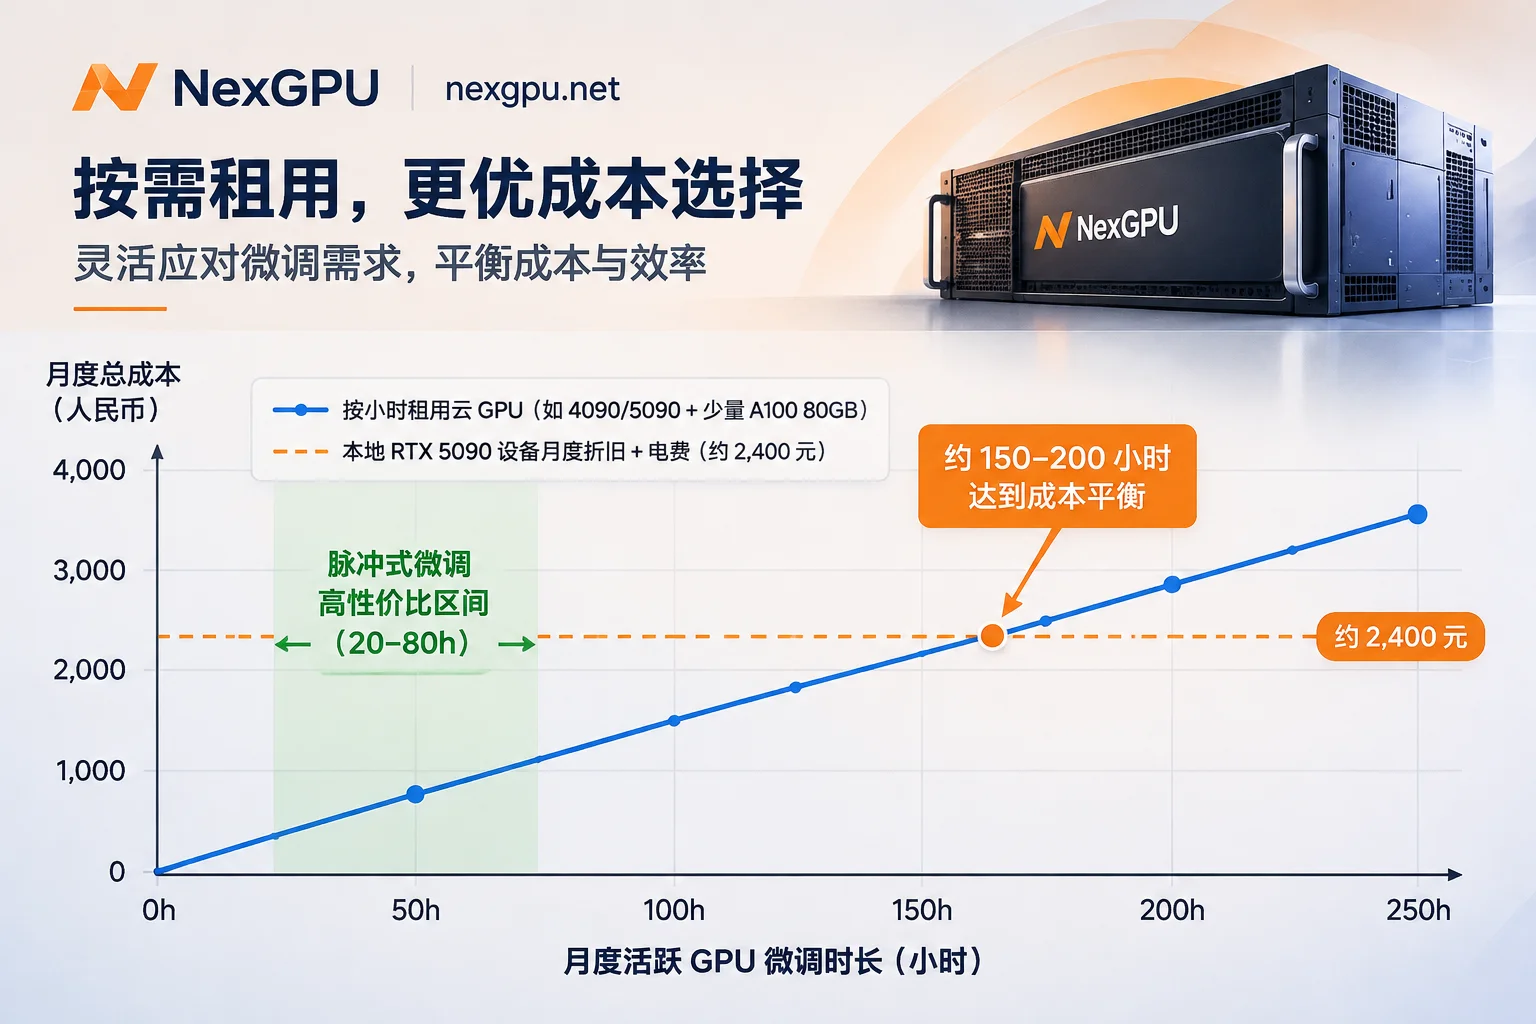
如果按 24 个月硬件折旧(不算显存降价与风扇/电源维护,只算硬件摊销与满载电费),一台 5.5 万元的单卡 RTX 5090 工作站每月的固定沉没成本就超过 2,300~2,500 元。假设你的业务每月只集中微调 3~4 轮,每轮真实训练耗时 15 小时(每月有效训练约 50~60 小时):
- 自购显卡:哪怕显卡有 90% 的夜晚都在空转,每月固定成本依然是 2,400 元上下,折合每次有效训练小时的隐性成本高达 40 元以上。
- 按需租用云端 GPU:同样 50~60 小时有效训练,在单卡消费级与按需 A100 之间切换使用,月度算力支出往往只有两百到几百元;只有当每月有效训练时间稳定突破 150~200 小时以上,且完全不需要更大显存时,本地自购才开始进入回本区间。
如果你更想了解通用 AI 服务器在自购托管与长期租用之间的临界点测算,可以参考站内另一篇成本拆解:《AI服务器自购托管还是租GPU?先测利用率,再算隐性成本》。
二、买一张消费卡还不够:2026年微调的三大隐性门槛
比“闲置回本慢”更棘手的是显存天花板锁死。2026 年的开源模型微调不再只是“7B 跑个 QLoRA 完事”,自购单卡一旦买定,遇到以下三类需求会直接停摆:
1. MoE 模型(如 Qwen3-30B-A3B)的“伪小模型”显存陷阱
很多开发者看到 MoE 模型每 Token 只激活 3B 参数,就误以为一张 24GB 消费卡能轻松微调。但在工程落地中,微调需要把所有专家的权重和路由结构都载入显存:
- 以 Qwen3-30B-A3B 为例,当前主流社区(如 BitsandBytes)对 MoE 架构的 4-bit QLoRA 支持并不完善,通常需要回退到 BF16 LoRA 或全量微调;即便开启了 Unsloth 专门优化的 MoE Triton 融合内核,16-bit LoRA 微调依然需要约 63GB 显存。
- 此外,在传统 Transformers 框架下,MoE 的上万个专家线性层在挂载 LoRA 后会产生数万个可训练子模块,一旦用多张消费级显卡强行跑分布式训练,极易因为梯度同步图过于复杂而出现 GPU 占用率 100% 但吞吐归零、甚至 NCCL 通信卡死的问题。
2. 长上下文 Agent 与多轮轨迹微调的激活值爆炸
在做工具调用、结构化长文档解析或 GRPO 后训练时,序列截断长度(Cutoff Length)动辄拉到 8K、16K 甚至 32K。前向传播保留的激活值会随序列长度和 Batch Size 呈倍数膨胀。在 24GB 显存上,你可能被迫把 micro-batch 压到 1 并开启重度梯度检查点(Gradient Checkpointing),训练时间拉长数倍;而换到 80GB 的 A100/H100 上,大 Batch 配合 FlashAttention 可以直接把吞吐打满。
3. 多张消费卡拼机器,PCIe 带宽会吃掉一大半加速比
RTX 4090 和 RTX 5090 均不支持 NVLink,多卡之间只能通过主板 PCIe 总线通信——PCIe Gen4 x16 单向带宽上限仅约 31.5 GB/s(Gen5 约 63 GB/s),而 Hopper 架构的 NVLink 4 单卡双向/直连带宽可达 450 GB/s 量级,Blackwell NVLink 5 更是达到 900 GB/s。做多卡全参数微调或 DeepSpeed ZeRO-3 时,PCIe 互联的跨卡梯度同步延迟会导致算力严重空转。关于 4090 多卡与 A100 单卡的具体判定,可延伸阅读《RTX 4090多卡与A100单卡训练选型怎么定?4步判定》。
三、2026年底大模型微调GPU按需配卡速查表
与其把预算一次性锁死在一块消费级显卡上,不如按自己当前跑的模型规模、精度策略与微调方法,在云端按需选卡。下面这张速查表可以直接作为租卡前的基线参考(具体显存占用会随序列长度、LoRA Rank 与优化器有所浮动):
| 模型规模与架构 | 常用微调方式 | 预估显存需求 | 推荐 GPU 配置 | 实战选型要点 |
|---|---|---|---|---|
| 7B~14B Dense | QLoRA(4-bit) | 12GB~24GB | 单卡 RTX 3090 / 4090(24GB) | 性价比最高,适合快速验证数据集和 SFT 流程 |
| 7B~14B Dense | BF16 LoRA(长序列) | 28GB~45GB | 单卡 RTX 5090(32GB)或 48GB 专业卡 / A100 40GB | 32GB GDDR7 可覆盖多数 14B 常规序列 LoRA,余量更从容 |
| 32B Dense | QLoRA(4-bit) | 24GB~32GB | 单卡 RTX 5090(32GB)或 48GB 专业卡 | 4090 24GB 跑 32B 长上下文偏紧,5090 32GB 是甜点台阶 |
| 32B Dense | BF16 LoRA / 14B 全参 | 70GB~140GB | 单卡 A100 80GB / H100 80GB 或 2×80GB | 对量化损失敏感的推理/代码模型建议上 80GB 级别卡 |
| 30B~35B MoE | BF16 LoRA(Unsloth) | 60GB~80GB+ | 单卡 A100 80GB / H100 80GB / H200 141GB | 优先单卡大显存配融合 MoE 内核,避免消费卡多卡 PCIe 卡死 |
| 70B Dense | QLoRA / BF16 LoRA | 48GB~180GB | 单卡 A100 80GB(QLoRA)或 2~3×80GB(BF16 LoRA) | H200(141GB)单卡即可免切分跑高余量 70B LoRA 微调 |
| 70B Dense | 全参数微调 / GRPO | 600GB+ | 8×A100 80GB / 8×H100 / 8×H200(NVLink 整机) | 必须看卡间高速互联与整机内存配比,避免通信成为瓶颈 |
如果你想自己从底层推导四笔显存账(权重、梯度、优化器状态、激活值),或者对比 Unsloth、LLaMA Factory 与 Axolotl 三个框架对同一张卡显存的压缩差异,建议配合阅读:《大模型微调GPU怎么选:按显存账、微调方法与开源框架三步定卡》 以及 《2026大模型微调GPU与框架选型实战:Unsloth、LLaMA Factory与Axolotl怎么配卡最省钱?》。
四、三段式云端微调工作流:在 NexGPU 上把每次微调账单压到最低
租云端 GPU 最怕的不是单价高,而是“用昂贵的 H100 去改 Python 路径报错,或者训完模型忘了关机一直扣费”。利用弹性算力市场按秒计费、无缝换卡的特性,把微调拆成三个阶段执行,通常能省下一半以上的算力账单:
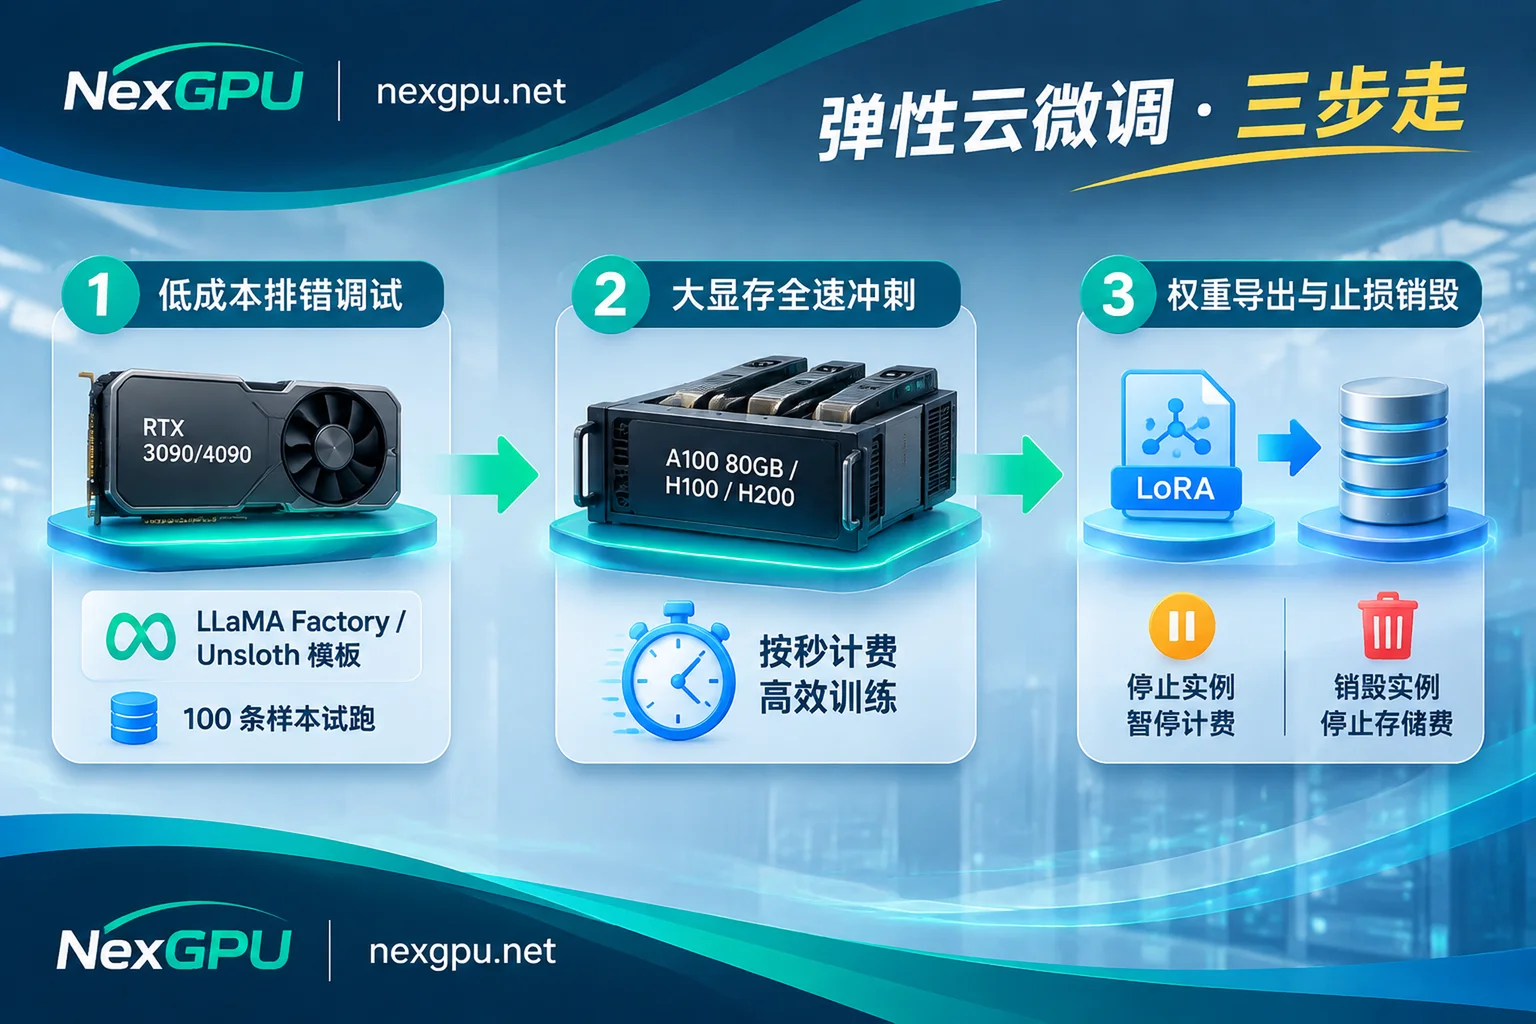
第一阶段:代码与数据排错,租最便宜的消费级单卡(如 RTX 3090 / 4090)
在正式拉满数据量之前,先只抽取 100 条样本验证数据格式、Tokenizer 模板、Loss 收敛曲线以及 Checkpoint 保存路径。
- 在 NexGPU 选机时,可以直接先去 镜像模板页 选好预装好的微调环境(目前涵盖 LLaMA Factory、Axolotl、Unsloth 以及标准 PyTorch、TensorFlow、JAX;如果你的训练代码锁定了特定 CUDA 版本,也可以直接填入自己的公开或私有 Docker 镜像,模板本身不额外收费)。
- 先选环境再筛机器时,NexGPU 会自动标出显存不足的机器并注明原因,省去人工对着参数表猜显存的麻烦。同时可在 AI 微调场景方案 与 模型选卡指南 中核对具体开源模型的量化门槛与步骤。
- 开机后无需繁琐跳板机配置:平台提供浏览器直连的网页 root 终端、带公网 IP 与端口映射的 SSH 直连(支持配置默认公钥),带 Jupyter 的模板还能一键带着令牌打开;需要图形化管理训练日志和文件时,也可以一键安装 aaPanel 面板。
第二阶段:正式训练冲刺,按需切到 RTX 5090 或 A100 / H100 / H200 整机
确认代码 0 报错后,把数据和脚本直接拉到高算力、大显存的正式机器上全速跑完:
- 如果模型适合单卡冲刺(如 32B QLoRA 选 RTX 5090,或 30B MoE / 70B QLoRA 选单卡 A100 80GB / H100 / H200),按台下单即可;如果需要全量微调或大 Batch 强化学习后训练,直接在市场里按“最少卡数”筛选多卡节点整机下单(下单金额 = 单卡价 × 卡数,底层支持 DeepSpeed、FSDP、Megatron)。
- 没有隐形门槛:NexGPU 只需邮箱注册,无需实名认证或配额申请,注册后不绑定支付方式即可查看各国节点的实时价格与可靠性、带宽指标;充值支持支付宝和 USDT(TRC20),没有最低消费、开通费、端口费、镜像授权费,也没有起租时长,下单时的单价会一直锁定到该实例销毁。
第三阶段:分清「停机」与「销毁」,守住账单最后一道防线
云上微调账单超支,十有八九出在训练结束后的清理动作。在 NexGPU 上,账单只由算力、存储、流量三项构成(详情页实时分项列出),其中停机与销毁的计费边界完全不同:
- 停机(Stop):算力费按秒计量、按小时计价,实例一停机算力费立刻归零,同时磁盘和环境完整保留以便后续恢复;但存储费按 GB/月计,停机期间依然照收(从实例创建拉镜像时起算)。关于停机期间的具体算费逻辑,可查看《GPU 实例关机还收不收费?算力停了,存储还在计》。
- 销毁(Destroy):只有输入实例编号确认销毁后,存储费才会停止。需要特别注意:NexGPU 是独占容器架构,平台不读取也不备份用户的磁盘内容,创建后也不支持扩容磁盘或增删端口映射——这意味着销毁会立即释放磁盘且数据不可恢复。
因此,最稳妥的习惯是:长任务训练中务必做好断点保存(参考《云端GPU长任务中断恢复与Checkpoint设置:4步配置》);训练一结束,先把 LoRA Adapter 或合并后的权重拉回本地或传到私有仓库/对象存储,确认校验无误后再立即销毁实例,把存储成本压到极限。
五、什么时候才应该选企业方案或本地采购?
按需租卡能解决 85% 以上的个人开发者、算法外包、高校课题组与创业团队需求,但如果你碰到以下两种情况,就需要换一种配置思路:
- 长期高利用率且模型固定:如果你的团队连续半年以上、每月有效微调时长稳定超过 150~200 小时,或者正在搭建需要长期在线的微调+推理一体化私有管线,按需时租就不如锁定长期资源划算。此时除了自购机器,更省运维精力的做法是转为包月/包年或预留实例。
- 跨机多卡与企业合规要求:当训练进入 70B 全参数微调、多机集群并行阶段,消费级网络和单机容器就不再适用,需要 RDMA 高速互联、数据隔离、私有网络与专属算力池。这类研发团队或算力采购需求可以直接对接 NexGPU 企业与专属方案,走合同、对公付款、开票及 PO 采购流程,同时省去自建机房和硬件折旧风险。
动手开卡前的 4 条自查清单
在打开算力市场下单之前,花 1 分钟过一遍下面这四项,基本就能避免 90% 的显存报错与费用浪费:
- 先定微调方法再看卡:能用 QLoRA / BF16 LoRA 解决的垂直格式与知识注入任务,别轻易上全参数微调;MoE 模型先确认框架是否支持融合内核与 BF16 显存预算。
- 区分调试卡与冲刺卡:先用低价单卡跑通 50 个 Step 验证数据集与脚本,再把大数据集放到 RTX 5090 或 A100/H100/H200 上全速跑完。
- 开卡前定好磁盘容量:因为创建后无法扩容磁盘,下单前把“基础权重体积 + 数据集 + 2~3 个 Checkpoint”的容量余量一次留足。
- 算好导出路径再销毁:提前在终端或 Jupyter 里测试好权重的下载或上传脚本,训完即拷走、拷完即销毁,让每分钱只花在真正跑梯度的秒数上。


