 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
随着2026年AI视频生成技术的飞速迭代,从长视频生成到高保真动作控制,算力已经成为创作者的“生命线”。你是否也曾为了跑通一个最新的视频扩散模型,在显存门槛面前望而却步?
传统的硬件采购不仅资金占用高,更难以应对模型迭代带来的配置需求波动。在NexGPU,我们观察到越来越多的创作者和开发者不再执着于“买卡”,而是转向了更为灵活的「弹性算力」模式。
为什么AI视频生成更需要弹性算力?
AI视频生成模型的显存吞吐量极大,无论是基于ComfyUI的节点工作流,还是针对特定视频风格的LoRA微调,都对显存(VRAM)容量和带宽提出了严苛要求。对于大多数独立创作者而言,日常开发可能只需中端卡,但一旦进入高精度渲染或大规模微调阶段,往往需要昂贵的工业级卡支撑。
NexGPU 提供了一种更聪明的解决路径:
- 真·按需租用,告别浪费: 你无需为不使用的闲置时间买单。在我们的 GPU 市场,每一台机器都按小时/秒精准计费。无论你是想临时测试最新的 视频生成模型,还是进行长期的高负载渲染,都能找到匹配的算力规格。
- 拒绝繁琐配置,开机即用: 视频生成工作流复杂,环境配置往往是“劝退”的第一步。NexGPU 提供预装好 ComfyUI、AUTOMATIC1111 等主流框架的镜像。你只需像点外卖一样选择模板,剩下的驱动、CUDA和依赖配置全部由我们完成。
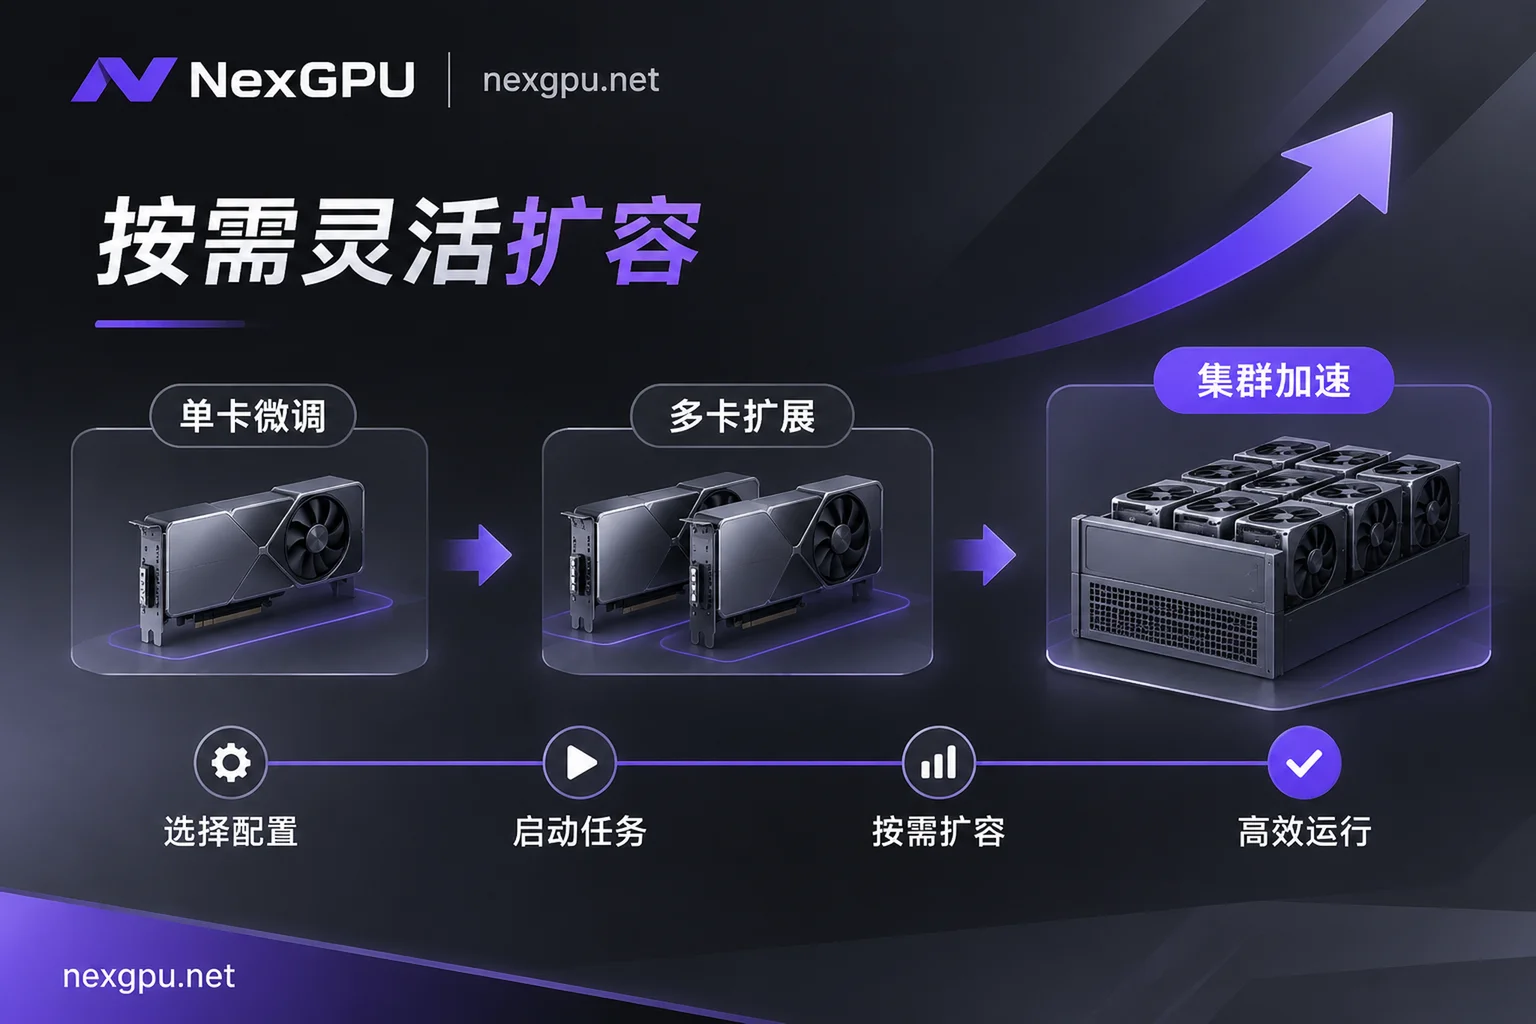
- 从实验到集群的平滑过渡: 无论你是初学者在尝试单卡微调,还是研发团队在进行分布式训练,NexGPU 支持从消费级的 RTX 4090/5090 到数据中心级的 H200/B200 的灵活切换。
如何在NexGPU实现高效创作?
我们不仅仅提供算力,更提供全套的落地解决方案。在我们的 场景做法页,你可以详细了解不同任务的“最佳实践”:
- 明确显存门槛: 别盲目选卡,参考我们的 模型选卡指南,清晰查看各视频扩散模型在不同量化标准下的显存需求。
- 灵活管理实例: 通过 网页终端 或 SSH 直连即可全面掌控机器。如果任务暂停,停机保留磁盘,数据永不丢失,极大节省了存储成本。
- 透明的计费体系: 我们采用 精细化的账单管理,算力、存储、流量分项列出,拒绝隐形消费。
即刻开启你的AI创作之旅
AI视频创作不应被硬件门槛所束缚。在 NexGPU,我们已经为你准备好了从入门到进阶的全套算力基础设施。无需实名认证,注册即可查看实时行情,开启你的弹性算力时代。
想要了解更多配置技巧?查看我们的 快速入门文档,或在官方博客获取更多实战案例。


