2026 Ollama GPU服务器调优与部署实战:从根治“静默CPU回退”到多模型并发显存精算

到 2026 年底,Ollama 早已不再只是开发者在笔记本上尝鲜 7B 小模型的“本地玩具”。随着团队级代码助手(如 OpenCode)、内部 RAG 知识库以及多步骤 AI Agent 工作流的普及,越来越多研发团队选择在云端租用 Ollama GPU服务器,将其作为私有、零 Token 计费、支持 OpenAI 兼容接口的后端推理底座。然而,把 ...

告别显存焦虑:2026年AI视频生成的「弹性算力」自由指南

随着2026年AI视频生成技术的飞速迭代,从长视频生成到高保真动作控制,算力已经成为创作者的“生命线”。你是否也曾为了跑通一个最新的视频扩散模型,在显存门槛面前望而却步?传统的硬件采购不仅资金占用高,更难以应对模型迭代带来的配置需求波动。在NexGPU,我们观察到越来越多的创作者和开发者不再执着于“买卡”,而是转向了更为灵活的「弹性算力」模式。为什么A...

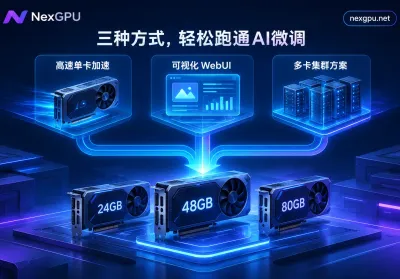
2026大模型微调GPU与框架选型实战:Unsloth、LLaMA Factory与Axolotl怎么配卡最省钱?

在准备租用大模型微调GPU之前,许多开发者的第一反应是直接拿“模型参数量 × 字节数”去套显存公式。但在 2026 年的工程实践中,决定你该租 24GB 消费级显卡还是 8×80GB 数据中心节点的,往往不只是模型本身,而是你选用的微调框架与底层算子实现。如果说我们在《大模型微调GPU怎么选:按显存账、微调方法与开源框架三步定卡》中解决的是基础显存账本...
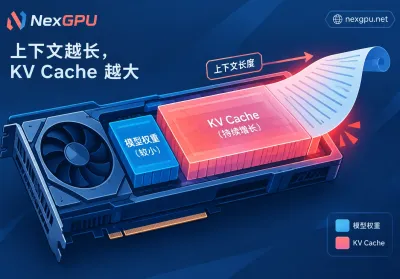
长上下文推理显存不够怎么办?先算 KV Cache,再按代价从低到高调整

长上下文推理报 OOM,多数时候不是模型权重装不下,而是 KV Cache 随上下文长度和并发数一起增长,占满了显存。可以按这个顺序处理:先确认 OOM 出在哪一步,再估算 KV Cache 有多大,然后按改动代价从低到高依次尝试:限制长度和并发、把 KV Cache 量化成 FP8、开启分块 Prefill 和前缀缓存、把 KV Cache 卸载到 ...

ComfyUI 跑 Flux 显存不足怎么办?量化、启动参数与选卡边界

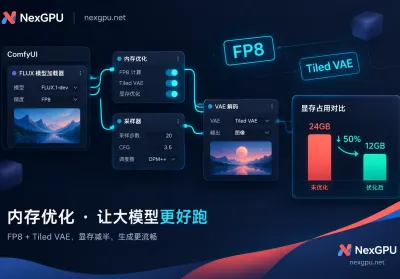
为什么 FLUX.1 在 ComfyUI 里容易爆显存FLUX.1(dev 或 schnell)采用约 120 亿参数的 Diffusion Transformer 架构,全精度(FP16/BF16)权重文件本身就需约 24GB 显存。加载后还要同时运行体积接近 10GB 的 T5-XXL 文本编码器,以及在高分辨率解码阶段调用 VAE,峰值显存需求轻...