2026 年底做 Qwen部署,先记住一个最省事的决策结论:个人单卡测试或本地尝鲜,直接用 Ollama 跑 Qwen3.8-27B(Q4 量化约 16GB~18GB,单张 24GB 显存即可稳定运行);如果要接入团队应用、AI Agent 或对外提供高并发 OpenAI 兼容接口,直接上 vLLM 或 SGLang 部署 Qwen3.8-27B(强编...
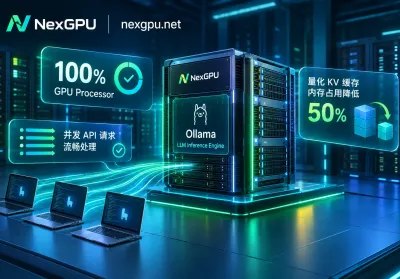
到 2026 年底,Ollama 早已不再只是开发者在笔记本上尝鲜 7B 小模型的“本地玩具”。随着团队级代码助手(如 OpenCode)、内部 RAG 知识库以及多步骤 AI Agent 工作流的普及,越来越多研发团队选择在云端租用 Ollama GPU服务器,将其作为私有、零 Token 计费、支持 OpenAI 兼容接口的后端推理底座。然而,把 ...
在本地通过 Ollama 运行开源大模型,已经成为开发者和 AI 爱好者的“标准操作”。然而,随着模型参数量的提升和对上下文长度要求的增加,显存往往成为了难以逾越的瓶颈。很多人面临的现状是:模型跑不起来,或者为了跑模型而被迫购买昂贵的硬件。与其投入巨大成本购买难以升级的物理机,不如尝试 NexGPU 按小时计费的云端算力方案。通过 NexGPU,你可以...
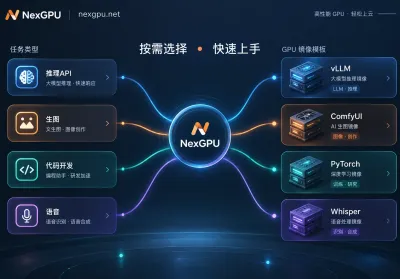
先问自己要跑什么任务租云 GPU 之前,先明确交付目标:是对外提供高并发 API 推理服务,还是自己做创意生图生视频,或是写代码做微调实验,还是批量转写音频?任务性质直接决定镜像模板的类型。生产级大模型推理或高并发 API 服务:直接选 vLLM 或 TGI(Text Generation Inference)镜像。这类镜像预编译好 PagedAtte...
Ollama私有云GPU服务器搭建的完整路径就是 6 步:装 NVIDIA Container Toolkit、用 docker run 跑通 GPU 直通、写 Compose 固化配置、挂持久化卷保存权重、按卡做隔离、开 OpenAI 兼容接口——全程不需要分布式集群。2026 年 8 月的私有化部署实践已经把这条路径规范成了标准动作,单机单卡或多卡...
 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客