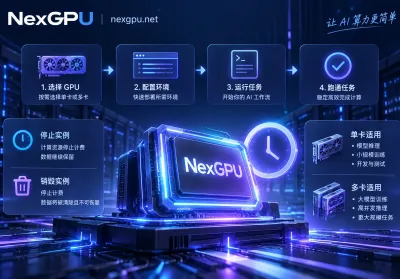
在本地通过 Ollama 运行开源大模型,已经成为开发者和 AI 爱好者的“标准操作”。然而,随着模型参数量的提升和对上下文长度要求的增加,显存往往成为了难以逾越的瓶颈。很多人面临的现状是:模型跑不起来,或者为了跑模型而被迫购买昂贵的硬件。与其投入巨大成本购买难以升级的物理机,不如尝试 NexGPU 按小时计费的云端算力方案。通过 NexGPU,你可以...
 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客