 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
2026 年底做 Qwen部署,先记住一个最省事的决策结论:个人单卡测试或本地尝鲜,直接用 Ollama 跑 Qwen3.8-27B(Q4 量化约 16GB~18GB,单张 24GB 显存即可稳定运行);如果要接入团队应用、AI Agent 或对外提供高并发 OpenAI 兼容接口,直接上 vLLM 或 SGLang 部署 Qwen3.8-27B(强编码、多模态与精准工具调用)或 Qwen3.6-35B-A3B(MoE 架构、高吞吐与低单 Token 成本)。 非超大规模集群不要盲目上 125B+ 的 Qwen3.8-Flash-Next 或万亿级旗舰——不仅显存门槛翻倍,商用授权也与 27B/35B-A3B 不同。
很多人在搜索框敲下「Qwen部署」时,卡住的往往不是某一行命令,而是三件事没对齐:版本号太多不知道选哪个、Ollama/vLLM/SGLang 选错导致后期返工、拉起服务后工具调用或长上下文直接报错。下面按真实落地顺序逐一拆解。
一、版本怎么选?先看 2026 主流 Qwen 模型显存与授权对照
进入 2026 年下半年,开源 Qwen 家族形成了“Dense 稠密模型保精度 + MoE 稀疏模型拼吞吐”的清晰格局。尤其是 Qwen3.6 和 Qwen3.8 系列引入了 Gated DeltaNet 线性注意力与全注意力混合架构,并内置视觉编码器(原生支持图文、视频输入),显存占用和能力边界都和早期的 Qwen2.5 拉开了差距。
| 模型版本 | 架构与模态 | 权重大小(常见档位) | 建议显存门槛 | 开源协议 | 最适合的场景 |
|---|---|---|---|---|---|
| Qwen3-8B | Dense / 纯文本 | Q4 约 5.5GB | 8GB~12GB | Apache 2.0 | 低显存入门、轻量路由、本地快速实验 |
| Qwen3.8-27B | Dense(27.78B)/ 原生多模态 | Q4 约 16GB~17GB FP8 约 31GB BF16 约 52GB~56GB | 24GB(Q4 短上下文) 48GB~80GB(FP8/长文本) | Apache 2.0 | 单卡主力旗舰:复杂编码、AI Agent 工具调用、图文/文档理解 |
| Qwen3.6-35B-A3B | MoE(35B 总参 / 3B 激活)/ 原生多模态 | Q4 约 20GB~22GB FP8 约 36GB+ | 24GB~32GB(Q4) 48GB~80GB(FP8) | Apache 2.0 | 高并发性价比主力:每 Token 激活少、解码速度快、高 QPS 对话服务 |
| Qwen3.8-Flash-Next | MoE(125B 主体+51B N-gram / 6B 激活)/ 多模态 | 最小量化约 135GB+ | 96GB~192GB+(多卡/大显存) | Qwen Community License 1.0 | 企业内网大吞吐;若对外提供 MaaS 或 AI 助手产品需另行取得授权 |
选型时最容易忽略的两个判断点
- 复杂 Agent 优先选 27B Dense,高并发对话优先选 35B-A3B MoE:在需要严格遵循系统提示词、调用外部工具并忠实回传参数的 Agent 场景中,全参数激活的
Qwen3.8-27B往往比稀疏激活的 MoE 更稳,不易出现工具输出被忽略的情况;而如果业务是大量客服问答、文档摘要或需要把并发吞吐拉满,每步只激活约 3B 参数的Qwen3.6-35B-A3B算力开销显著更低。 - 商用项目务必看清许可证:
Qwen3、Qwen3.5、Qwen3.6开源主力以及Qwen3.8-27B均采用宽松的 Apache 2.0 协议,可放心商用和微调;但Qwen3.8-Flash-Next采用Qwen Community License 1.0,如果你用它对外提供模型即服务(MaaS)或“AI 工作助手”类商业产品,按条款需要联系官方单独授权,不能直接等同于 Apache 2.0。
二、框架怎么选?Ollama、vLLM 还是 SGLang
模型定好后,第二个分岔口是推理引擎。分界线不是公司有多大,而是“同一时刻有几个人或几个并发请求同时打向这台机器”。
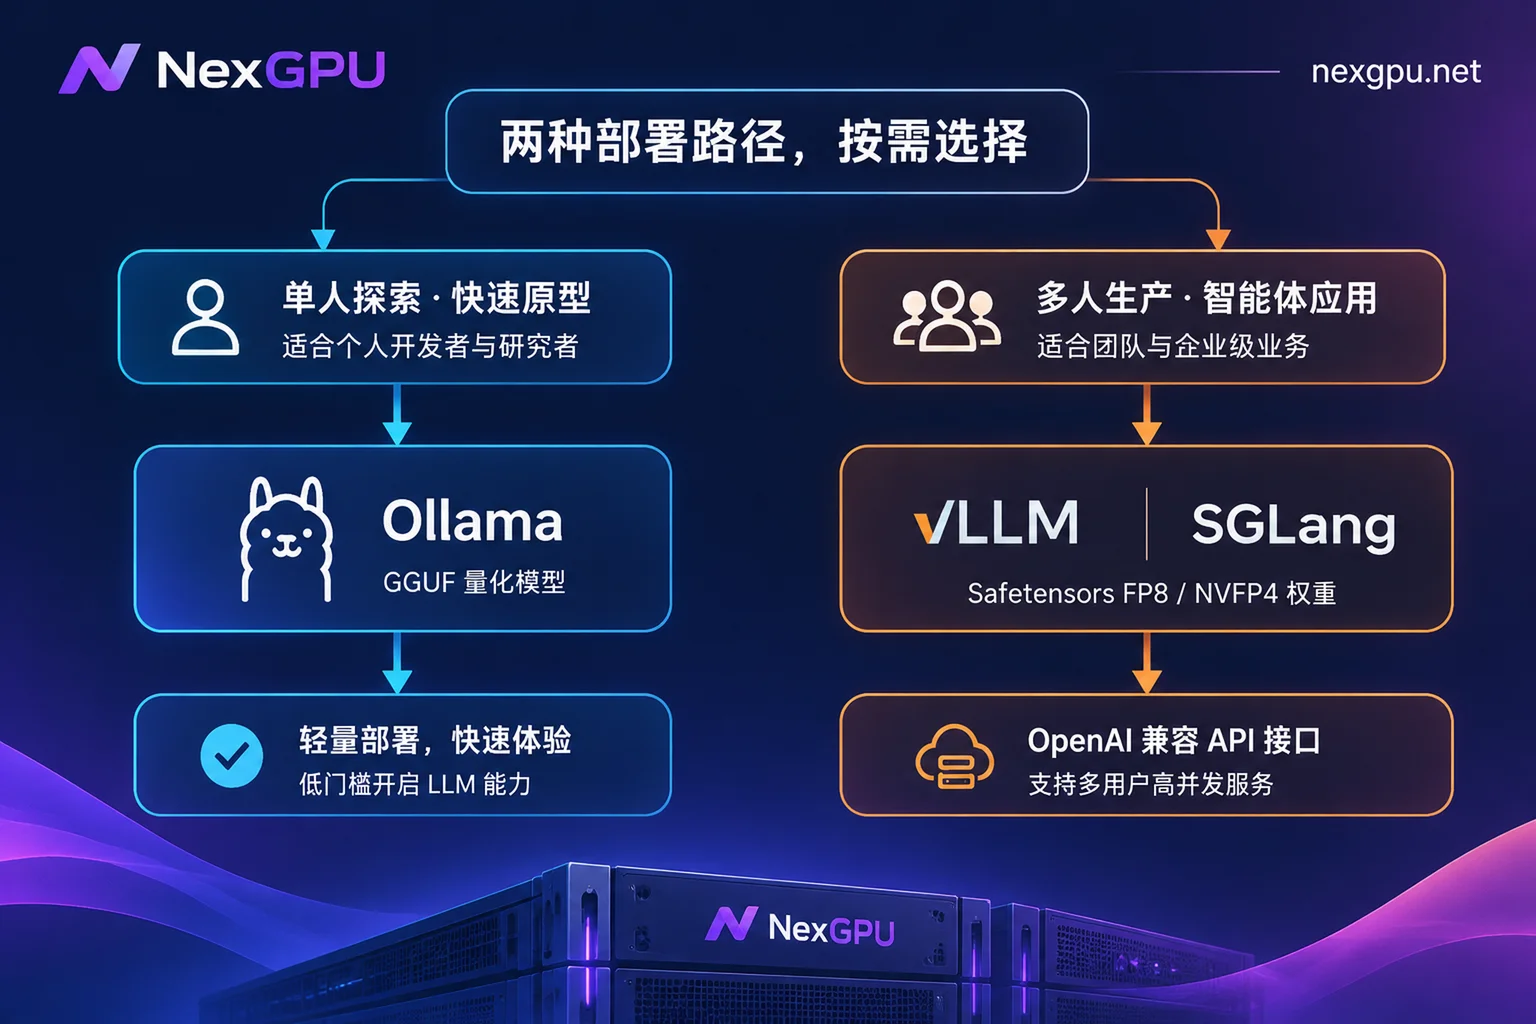
- Ollama(个人开发 / 1~2 人调试 / POC 验证):本质是对
llama.cpp的工程封装,只用一条命令就能拉取量化模型并启动 HTTP 接口,Mac 和 Linux 都很顺手。但它的默认调度偏向单用户交互,一旦 3~10 个以上用户或 Agent 并发请求同时涌入,排队延迟会快速放大。 - vLLM(生产环境 / 高并发 OpenAI 接口首选):依靠 PagedAttention 和连续批处理(Continuous Batching),能把多路并发请求合并塞进 GPU 算力里,吞吐量通常是单机方案的数倍。同时它对
Qwen3.8-27B的混合注意力、FP8/NVFP4 量化以及工具调用解析都有官方 Recipe 支持。 - SGLang(多轮 Agent / 长 System Prompt 复用 / 结构化输出):如果你的业务里每轮请求都带着上万 Token 的固定系统提示词、历史代码库上下文或需要强约束 JSON 输出,SGLang 的 RadixAttention 前缀缓存复用和较低的调度开销往往能带来更高的有效吞吐。
格式踩坑提示:Ollama / llama.cpp 使用的是 GGUF 格式权重;而 vLLM / SGLang 原生读取的是 Hugging Face Safetensors 格式权重(BF16、FP8、NVFP4、AWQ 等)。不要在本地测试阶段下了几十 GB 的 GGUF 文件,转头想直接喂给 vLLM,两者权重文件并不通用。关于从 Ollama 平滑迁移到生产环境的完整思路,也可以参考本站的vLLM部署实战指南。
三、从开卡到暴露接口:三套可复制的 Qwen 部署实操
如果本地没有 24GB 以上的独立显卡,或者不想在本机折腾 CUDA 版本冲突、显卡驱动和海外权重下载慢的问题,可以直接在 NexGPU 按小时租用现成的 GPU 实例来跑通整套流程:
- 选环境与选卡:在 NexGPU 创建实例时,既可以直接在镜像模板里选择预装好驱动、CUDA 和推理框架的 Ollama / vLLM / SGLang 镜像(拉起后直接提供 OpenAI 兼容接口),也可以填写你自己的公开或私有 Docker 镜像地址并自定义启动命令。先选好环境和模板再去 GPU 市场筛机器时,平台会自动标出显存不足的节点并说明原因;比如跑 Q4 版
Qwen3.8-27B可选单张 RTX 4090(24GB)或 RTX 5090(32GB),跑 FP8 或大上下文并发则可直接筛选 48GB/80GB 级别数据中心显卡或多卡节点。 - 直连与开放端口:实例开机后支持浏览器网页终端和 SSH 直连(公网 IP 加端口,不经跳板机)。NexGPU 为每台实例分配公网 IP 和端口映射,并额外留出一组备用端口给自定义服务使用——注意端口映射在实例创建后不可增删,开卡前确认好模板自带服务端口(如 vLLM 默认
8000、SGLang 默认30000、Ollama 默认11434)即可。
如果你想先对照不同 Qwen 模型量化后的精确显存门槛与推荐卡型,可以直接查看 NexGPU 的 Qwen部署 模型指南页。
方案 A:最快跑通测试(Ollama 单卡方案)
适合个人开发验证效果。在带 24GB 及以上显存的实例终端中执行(需确认镜像内 Ollama 已更新至支持 Qwen3.8 架构的版本):
# 拉取并运行 Qwen3.8-27B 默认 Q4 量化版(约 16.5GB,含视觉组件)
ollama run qwen3.8:27b

# 如果只做低显存轻量测试,可改用 8B 版本
ollama run qwen3:8b
方案 B:生产级高并发 API(vLLM 标准方案)
适合对外服务和团队接入。Qwen3.8-27B 依赖较新的推理栈(需 transformers >= 5.8.0 及支持 Qwen3_5Config 混合架构的 vLLM 版本;如果预置镜像版本较旧,建议在 NexGPU 创建实例时直接填写上游最新 vllm/vllm-openai 镜像)。
以单张大显存卡或双卡部署 Qwen/Qwen3.8-27B-FP8 为例:
# 若从国内网络环境加速拉取权重,可先配置镜像源
export HF_ENDPOINT=https://hf-mirror.com

# 启动 vLLM OpenAI 兼容服务(以单卡 80GB 或双卡 TP=2 为例,按实际卡数调整 --tensor-parallel-size)
vllm serve Qwen/Qwen3.8-27B-FP8 \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 1 \
  --max-model-len 131072 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3 \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_coder
如果你租用的是 RTX 5090(Blackwell 架构),还可以直接拉取社区或官方的 NVFP4 量化权重(如 unsloth/Qwen3.8-27B-NVFP4)配合 FP8 KV Cache,进一步压低显存占用并提升生成速度。
方案 C:Agent 与长前缀复用场景(SGLang 方案)
如果你主要接入 Coding Agent、自动化工作流,或在同一套长提示词模板下做高频调用,可以用 SGLang 启动服务:
python3 -m sglang.launch_server \
  --model-path Qwen/Qwen3.8-27B-FP8 \
  --trust-remote-code \
  --kv-cache-dtype fp8_e4m3 \
  --mem-fraction-static 0.85 \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_coder \
  --host 0.0.0.0 \
  --port 30000
服务启动后,在本地机器用映射出来的公网地址验证接口是否畅通(如果是双卡 MoE 如 Qwen3.6-35B-A3B,只需把 --model-path 换成对应仓库并按显存调整卡数即可;关于 vLLM 与 SGLang 在前缀缓存和吞吐上的更多实测差异,可参考本站的 SGLang 与 vLLM 选型对比):
curl http://<你的公网IP>:<映射端口>/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Qwen/Qwen3.8-27B-FP8",
    "messages": [{"role": "user", "content": "用三句话说明为什么需要KV Cache量化"}],
    "temperature": 0.7
  }'
四、最容易踩的 5 个 Qwen 部署深坑与排查办法
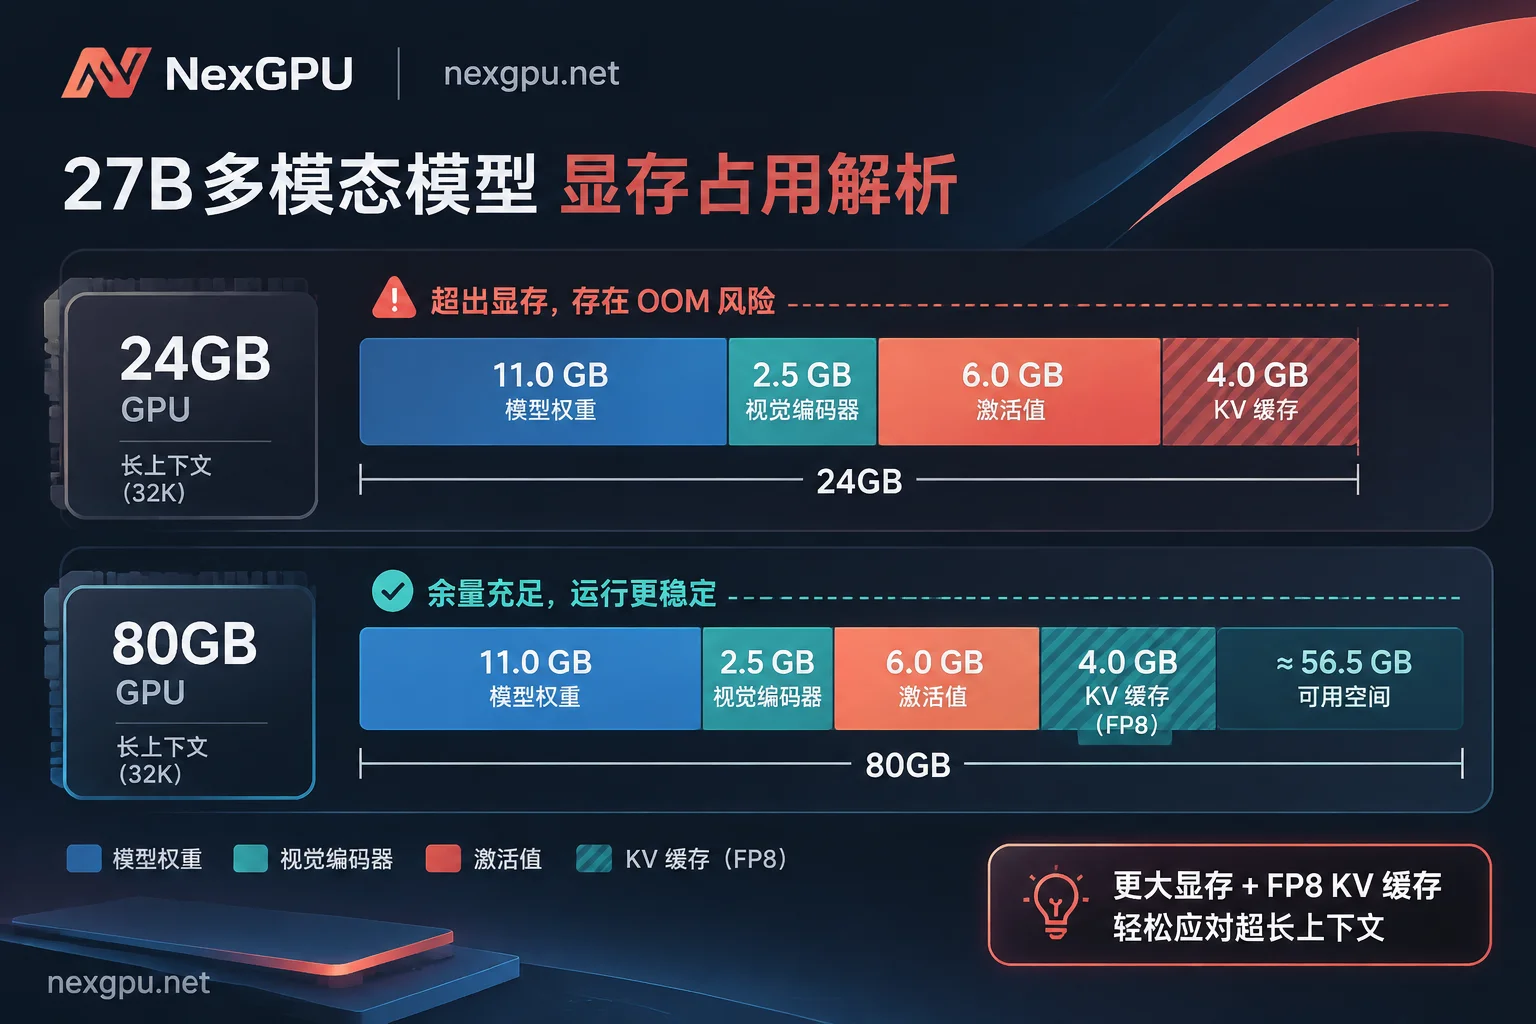
坑 1:24GB 显存跑 27B Q4 权重明明放得下,一对话就报 OOM
原因:模型参数标称支持 262K 原生上下文,不代表 24GB 显存就能开到 262K。Q4 量化权重本身就要占掉 16GB~17GB,再加上视觉编码器、推理激活空间以及随序列长度增长的 KV Cache,24GB 单卡上的安全实用上下文通常在 8K~32K 左右;强行把 --max-model-len 拉到 128K 以上必然显存溢出。
解法:在 24GB 卡上先把 --max-model-len 限制在 16384 或 32768,同时打开 --kv-cache-dtype fp8;若确实要跑 128K~256K 长文档或代码库分析,直接换 48GB~80GB+ 单卡或双卡节点。具体的多卡显存分账方法可看Qwen部署要多少显存?双卡分账指南。
坑 2:接入 Agent 后,工具调用失效或思考过程全混在正文里
原因:Qwen3.6 / Qwen3.8 默认带有思考模式与专用工具调用格式。如果启动 vLLM/SGLang 时漏掉了 --reasoning-parser qwen3 和 --enable-auto-tool-choice --tool-call-parser qwen3_coder,服务端就不会把思考过程分离到 reasoning_content 字段,也不会把函数调用解析成标准的 tool_calls JSON 结构,客户端拿到手的是一堆纯文本标签。
解法:务必在启动命令里同时带上推理解析器和工具解析器;另外部分客户端会根据模型 ID 前缀自动识别 Qwen 模板,若自定义了 --served-model-name(例如改成 my-chat),需在客户端配置里显式声明推理模板和上下文长度。
坑 3:拉起服务时报 KeyError 或找不到 Qwen3_5Config / 架构不支持
原因:Qwen3.5、3.6、3.8 采用了 Gated DeltaNet 与常规注意力的混合层结构(Qwen3_5ForConditionalGeneration),旧版 transformers、vLLM、SGLang 或老版本 Ollama 根本无法识别配置文件里的字段。
解法:升级推理引擎和 transformers(vLLM 配方要求 transformers >= 5.8.0)。在 NexGPU 上如果发现选用的通用镜像里框架版本偏旧,直接改用自定义 Docker 镜像功能拉取官方最新推理镜像,比在容器内手动编译依赖更省时间。
坑 4:磁盘爆满、拉权重卡死,或“关机了为什么还在扣费”
原因:一方面,FP8 版 27B 权重约 31GB、BF16 约 52GB,加上缓存目录和系统镜像,开卡时如果系统盘/数据盘给得太小(比如只留 40GB),拉模型到一半就会报 No space left on device;另一方面,很多人误以为关机就完全免费。
解法:
- 下单选机器时按“权重体积 × 2 + 镜像冗余”预留磁盘(建议至少留 100GB 以上),因为 NexGPU 实例创建后不支持再扩容磁盘。
- 搞清楚云端计费边界:在 NexGPU 上,算力费按秒计量、按小时计价,停机就会立刻停止算力计费;但磁盘存储费按 GB/月计算,停机保盘期间依然照收,只有彻底销毁实例才会停止存储费(且销毁后磁盘立即释放、无法找回数据,详见云GPU存储费怎么算)。测试完确定不再复用环境时,记得直接销毁实例;短期还要接着调参,再选择停机保盘。
坑 5:用错版本选卡策略,小卡硬扛多卡通信税
原因:有团队为了省钱,用两张低显存卡凑起来跑本可以一张卡塞下的模型,或者直接上 235B / 125B+ MoE,结果跨卡通信开销加上显存余量不足,实际出字速度反而更慢、账单还更高。
解法:能单卡放下的(如单张 24GB/32GB 跑 Q4,单张 48GB/80GB 跑 FP8/BF16)尽量优先单卡;需要跑更大规模多卡切分时,先参考Qwen 部署实战指南:从 7B/32B 到 235B MoE算清各档卡型的性价比。
五、开跑前 30 秒自检清单
- 用途定模型:个人/单卡多模态与 Agent 选
Qwen3.8-27B;高并发文本/低单 Token 成本选Qwen3.6-35B-A3B;商业对外产品避开非 Apache 2.0 授权的预览大权重。 - 并发定引擎:1~2 人试玩用 Ollama(GGUF);生产多用户 API 用 vLLM(Safetensors);高频复用固定提示词的 Agent 用 SGLang。
- 显存与磁盘留余量:权重体积 + KV Cache + 视觉投影至少留 20%~30% 显存缓冲,磁盘预留 100GB+ 再开机。
- 参数一次带全:vLLM/SGLang 记得加上
--reasoning-parser qwen3与--enable-auto-tool-choice --tool-call-parser qwen3_coder,并开好--kv-cache-dtype fp8。 - 用完及时处理实例:短暂歇手点停机保盘,项目结束导出配置后直接销毁释放存储,把每一小时算力和每 GB 存储花在刀刃上。


