 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
先给结论:同样叫 H100,租用时绝不能只看名字和时租低价,核心按任务场景拍板——做 4 卡或 8 卡分布式训练、以及跨卡张量并行的高并发推理,直接选 H100 SXM(SXM5),只有它具备 900 GB/s 的 NVLink 4.0 全互联和 3.35 TB/s 的 HBM3 带宽;做单卡 LoRA/QLoRA 微调、小模型推理或环境跑通验证,选 H100 PCIe 更省钱,虽然显存带宽降到 2.0 TB/s(HBM2e),但单卡不吃跨卡通信,租金通常低 15%~35%;跑 70B+ 大模型推理或长上下文、80GB 显存差一点装不下时,优先找 94GB HBM3、约 3.9 TB/s 带宽的 H100 NVL,或者直接向上对比 H200。
很多开发者在对比云算力报价时都会纳闷:为什么同是“H100 80GB”,有的平台一小时不到 2 美元,有的要 3~4 美元以上,甚至租了多卡 H100 跑训练,速度却只快了一点点?问题往往不是平台“限速”,而是你租到的物理形态和互联拓扑根本不是同一套东西。
一、同叫 H100,SXM、PCIe 与 NVL 的核心参数差在哪?
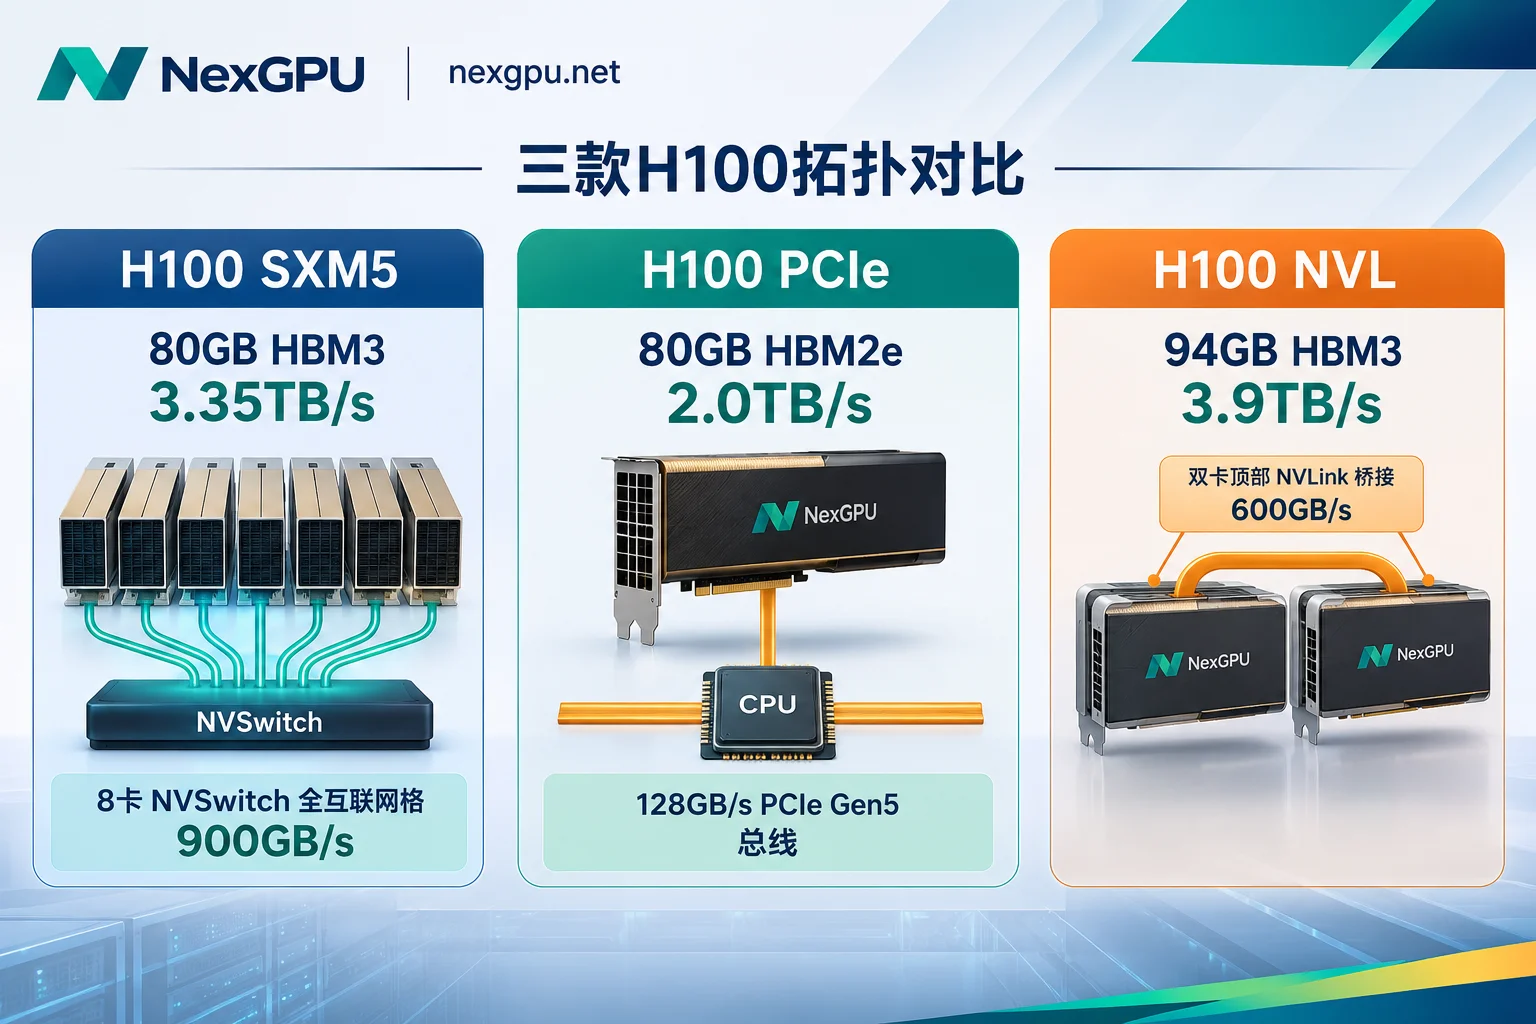
三款显卡虽然都基于 NVIDIA Hopper 架构(GH100 核心),支持第 4 代 Tensor Core 和硬件级 FP8,但它们的封装形态、显存颗粒、流处理器规模、功耗上限和卡间互联方式完全不同。
| 核心指标 | H100 SXM (SXM5) | H100 PCIe | H100 NVL |
|---|---|---|---|
| 物理形态与常见整机 | SXM5 模组(HGX / DGX 8卡主板) | 标准双槽 PCIe Gen5 插卡 | 双槽 PCIe Gen5 插卡(常见双卡成对) |
| SM / CUDA / Tensor Core | 132 SM / 16,896 / 528 | 114 SM / 14,592 / 456 | 132 SM / 16,896 / 528 |
| 显存容量与颗粒类型 | 80 GB HBM3 | 80 GB HBM2e | 94 GB HBM3 |
| 显存带宽 | 3.35 TB/s | 约 2.0 TB/s | 约 3.9 TB/s |
| FP8 算力(含 2:4 稀疏性*) | 3,958 TFLOPS | 3,026 TFLOPS | 3,341 TFLOPS |
| FP16/BF16 算力(含稀疏性*) | 1,979 TFLOPS | 1,513 TFLOPS | 1,671 TFLOPS |
| 卡间互联方式 | NVLink 4.0 + NVSwitch,900 GB/s 全互联 | PCIe Gen5(128 GB/s),云上多数无 NVLink 桥 | PCIe Gen5 + NVLink 桥接(600 GB/s 双卡) |
| 功耗上限 (TDP) | 最高 700W | 350W | 350W–400W 可配置 |
| 最典型适用场景 | 多卡训练、高吞吐张量并行推理 | 单卡微调、常规单卡推理、CI 验证 | 70B+ 大模型推理、长上下文 KV Cache |
*注:NVIDIA 规格表中的峰值 TFLOPS 默认包含 2:4 结构化稀疏性;实际训练和推理中如果未开启稀疏化,稠密算力约为表中数值的一半(例如 SXM5 稠密 FP8 为 1,979 TFLOPS,稠密 FP16/BF16 为 989 TFLOPS)。
从 2026 年市场整体租赁行情来看,专业算力云上的 H100 按需单价大致集中在 $1.73~$3.50/GPU-小时区间(行业中位数约 $3.38/小时),传统超大规模云厂商则常在 **$6.88~$12+/GPU-小时**;在同一梯队平台里,H100 PCIe 的时租通常会比 H100 SXM 低 10%~35% 左右,H100 NVL 则介于两者之间。
二、参数差距落实到真实业务,有三个最容易踩的坑
1. 同是 80GB,HBM2e 与 HBM3 的显存带宽差出 40%
很多人只看“80GB 显存”就默认推理速度差不多,但大语言模型进入生成(Decode)阶段后,性能瓶颈几乎不在计算核心,而在显存带宽——每生成一个 Token,GPU 都要把模型权重重新从显存读入计算单元。
- H100 PCIe 用的是 HBM2e,带宽只有约 2.0 TB/s,大概相当于 H100 SXM(3.35 TB/s HBM3)的 60%。这意味着跑完全相同的模型和量化精度,PCIe 单卡的每秒生成 Token 数会明显低于 SXM。
- H100 NVL 把带宽拉到了约 3.9 TB/s,同时单卡给到 94GB HBM3。多出来的 14GB 显存看似不多,但对 70B 级模型 FP8 推理非常关键:80GB 显存扣掉约 70GB 权重后只剩约 10GB 留给 KV Cache 和系统开销,上下文一拉长或并发一高就容易触发抢占;换到 94GB 的 NVL,可用 KV Cache 空间直接翻倍以上。
2. 多卡训练掉速的最大元凶:PCIe 总线 vs NVSwitch
如果你租 4 卡或 8 卡做分布式训练(FSDP、DeepSpeed、Megatron)或者跨卡张量并行(TP),真正决定加速比的是卡间互联而不是单卡 TFLOPS。
- H100 SXM 节点(如 8 卡 HGX H100)内部有 4 颗 NVSwitch 芯片,任何一张卡都能以 900 GB/s 双向带宽同时与同节点其他 7 张卡直连通信,无阻塞也不走 CPU。
- H100 PCIe 节点在大多数云平台上并没有插物理 NVLink 桥接器,卡间通信只能绕经 PCIe Gen5 总线(双向 128 GB/s)和主板根复合体,带宽与 SXM 差了好几倍。实测中,8 卡规模下 SXM 集群仍能保持高扩展效率,而无 NVLink 桥的 PCIe 节点通信等待时间暴涨,很多时候总吞吐远不如预期,单卡时租省下的钱全赔在了延长的训练小时数里。
- H100 NVL 的互联定位在中间:它支持通过物理 NVLink 桥把相邻两张卡直连成 188GB 显存池(双向 600 GB/s),非常适合两卡 TP 推理或轻量 2/4 卡任务,但它不是为 8 卡全互联高频梯度同步设计的。
3. 700W 与 350W 的功耗差距,决定了高负载下的持续算力
除了卡间通信和显存,H100 PCIe 因为要塞进常规 350W 风冷服务器插槽,不仅流处理器从 132 个砍到了 114 个,功耗墙也锁在 350W;而 H100 SXM 拥有高达 700W 的 TDP 空间。在做高批次全参数训练、密集矩阵乘法等 Compute-bound 任务时,SXM 能够长期稳定维持更高主频,不会像低功耗版那样很快撞到功耗墙降频。
三、四类真实场景怎么选卡,既不浪费预算也不卡瓶颈?
- 单卡 LoRA / QLoRA 微调、小模型(7B–32B)全量测试 → 首选 H100 PCIe
只要模型和激活值能塞进单张 80GB 显存,任务就完全不触发跨卡通信。此时 LoRA/QLoRA 对显存带宽和 700W 极限算力没那么敏感,租更便宜的 H100 PCIe 性价比最高。如果你连自己到底需不需要上到 H100 还不确定,可以先对照这篇文章做一次自查:H100租用多少钱一小时?5个该不该租的自查条件。 - 4 卡~8 卡全参数微调、强化学习后训练(如 GRPO)与多卡重度推理 → 必须选 H100 SXM
无论使用 DeepSpeed、FSDP 还是 Megatron,或者在推理侧开启 TP=4/TP=8 压低首字与出字延迟,只要节点内存在高频 All-Reduce / All-Gather 通信,就必须选带 NVLink + NVSwitch 的 SXM 节点。关于多卡并行度具体怎么拆,可以参考:张量并行和流水线并行怎么选:按显存、卡间连接和并发三步判断。 - 70B+ 模型推理、超长上下文、双卡高吞吐部署 → 看 H100 NVL 或直接跨档看 H200
当 80GB 显存刚好被权重和 KV Cache 撑爆、又不打算上到 4 卡时,94GB 的单卡 NVL 或 188GB 的双卡桥接 NVL 非常顺手。不过在 2026 年底,如果 H100 NVL 溢价偏高或者现货不多,建议顺便对比一下 141GB HBM3e、4.8 TB/s 带宽的 H200,具体成本临界点可以看:H100和H200哪个划算?看显存带宽与时租溢价。 - 代码还没跑通、数据管道还在调、或者常规文生图工作流 → 先别急着租 H100
如果训练脚本一启动还经常报错、或者数据加载(CPU/磁盘 IO)跟不上 GPU 喂料速度,直接开高价 H100 只会让“排错的每一分钟”变得非常昂贵。正确做法是先用低价卡把代码和镜像跑通,确认瓶颈确实在显卡算力或 80GB 显存上,再切到 H100。
四、下单租用 H100 前的 5 步防踩坑实操(结合 NexGPU 流程)
为了避免“页面写了 H100,开机才发现拓扑不对或费用失控”,建议按下面五步核查再开机:
- 核对机器明细,别只看显卡大类名称
在 H100租用 市场挑选节点时,NexGPU 的列表每一行对应一台真实可租的机器,会分开标明算力单价和磁盘单价,同时支持按显存、价格、地区、可靠性、带宽和最少卡数筛选(当前在售具体子型号与实时单价以官网列表为准)。多卡节点整机出租,下单金额等于单卡价乘以卡数,A100、H100、H200 多卡节点可直接用于 DeepSpeed、FSDP 和 Megatron 训练。 - 先查显存门槛,再选对应的预置镜像模板
如果拿不准模型量化后的显存红线,可以先在 NexGPU 模型选卡指南 核对常见开源模型的显存门槛与部署流程。开机时直接在 镜像模板 里选用对应环境——推理可选 vLLM、SGLang、TGI、Ollama(拉起即 OpenAI 兼容接口),训练微调可选 PyTorch、LLaMA Factory、Axolotl、Unsloth;模板本身不额外收费也不分档。如果你的训练框架锁死了特定 CUDA 版本,官网建议直接填写自己的公开或私有 Docker 镜像,省去重装驱动和编译依赖的时间。 - 先小卡排错,再按秒切 H100 跑全量
NexGPU 注册即可看实时价格,不需要实名认证或配额申请,也没有最低消费和起租时长,算力费按秒计量、按小时计价,且下单时的单价会一直锁定到该实例销毁。你可以先开一台低价的消费级显卡(如 RTX 4090 / 5090)把容器环境、数据下载和启动命令验证通过,再开 H100 节点直接跑正式任务。 - 分清“停机”和“销毁”,管好算力、存储、流量三笔账
很多用户以为关机就一分钱不花,结果被存储费扣光余额。在 NexGPU 上账单只包含算力、存储和流量三项,分项列在实例详情页:停机后算力费立刻停止并保留磁盘数据,但存储费(按 GB/月计)停机期间照收,只有输入实例编号确认销毁实例后存储才停止计费(且磁盘立即释放、平台不做数据备份,销毁前务必把 Checkpoint 和模型权重传出)参见计费说明。想把整笔成本算细,可以参考:2026年GPU云服务器账单拆解:如何避开隐形消费,算清存储、带宽与闲置算力账?。 - 需要跨节点 RDMA、包月或对公采购,提前沟通企业方案
如果你的任务不是单机 8 卡能解决的,而是需要跨机 RDMA 高速互联、私有网络、数据隔离或包月预留算力池、签订合同与对公付款开票,可以在提交需求前直接联系 NexGPU 企业方案。
五、常见疑问快速解答(FAQ)
1. H100 PCIe 租两张或四张,能跑张量并行吗?
可以跑通代码,但跨卡通信会受限。除非主机明确配备了 NVLink 桥接器(即便有也通常只桥接相邻两张卡),否则多卡之间要走 PCIe 总线和 CPU 根复合体。对卡间通信密集的训练或高并发 TP 推理,实际吞吐往往明显低于 SXM 节点。
2. 为什么我租了 H100,实际训练速度只比之前快一点点?
通常先排查三处:一是多卡训练时机器是不是走了没有 NVLink 的 PCIe 互联;二是 CPU 核数、内存或磁盘 IO 拖慢了数据预处理与加载,GPU 一直在等数据空转;三是代码精度还停留在 FP32/FP16,没有真正开启 BF16 或 Transformer Engine 的 FP8 加速。
3. 80GB 的 H100 SXM 和 94GB 的 H100 NVL 怎么快速做决定?
如果是多卡训练(≥4卡),毫无疑问选 H100 SXM,900 GB/s NVSwitch 不可替代;如果是单卡或双卡做 70B+ 推理,94GB + 3.9 TB/s 带宽的 H100 NVL 能装下更多 KV Cache,单卡/双卡服务上限更高。


