 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
随着 Wan(通义万相)、HunyuanVideo(腾讯混元)、LTX-Video 与 CogVideoX 等开源视频生成模型的密集迭代,配合 ComfyUI 对 FP8/GGUF 量化、分块 VAE(Tiled VAE)以及步数蒸馏的原生支持,社区里经常能看到“8GB 甚至 6GB 显存跑通 AI 视频生成”的教程。
但真正动手把视频工作流跑起来之后,许多创作者和开发者会发现:“能跑通”和“能用来干活”之间,隔着巨大的时间成本与画质妥协。 本地 12GB 显卡靠 CPU Offload(内存卸载)跑一段 5 秒的 720P 视频动辄需要十几分钟;一旦想加上 ControlNet 控图、拉长帧数,或者拿几十段素材训一个专属的动作/角色 LoRA,本地机器就会立刻陷入 OOM(显存溢出)或风扇狂转的漫长等待。
选对 AI视频生成GPU,核心不是盲目追求最贵的卡,而是算清视频扩散模型(DiT 架构为主)的显存账,把“工作流调试、高画质批量出片、模型微调与并发部署”拆到不同档位的显卡上按需租用。
一、为什么“能跑通”不等于“能干活”?先算清视频模型的四笔显存账
和 Stable Diffusion 等静态图像生成 相比,AI 视频生成多出了一个“时间维度(帧数)”。在 DiT(Diffusion Transformer)架构下,分辨率的提升和帧数的增加会让三维潜空间(3D Latent)的 Token 数量呈指数级膨胀。
无论是跑文生视频(T2V)还是图生视频(I2V),一张 GPU 的显存主要被以下四部分瓜分:
- 主干扩散模型权重(DiT Backbone):例如 1.3B 轻量级模型或 14B 旗舰级模型。全精度(BF16/FP16)下,仅 14B 模型的权重就需要占用约 28GB 显存;即便采用 FP8 或 GGUF(如 Q4_K_M)量化,仍需占用 8GB~15GB 不等。
- 文本与视觉编码器(Text / Vision Encoder):视频模型通常搭配体积庞大的 T5-XXL、LLaMA 或多模态视觉语言模型作为编码器,单独加载往往就要吃掉 5GB~10GB 显存。
- 时空激活值与注意力计算(Activations & Attention):这是视频生成最容易“爆显存”的地方。720P 甚至 1080P 分辨率叠加 49 帧、81 帧甚至更长的序列,自注意力机制产生的中间激活值会随序列长度急剧飙升。
- 3D VAE 解码峰值(VAE Decoding):许多人在采样步数跑完到 99% 时遭遇 OOM,罪魁祸首就是最后一步把潜空间特征还原成像素视频的 3D VAE 解码。如果不开启分块解码(Tiling),最后几秒的显存峰值会瞬间冲高 30% 以上。
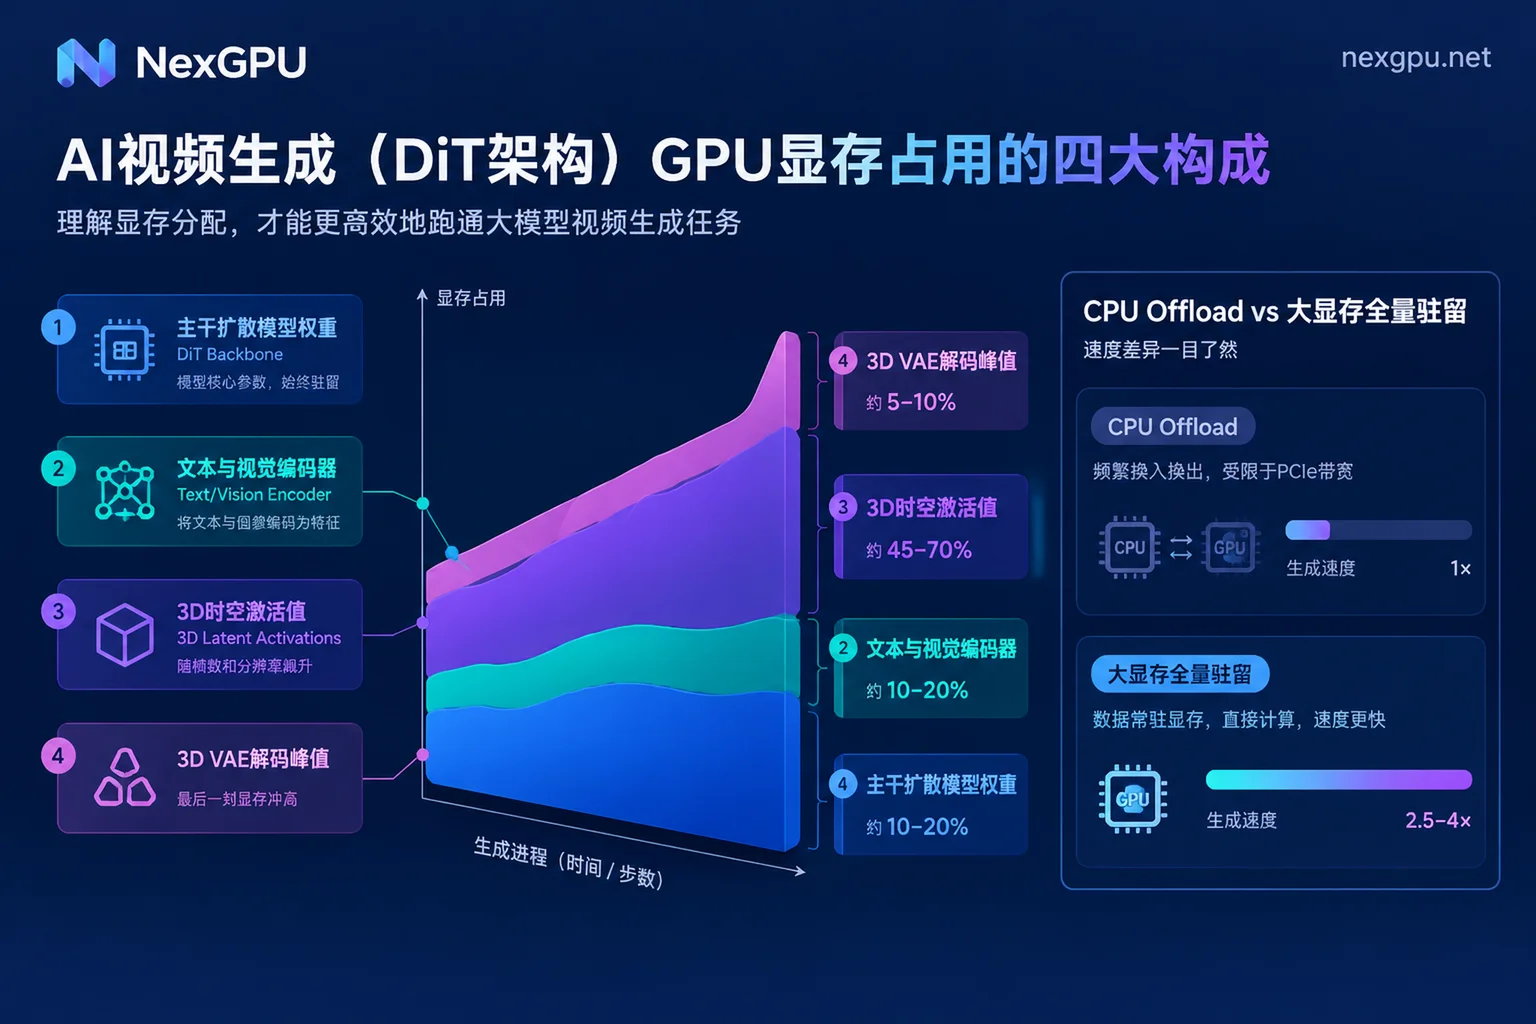
社区里的“8GB/12GB 显存救星方案”,本质上是用 GGUF/FP8 深度量化(牺牲微小的画面细节与动态连贯性) + CPU Offload(把暂时不用的编码器和模型层轮流挪到系统内存里,牺牲 PCIe 传输时间) + 强制分块解码 换来的。如果只是偶尔抽卡尝鲜,这种方案完全可行;但如果进入高频创作或商业交付,租用显存充裕的云端 GPU 把模型全量驻留在显存(VRAM)内,出片效率往往能提升数倍。
二、主流开源视频生成模型与任务场景的显存对照
不同体积的模型和不同的精度策略,对硬件的胃口差异极大。我们可以把当前主流的开源视频模型与任务划分为四个梯队(注:各模型具体版本与量化后的精确显存门槛,建议直接查阅官网实时更新的 模型选卡指南):
| 任务场景与代表模型 | 常见精度与运行策略 | 显存需求区间 | 适用 GPU 档位参考 | 典型体验与局限 |
|---|---|---|---|---|
| 轻量模型 / 深度量化尝鲜 (如 Wan 1.3B、LTX-Video、Hunyuan/Wan 14B 的 GGUF Q4 量化版) | GGUF / FP8 + CPU Offload + Tiled VAE | 8GB ~ 16GB | 入门级显卡或本地 PC | 可跑通 480P/720P 短视频;模型层频繁在内存与显存间换入换出,单条耗时较长 |
| 主力模型 FP8 高效出片 (如 Wan 14B FP8、HunyuanVideo FP8、CogVideoX-5B) | FP8 量化 / 步数蒸馏 + 轻度卸载或全显存驻留 | 24GB ~ 32GB | RTX 3090 / RTX 4090 / RTX 5090 | 创作者性价比甜点区;配合 TeaCache/步数蒸馏可在数分钟内稳定出 720P 视频 |
| 全精度原生画质 / 复杂工作流 (14B 级 BF16 原版 + ControlNet + 高清放大 + 视频 LoRA 微调) | BF16 / FP16 全精度驻留,关闭大部分慢速卸载 | 48GB ~ 80GB | 单卡 48GB 专业卡 / A100 / H100 | 避免量化带来的画质劣化与动作僵硬,支持单卡训视频 LoRA 或长帧数直出 |
| 实时并发推理 / 全量微调 (xDiT 多卡序列并行、工作室批量管线、全参数微调) | USP 序列并行 / FSDP / DeepSpeed | 80GB × N(多卡节点) | A100 / H100 / H200 / B200 多卡整机 | 将单条视频生成压缩至数十秒级,或支撑海量视频数据集的分布式训练 |
如果你不确定手头的任务在 消费级显卡什么时候不够用,一个最直观的判断标准是:当你在 ComfyUI 里每加一个控制节点就要小心翼翼地防爆显存,或者单条 5 秒视频的等待时间已经打断了你的创作思路时,就该把环境切到大显存云 GPU 上了。
三、按任务阶段选卡:把预算花在刀刃上
在 NexGPU 的 GPU 算力市场 中,消费级显卡(RTX 3090、4090、5090 等)与数据中心级显卡(A100、H100、H200、B200 等)分开列价,且按秒计量、按小时计费。创作者和研发团队完全不需要用同一张卡扛下所有流程。
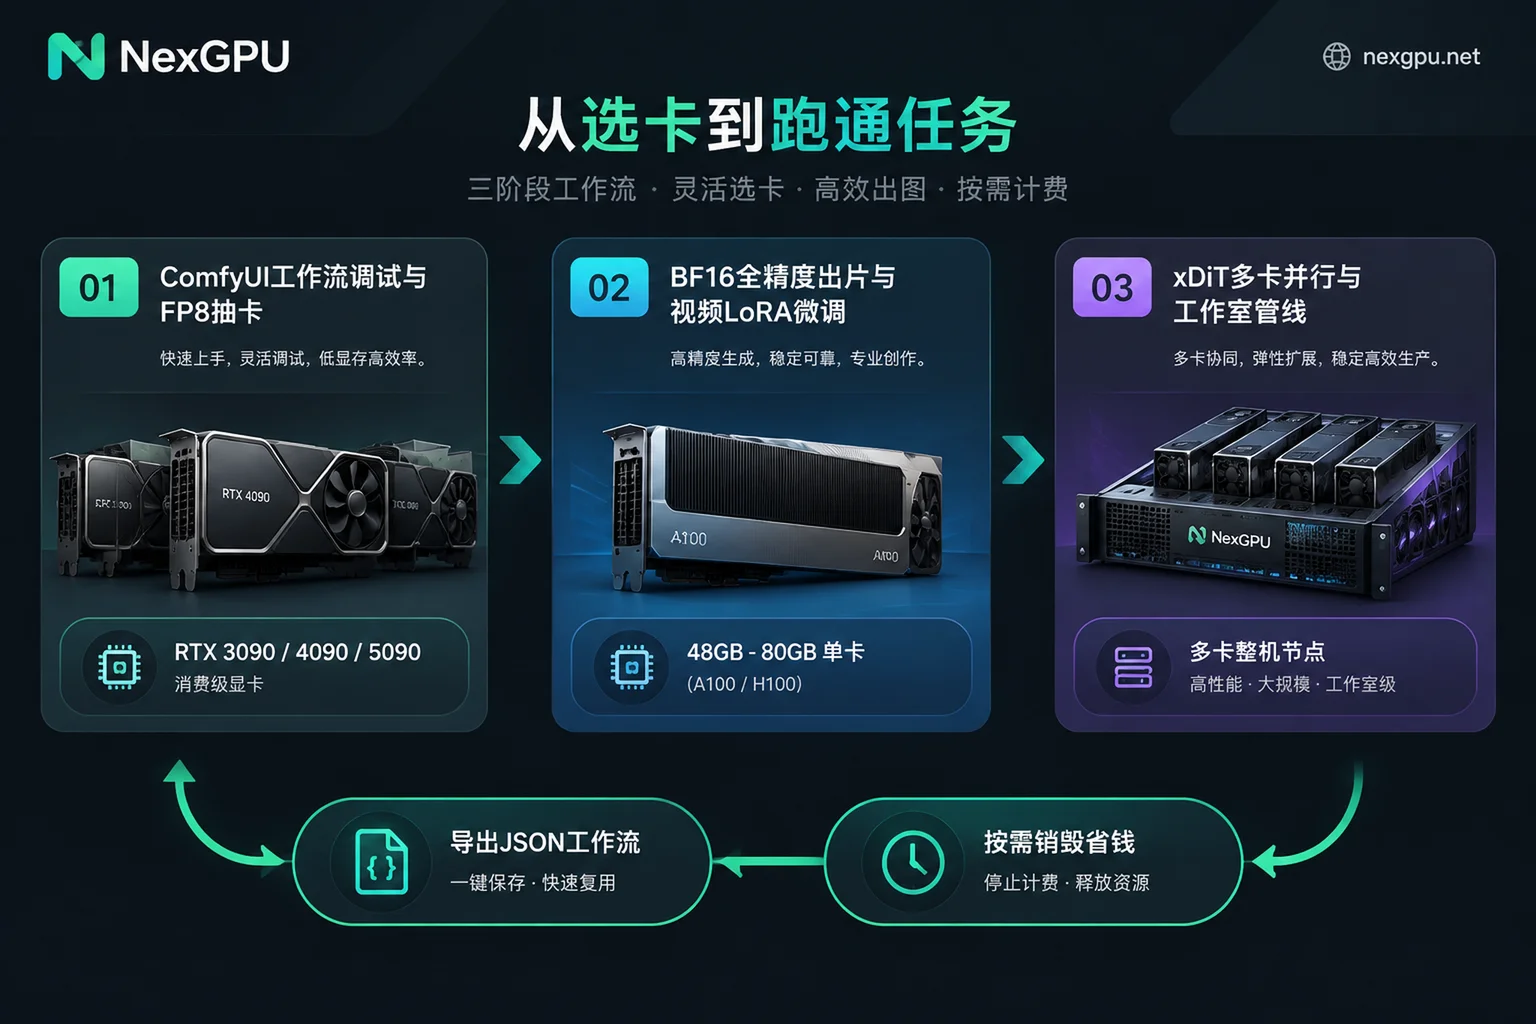
1. 搭工作流、跑通节点与抽卡测试:消费级 24GB/32GB 显卡
第一次接触某个新开源的视频模型,大部分时间其实花在调提示词、测试首尾帧控制、对齐口型或调试 ComfyUI 自定义节点上。
- 选卡策略:租用单张 RTX 3090、RTX 4090 或 RTX 5090。
- 为什么合适:24GB 及以上显存足以装下主流 14B 视频模型的 FP8 权重,配合新一代显卡强大的 Tensor Core 算力,能够充分利用 FP8 矩阵加速与 RTX 视频超分辨率等特性。先用步数蒸馏模型(如 8 步或 12 步)快速抽卡定下构图和随机种子,单次试错成本极低。
2. 原版全精度出片与视频 LoRA 训练:48GB~80GB 大显存单卡
定好画面构图后,如果需要交付商业级画质(拒绝量化带来的色彩断层或人物面部崩坏),或者需要针对特定 IP 形象、特定运镜风格训练一个专属的视频 LoRA:
- 选卡策略:筛选 48GB 至 80GB 显存 的单卡实例(如 A100、H100 等,可参考 48GB显存能跑多大的模型)。
- 为什么合适:视频 LoRA 微调不仅要存模型权重,还要在显存里保存优化器状态(如 Muon 或 AdamW)和反向传播梯度。即便开启梯度检查点(Gradient Checkpointing),24GB 显存也常常捉襟见肘(详情可延伸阅读 大模型微调GPU怎么选)。直接租用 80GB 级别的数据中心卡,可以把原版 BF16 模型连同编码器一次性塞进显存,训练完拿到
.safetensors权重后即可销毁实例,只为训练这几小时买单。
3. 结合 3D 渲染管线或团队多卡并发:多卡节点与场景组合
现在很多专业工作室会采用“Blender 3D 场景粗模渲染 + AI 视频生成重绘风格化”的混合管线。
- 选卡策略:在 NexGPU 的 场景做法页 中,不仅有针对 AI 图像与视频 的显存与镜像推荐,也支持 图形渲染(Blender、V-Ray,多台实例分段并行渲染)。同时开的实例数量不限(只受账户余额约束),你可以开多台消费级实例并行跑 Blender 分段渲染,再开一台高显存实例跑 ComfyUI 视频重绘。
- 多卡加速:如果是企业研发团队部署基于 xDiT(USP 统一序列并行)的低延迟视频生成服务,或使用 FSDP、DeepSpeed 进行大规模微调,可在市场按“最少卡数”筛选 A100、H100、H200 多卡整机节点(下单金额 = 单卡价 × 卡数)。有 RDMA 高速互联、私有网络或包月预留需求的团队,可直接通过 联系销售 定制企业方案。
四、在 NexGPU 上跑通 AI 视频生成的实操闭环
很多创作者担心云端部署环境繁琐、下载几十 GB 的视频模型权重太慢,或者不小心忘了关机导致账单失控。结合 NexGPU 的平台机制,你可以按以下四步高效运转:
第一步:免认证快速注册,先选镜像再筛机器
NexGPU 支持邮箱直接注册,不需要实名认证和配额申请(详见 快速上手指南),注册后无需绑定支付方式就能查看所有机器的实时价格,充值支持支付宝与 USDT(TRC20)。
选卡时,建议采用 “先选环境、再筛机器” 的方式:
- 进入 镜像模板,直接选择 图像与视频(预装 ComfyUI、AUTOMATIC1111,支持 SDXL、FLUX 及视频扩散模型) 模板,驱动、CUDA 与常用依赖均已配好,开机即用;如果你的视频训练代码锁定了特定的 CUDA 或 PyTorch 版本,也可以填入自己的 Docker 镜像并自定义启动命令。
- 选定环境后再去筛机器,显存不够的机器会被系统自动标出并注明原因,直接帮你避开“开机才发现装不下模型”的坑。你还可以按地区、可靠性、带宽(拉取几十 GB 视频权重时建议优先挑大带宽节点)来精筛机器(参见 如何选择 GPU)。
第二步:直连访问工作流与批量传输素材
实例启动后,平台提供三种便捷的 实例连接方式:
- 网页终端与 Jupyter:浏览器内一键打开 root 终端或已带好令牌的 Jupyter,适合直接运行模型下载脚本。
- 公网 IP + 端口映射:每台实例自带公网 IP、默认端口映射以及备用端口,你可以直接在本地浏览器打开云端的 ComfyUI 界面进行节点编排。
- SSH 直连与可视化面板:SSH 采用公网 IP 加端口直连,不经跳板机,方便用 SCP/SFTP 高速上传参考图或拉回渲染好的
.mp4视频;如果不习惯命令行,还可以一键安装 aaPanel 可视化管理面板,在浏览器里直观地管理模型文件、查看进程。
第三步:盯紧“算力、存储、流量”三项账单,善用停机与销毁
视频生成最大的特点是磁盘占用大——一个 14B 模型的全精度权重加编码器、VAE 往往就要占掉 40GB~60GB 磁盘空间。
在 NexGPU 的 计费规则 中,账单非常透明,只有 算力、存储、流量 三项,且每台机器在下单时就分开标出了算力单价和磁盘单价(下单时的单价会一直锁定到该实例销毁,无开通费、端口费或起租时长):
- 休息或跨天调试用“停机”:当你调通了复杂的 ComfyUI 视频工作流、下好了几十 GB 权重,晚上休息不想付显卡算力费时,可以在 实例管理 中点击停机。停机后算力费立即停止计算,磁盘和数据完整保留,下次可随时再启动;但需注意,存储费(按 GB/月计)在停机期间是照常收取的(详见 GPU 实例关机还收不收费)。
- 阶段任务结束用“销毁”:因为实例创建后不支持动态扩容磁盘,且平台不提供自动数据备份(独占容器,平台不读取也不备份磁盘内容),当你完成了这一批视频渲染,只需把生成的视频成品、微调好的 LoRA 权重以及 ComfyUI 工作流
.json文件 下载回本地,然后输入实例编号确认销毁。销毁后磁盘立即释放,所有计费彻底归零。下次有新项目时,重新开卡并导入几 KB 的.json工作流即可瞬间复原创作管线。
结语
AI 视频生成已经从早期的“玩具级动图”迈入了可控、高清、音画同步的生产力阶段。面对动辄数十亿参数的视频扩散模型,不必勉强本地显卡去跑耗时漫长的极限卸载,也不必盲目斥巨资自购高端硬件(可参考 AI服务器自购托管还是租GPU)。
现在就可以前往 NexGPU 的 模型选卡指南 查看主流视频生成模型的显存门槛与部署步骤,或在 GPU 价格与算力市场 挑一张高带宽的 RTX 4090 / 5090 搭配 ComfyUI 预置镜像开机,用按小时计费的灵活算力,把你的创意快速变成高清视频。


