 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
步入 2026 年下半年,ComfyUI 的生态版图已经远远超出了“单机版连线画图工具”的范畴。随着 Qwen-Image 2.1、FLUX 系列以及 LTX-2.3、Wan 2.2 等图像与视频生成模型接连融入节点生态,越来越多的电商设计团队、AI 漫剧工作室和 SaaS 开发者开始将 ComfyUI 推向生产环境的核心。
但当业务从“设计师手动点 Queue Prompt 抽卡”转向“前端网页或内部系统全自动批量调用”时,基础设施的矛盾便会集中爆发:
- SaaS 托管 API 的黑盒与高成本:市面上的 Serverless 托管 API 普遍按调用次数或积分计费,一旦遇到需要挂载多个 ControlNet、IPAdapter、高分辨率重绘或长视频扩写的多步工作流,单次生成成本极易失控;更棘手的是,托管平台往往对非标自定义节点(Custom Nodes)和私有微调权重限制重重。
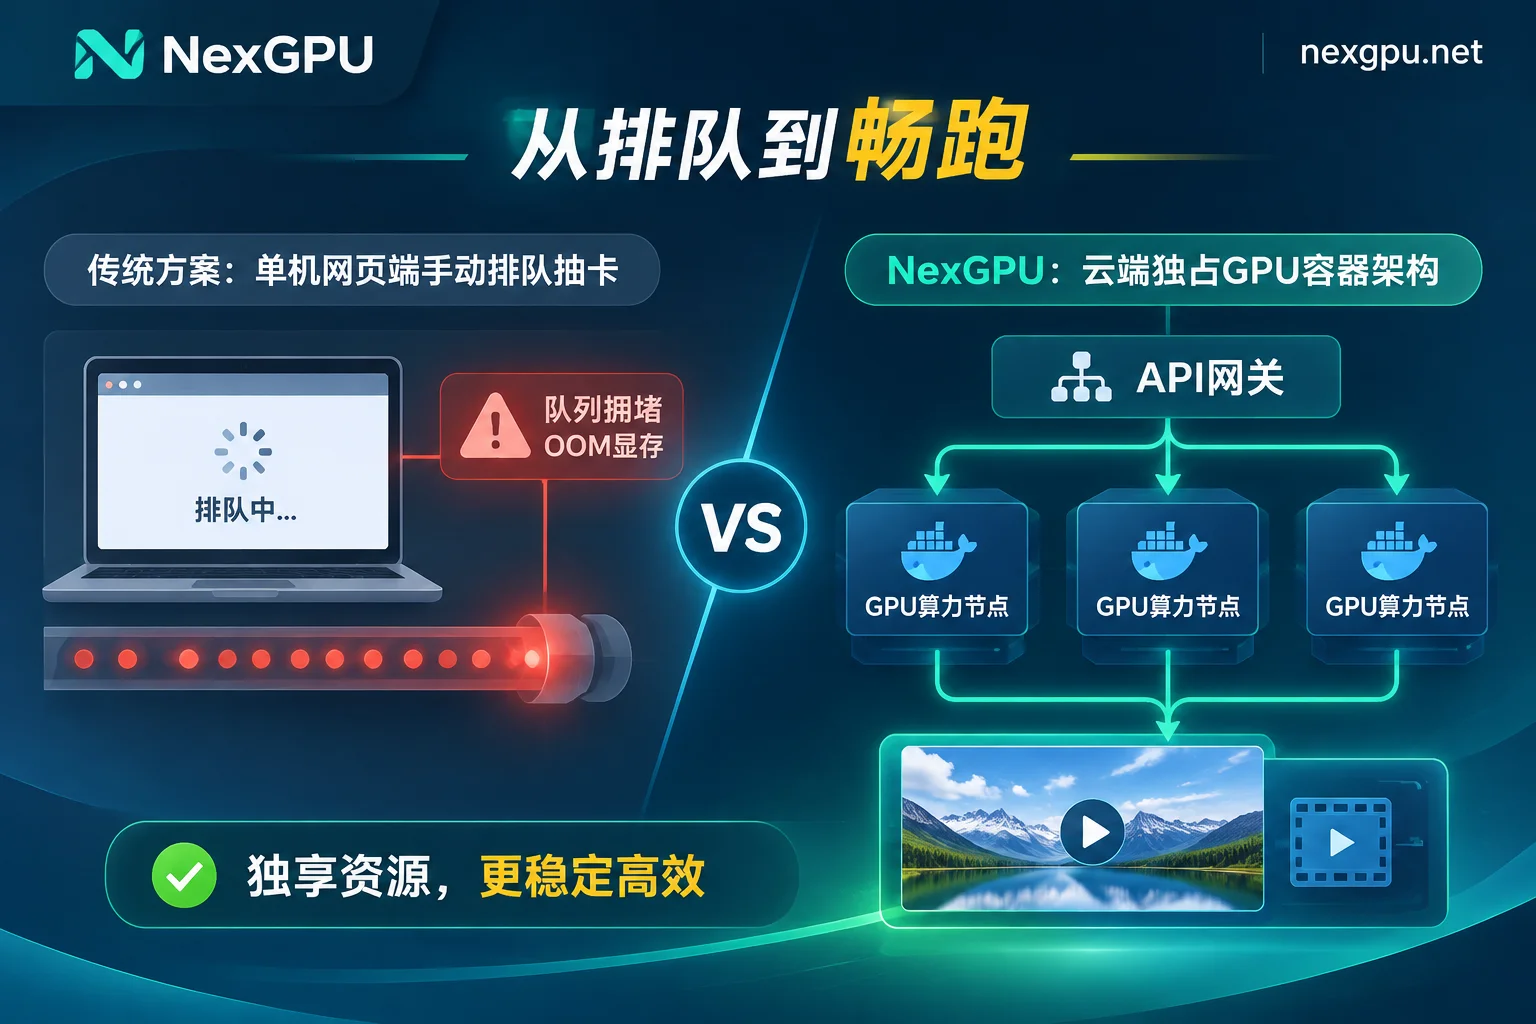
- 本地工作站的并发死穴:在本地插一两张消费级显卡跑单图尚可,一旦接入业务后端,面对突发的 10 路、20 路并发请求,单机原生队列就会让用户陷入漫长的排队等待,甚至直接触发显存溢出(OOM)导致服务崩溃。
- 环境漂移与依赖地狱:好不容易在单机上调通了包含十几个插件的工作流,想要复制第二台机器扩容时,Python 包版本冲突、CUDA 编译报错又得让人从头折腾半天。
在之前的文章中,我们曾探讨过《ComfyUI云GPU环境搭建与成本控制:从自定义节点自由、百GB模型管理到停机保盘的实操指南》以及《AI视频生成GPU怎么选:从ComfyUI量化抽卡、全精度出片到LoRA训练的选卡指南》。今天,我们彻底跳出“个人交互式画图”的视角,聚焦工程化与服务化:如何利用 ComfyUI云GPU 实例,将调优好的 JSON 工作流封装成高可用、可横向扩展、成本透明的生产级 API 后端。
一、 为什么生产级 ComfyUI API 更适合跑在独占云 GPU 实例上?
很多团队在把 ComfyUI 接入业务系统时,都会在“全托管 API 平台”与“自租 GPU 云服务器”之间摇摆。如果只是偶尔调用的标准文生图,托管 API 确实省事;但只要涉及复杂工作流编排、高频批量出图或数据隐私,基于 NexGPU 这类按小时计费的算力市场自建 Worker 节点,在工程自由度和 ROI 上都有着明显优势:
- 100% 的环境与数据掌控权:在独占容器实例中,你拥有完整的 root 权限。无论是编译特定版本的加速算子,还是挂载内部闭源的 LoRA 与 Checkpoint,平台既不限制节点类型,也不读取磁盘内容,彻底规避商业素材外泄风险。
- 算力成本与调用次数解耦:算力费按秒计量、按小时计价,下单即锁定单价直至实例销毁。只要显卡在满负荷运转,无论你一个小时内跑了 200 张电商白底图还是 1000 张草图,付出的算力成本是恒定的,彻底告别“Token/积分刺客”(参见《2026年底AI算力租赁新变局:在交付延期与「Token刺客」夹击下,企业如何打赢ROI保卫战?》)。
- 网络与端口直接暴露:无需折腾复杂的内网穿透,每台实例均配备独立公网 IP、标准端口映射以及一组备用端口,天然适合将 ComfyUI 的 HTTP/WebSocket 接口或自定义的封装服务暴露给业务网关。
二、 从“能跑”到“能扛并发”:生产级 ComfyUI 云 GPU 选卡逻辑
在个人创作场景下,我们可以通过 --lowvram 或 CPU Offload(内存卸载)把大模型硬塞进小显存显卡里,哪怕一张图多等 20 秒也能接受。但在 API 服务化场景下,频繁的显存与内存数据交换会严重拖慢单次请求的响应延迟(Latency),导致队列积压。
因此,为 ComfyUI API Worker 选卡的核心原则是:让核心大模型、文本编码器(如 T5/Qwen)与常用 ControlNet 权重常驻显存(VRAM),避免运行时频繁卸载。
在 NexGPU 价格与算力市场中,每一行都代表一台真实可租的物理机器,支持按显存、价格、地区、可靠性、网络带宽和最少卡数精准筛选。针对 2026 年主流的生产管线,建议按以下梯度配置 Worker 硬件:
| 生产业务场景 | 典型工作流负载特征 | 推荐云 GPU 型号 | 选型理由与并发策略 |
|---|---|---|---|
| 电商图精修 / 高频轻量出图 | SDXL / 轻量化蒸馏模型(4~8步极速采样)+ 1~2 个 ControlNet + 背景移除节点 | RTX 3090 / RTX 4090 (24GB) | 24GB 显存足以全量驻留基础管线,单图耗时可压至数秒内;适合通过开启多台单卡实例实现高性价比的横向吞吐扩展(详见《RTX 4090云服务器怎么租》)。 |
| 商业海报 / 复杂多模态工作流 | FLUX 全精度/FP8 + 多重 IPAdapter + 高清放大(Upscale)+ 多模态视觉反推节点 | RTX 5090 / A100 (40GB/80GB) | 复杂管线的中间张量(Latent)极易撑爆 24GB 边界;更高显存与更大显存带宽能彻底消除 OOM 报错,保障 API 99.9% 的成功率。 |
| AI 漫剧 / 音视频联合生成管线 | LTX-2.3 / Wan 2.2 / 音视频同步节点 + 视频超分放大(1080p/2K 输出) | A100 80GB / H100 / H200 | 视频扩散模型与长序列帧缓存对显存容量和计算吞吐要求极高;数据中心级显卡在长时满载下的散热与稳定性远超消费级卡(可参考《2026年H100租用实战指南》)。 |
选卡防坑提示:如果你不确定某个特定开源模型在量化或全精度下的准确显存门槛,可以先查阅 NexGPU 模型选卡指南。此外,在控制台“先选镜像环境再筛机器”时,系统会自动标出显存不足的机器并注明原因,帮你从源头避开硬件错配(详细筛选技巧见官方文档:如何选择 GPU)。
三、 工程落地三步走:把 ComfyUI 变成稳定的后端微服务
要在云端搭建一套可复现、易维护的 ComfyUI API 架构,不能靠每次开机手动敲命令拉代码。以下是经过实战验证的三步走标准流程:
第一步:用镜像模板快速打样,用私有 Docker 镜像固化生产环境
在工作流研发与调试阶段,你可以直接选用 NexGPU 镜像模板 中预置的 ComfyUI 图像与视频模板。该模板已预装好底层驱动、CUDA、PyTorch 及常用依赖,开机即可进入可视化界面搭建节点。
但当工作流调试完毕、准备作为 API 节点批量上线时,强烈建议将环境打包为自定义 Docker 镜像:
- ComfyUI 插件生态迭代极快,今天
git pull能跑通的自定义节点,明天可能就因为依赖库更新而报错。 - 当你的自定义算子锁定了特定 CUDA 版本或 Python 依赖时,将其固化到自己的 Docker 镜像(支持公开或私有镜像仓库)是最稳妥的做法。
- 在 NexGPU 创建实例时,只需填入你的私有 Docker 镜像地址,并自定义启动命令(Start Command)与环境变量(Environment Variables),即可让新开出的机器在拉起后直接静默运行 ComfyUI API 服务,做到“开机即接入生产集群”。
第二步:打通 API 调用链路与备用端口映射
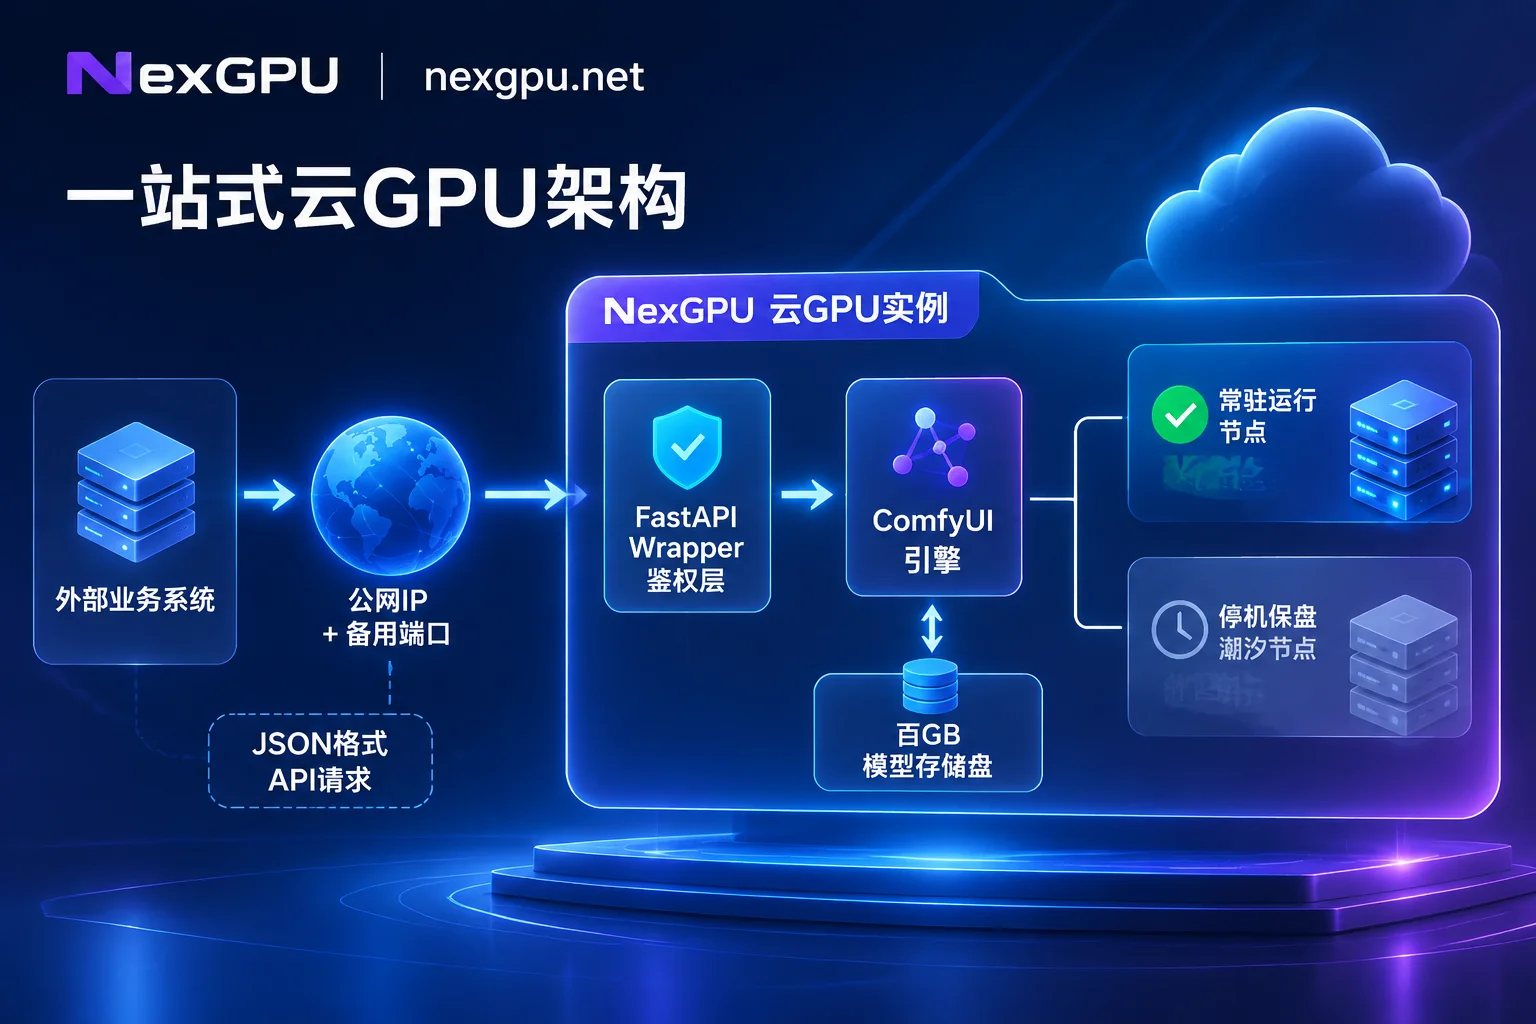
原生 ComfyUI 内置了基于 HTTP 与 WebSocket 的無头(Headless)调用机制。你只需在前端界面开启开发者模式,点击 “Save (API Format)”,即可导出一份纯数据结构的工作流 workflow_api.json。
在云端部署时,为了安全性与业务解耦,通常有两种暴露服务的方式(连接与端口详情可查阅实例连接指南):
- 直连原生接口:利用实例自带的公网 IP 与映射端口,由你的业务后端(Go/Python/Node.js)直接向云端实例的
/prompt接口 POST 修改好参数(如替换正向提示词、随机种子、输入图片 URL)的 JSON,并通过/wsWebSocket 监听生成进度与实时预览帧。 - 挂载轻量级 Wrapper 与监控(利用备用端口):原生 ComfyUI 接口缺乏鉴权(Auth)与结果自动上传对象存储(如 S3/COS)的逻辑。你可以在同一台实例内编写一个轻量级的 FastAPI 包装服务,监听平台预留的备用端口。业务网关将带 Token 鉴权的任务发给该备用端口,Wrapper 负责在本地调用
127.0.0.1:8188的 ComfyUI、拦截报错日志、并将生成的成品图自动推送到云端图床后返回签名 URL。
在日常运维中,除了使用 网页终端 或 SSH 直连(公网 IP 加端口直达,不经跳板机)排查问题外,你还可以一键安装 aaPanel 可视化管理面板,直接在浏览器里直观地管理模型文件目录、守护进程(Supervisor)和计划清理任务,大幅降低非专职运维人员的维护门槛。
第三步:多实例横向并发与动态扩缩容架构
需要明确的一个底层机制是:单张 GPU 跑单个 ComfyUI 进程时,本质上是串行队列(Queue)处理。即便你把 batch_size 调大,受限于显存容量和单次延时,它也无法同时低延迟地响应多个不同用户的异构工作流请求。
因此,生产环境应对高并发的标准解法是 “外部消息队列 + 多实例/多卡 Worker 池”:
- 单卡多实例横向扩容:在 NexGPU 上,同时开启的实例数量没有硬性限制(仅受账户余额约束)。面对大促或业务高峰,你可以用同一个私有 Docker 镜像快速拉起 5 台或 10 台 RTX 4090/5090 实例,注册到业务网关的 Redis 任务队列中共同消费生图任务。
- 单机多卡节点切分:如果你倾向于集中管理,也可以在市场中按“最少卡数”筛选 4 卡或 8 卡节点整机租用(下单金额 = 单卡价 × 卡数)。在机器内部,通过设置
CUDA_VISIBLE_DEVICES=0,1,2...分别启动多个绑定不同端口的 ComfyUI 进程,实现一机多 Worker 并发处理。
四、 生产环境的成本精算:如何用“停机保盘”与锁价机制省下 50% 预算?
将 ComfyUI 搬上云端后,架构师最关心的莫过于月度账单。很多团队在传统大厂云上踩过隐形消费的坑(详见《2026年GPU云服务器账单拆解:如何避开隐形消费,算清存储、带宽与闲置算力账?》)。
在 NexGPU 的计费体系中,账单被严格收敛为算力、存储、流量三项,无任何开通费、端口费或起租时长限制。结合业务波峰波谷,你可以用以下策略把每一分钱都花在刀刃上:
- 常驻节点 + 弹性潮汐节点组合:
绝大多数 ToC 生图应用或内部设计工具都有明显的昼夜潮汐效应(例如白天与晚间高并发,凌晨几乎无请求)。你可以保留 1~2 台实例 24 小时开机承接日常基线流量;另配 3~5 台作为“潮汐节点”。 - 善用“停机保盘”应对波谷,消除冷启动拉模型耗时:
ComfyUI 的模型库动辄一两百 GB。如果每次缩容都直接销毁实例,下次扩容时重新拉取百 GB 权重不仅耗时,还会产生不必要的重复流量。在 实例管理 中,对潮汐节点执行 “停机(Stop)” 操作后,算力费立即停止计费,仅按 GB/月收取低廉的磁盘存储费,而机器内的百 GB 模型、插件与环境完好保留。等第二天流量高峰到来前,一键启动即可快速恢复 API 吞吐能力。 - 磁盘容量前置规划与销毁防呆:
由于平台不支持实例创建后动态扩容磁盘,也不支持创建后增删端口映射,在初始化生产 Worker 时,请务必根据模型总体积预留充足的磁盘空间(建议预留 30% 以上余量供临时输出文件与 aaPanel 使用)。同时,平台不备份用户磁盘数据,执行销毁(Destroy)操作需输入实例编号二次确认,一旦销毁磁盘立即释放且不可恢复——因此,核心工作流 JSON 与自研节点代码请务必通过 Git 仓库或外部对象存储做好同步备份。
结语:从今天开始搭建你的弹性视觉生成引擎
当 AI 图像与视频生成迈入多模型协同、深水区定制的阶段,谁能更快地把最新开源成果转化为稳定、低成本的 API 服务,谁就能在产品迭代中占据绝对主动。无需繁琐的实名认证与配额申请,现在就通过邮箱注册 NexGPU 快速上手,挑选一台高带宽、高可靠性的 ComfyUI云GPU 节点,把你的节点工作流真正变成驱动业务增长的生产力引擎。
(注:若您的团队有大规模长期并发需求,需要评估 RDMA 高速互联、私有网络隔离、预留实例或包月包年对公采购方案,欢迎直接联系 NexGPU 销售团队获取定制支持。)


