 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
在 AI 领域,DeepSeek 模型的迭代速度不断刷新开发者们的认知。然而,随着项目从本地验证走向生产交付,很多团队发现最大的瓶颈并非模型能力,而是如何在高昂的算力成本与服务稳定性之间找到平衡点。
部署的“下半场”:从“能跑通”到“算得起”
如果说早期 DeepSeek 部署的热点是“如何快速拉起服务”,那么现在的核心课题则是“如何在保障高并发的同时,精准控制 ROI”。当你的业务规模化时,固定的硬件投入往往意味着巨大的资源闲置浪费。此时,NexGPU 的 GPU 市场所推崇的“按小时计费、秒级计量”模式,正成为开发者们的新宠。
选对卡,是降本的第一步
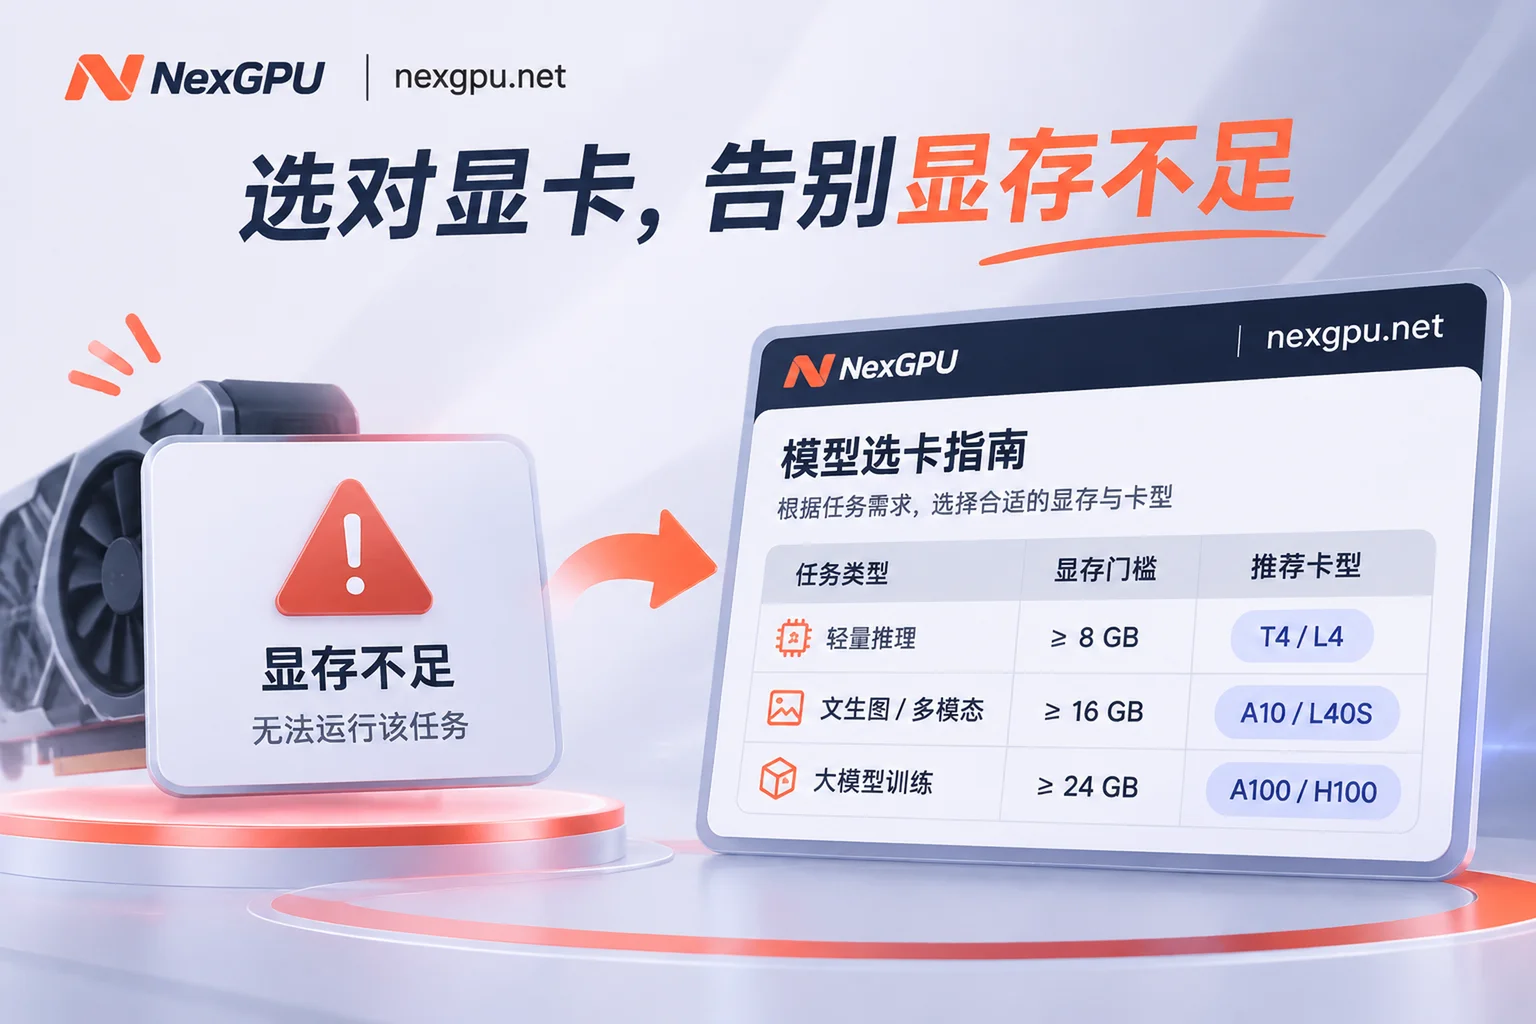
面对不同版本的 DeepSeek 模型,显存门槛往往是第一道“鬼门关”。盲目追求顶配 H200 可能造成严重的资源浪费,而显存不足又会导致推理报错。
NexGPU 提供了一个极具参考价值的 模型选卡指南,针对各类主流开源模型,直接给出了量化后的显存门槛和推荐卡型。通过对比消费级(如 RTX 4090/5090)与数据中心级(如 A100/H100)的单价与性能,你可以为推理任务制定最精简的硬件配置。
告别繁琐,镜像即开即用
很多开发者在部署时会耗费大量时间在 CUDA 环境配置、驱动兼容性排查上。NexGPU 的 镜像模板 功能,将这些繁琐的工程动作彻底“抽象”化了。无论是想要快速拉起 OpenAI 兼容接口的 vLLM、Ollama,还是进行深度微调的 LLaMA Factory,只需一键加载预置环境,开机即用。
此外,对于有特殊 CUDA 版本依赖的开发者,NexGPU 同样支持导入自定义 Docker 镜像,确保生产环境的高度可控性。
弹性与控制:你的算力,你做主
在最近的分析文章中,我们提到过算力账单的拆解。在 NexGPU 的实例管理中,这种透明度被提升到了极致:
- 成本透明: 算力、存储、流量三项分明,实例停机即停止算力计费,真正实现“用多少付多少”。
- 环境持久: 停机保留磁盘,数据不丢失,需要时随时重新启动。
- 极简运维: 内置网页终端、SSH 直连及一键安装的可视化面板,让远程管理如在本地操作般丝滑。
对于需要构建超大规模推理集群或处理高并发业务的团队,NexGPU 也提供了 多卡节点与企业方案,通过支持 DeepSpeed、FSDP 等架构,帮助你从单机推理平滑过渡到万卡级集群。
总结
DeepSeek 的部署不应成为创作者与初学者的负担。通过 NexGPU 官网 提供的灵活性与高性价比算力,你可以将更多精力聚焦于模型本身的效果调优,而非底层的硬件维护。
现在就开始评估你的算力需求,参考 场景做法页 寻找适合你的方案,开启高效的 AI 生产力之旅。


