 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
随着 Qwen3、DeepSeek-R1、Llama 4 等新一代开源模型权重迭代,以及企业本地 AI Agent(智能体)在工具调用、结构化输出和垂直领域话术上的落地推进,越来越多研发团队和独立开发者发现:仅靠提示词工程或通用 RAG 很难让模型严格遵守复杂的业务格式,针对特定场景做指令监督微调(SFT)或偏好对齐(DPO、GRPO)依然是刚需。
但在真正启动训练前,横在面前的第一道坎往往是硬件:大模型微调 GPU 到底该怎么选? 选小了,跑起来瞬间触发 CUDA Out of Memory (OOM);盲目上高配多卡,又可能让大量的显存和算力预算白白空转。
观察近期站内读者常看的文章,我们已经聊过不少推理阶段的并行与选卡(例如《48GB显存能跑多大的模型?推理与微调的精度和上下文边界》)。今天我们专门把镜头对准训练与微调环节,按“算清显存账 → 选定微调方法 → 匹配开源框架与硬件”三步,帮你找到性价比最高的用卡方案。
第一步:为什么微调比推理吃显存?先算清四笔显存账
很多初次尝试微调的开发者容易按推理的经验去估算硬件:觉得一个 7B/8B 模型用 FP16 加载只要 14GB~16GB 显存,拿一张 16GB 或 24GB 的卡就能随便训。结果训练脚本一跑,第 1 个 Step 还没走完就直接爆显存。
原因在于,推理只需要把模型权重和 KV Cache 放进显存;而微调是一个“前向传播算 Loss + 反向传播算梯度 + 优化器更新权重”的闭环,显存里必须同时装下四样东西:
- 模型权重(Model Weights):以 FP16/BF16 精度加载时,每个参数占 2 字节;4-bit 量化加载时,每个参数约占 0.5~0.7 字节。
- 梯度(Gradients):与可训练参数量挂钩。如果做全量微调,梯度的体积和 FP16 模型权重一样大(2 字节/参数);如果做 LoRA,则只需保存旁路低秩矩阵的梯度。
- 优化器状态(Optimizer States):这是全参数微调最大的“显存刺客”。主流的 AdamW 优化器需要为每个可训练参数保存一阶动量、二阶动量以及主权重备份,在混合精度训练下通常要吃掉 12 字节/参数 左右的空间。
- 激活值(Activations)与临时缓冲:前向传播中为了反向求导必须暂存的中间结果。它不仅和模型层数有关,还与 Batch Size(批次大小) 和 序列截断长度(Cutoff Length / Max Seq Length) 呈正相关——微调长文档或复杂多轮 Agent 轨迹时,激活值往往会成倍膨胀。
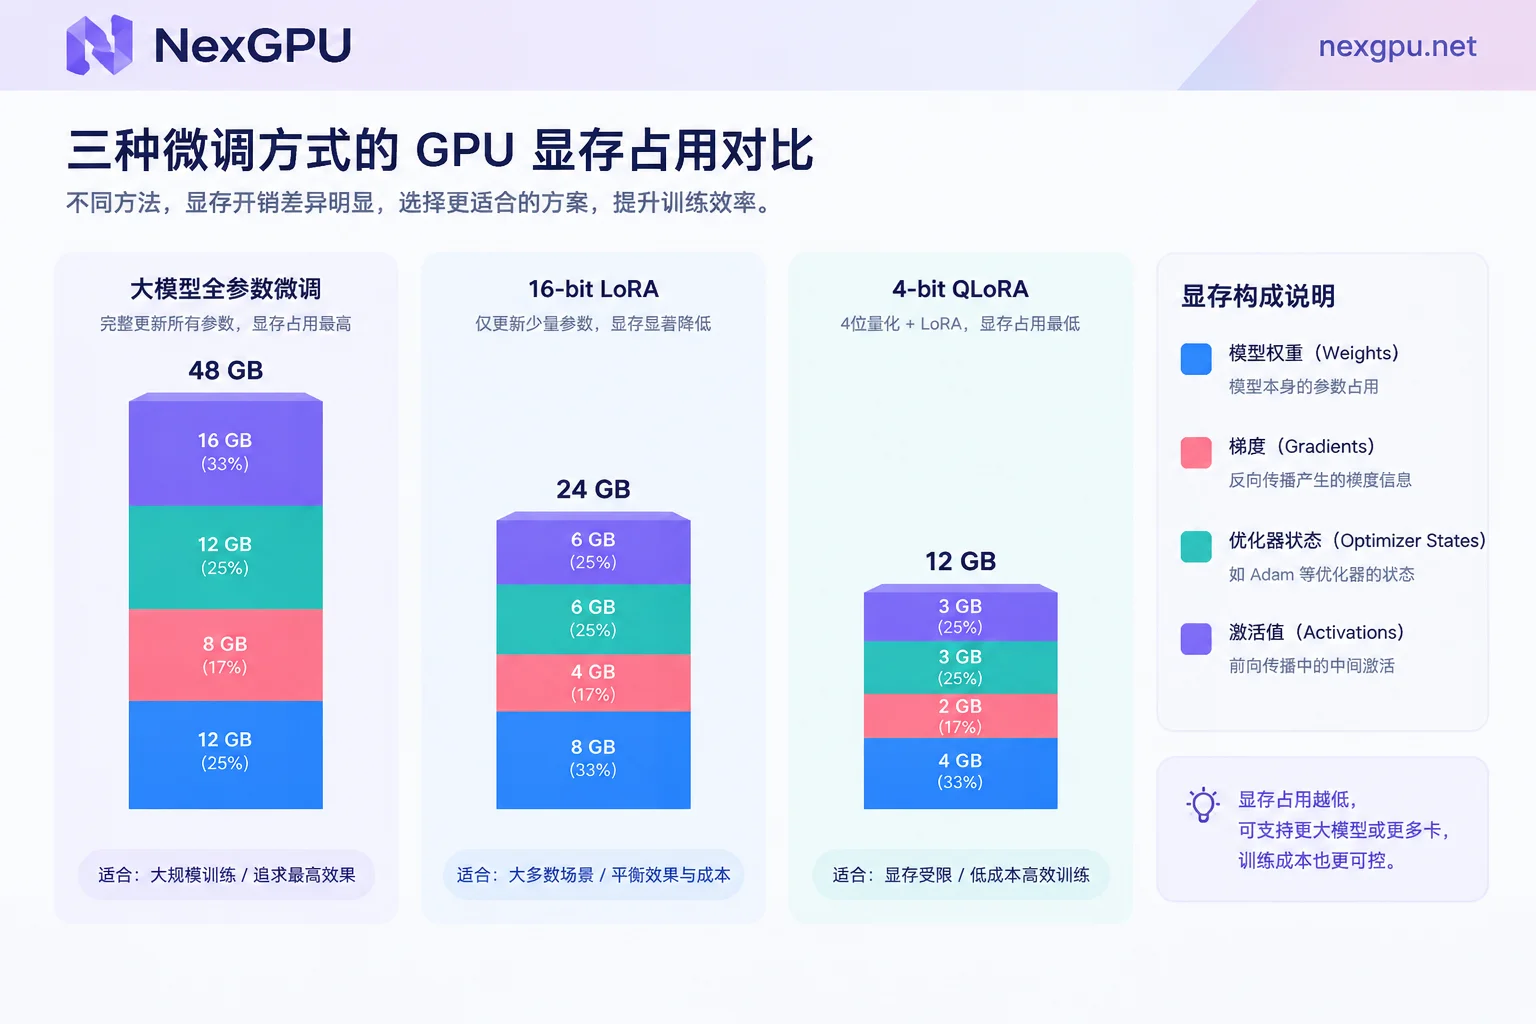
换句话说,全参数微调一个模型,每 1B 参数大约需要 16GB~18GB 的基础显存(2 字节权重 + 2 字节梯度 + 12 字节优化器 + 激活值余量)。哪怕只是全量微调一个 8B 模型,门槛也在 130GB 以上,单张消费级显卡根本无法承受。这也是为什么先定“微调方法”,才能定“租什么 GPU”。
第二步:QLoRA、LoRA 还是全参微调?对照显存门槛选卡
在 Hugging Face 的开源微调生态中,超过 80% 的微调任务都在使用 LoRA 或 QLoRA 等参数高效微调(PEFT)技术。不同微调路线对显卡的诉求截然不同,我们可以按模型体量与微调方式画出一条清晰的选卡分界线:
| 微调方法 | 核心机制 | 7B / 8B 模型显存门槛 | 14B / 32B 模型显存门槛 | 70B+ 模型显存门槛 | 典型适用场景与推荐 GPU 级别 |
|---|---|---|---|---|---|
| QLoRA (4-bit) | 冻结底座并量化为 4-bit,仅训练极小比例的旁路适配器 | 6GB ~ 10GB | 14B 约 14GB;32B 约 22GB~24GB | 约 40GB ~ 48GB | 快速跑通 PoC、固定输出格式、预算有限的单卡实验;适合 RTX 3090 / 4090 / 5090 |
| LoRA (16-bit) | 底座保持 FP16/BF16 不量化,训练旁路低秩矩阵 | 16GB ~ 22GB | 14B 约 32GB;32B 约 65GB~75GB | 约 150GB ~ 160GB | 垂直行业话术适配、多模态微调、追求更高收敛精度;8B 适合 24GB 消费卡,32B+ 适合 A100 / H100 |
| 全参数微调 (Full) | 更新模型所有权重,显存开销约为参数量的 16~18 倍 | 130GB ~ 160GB | 32B 约 500GB+ | 1,200GB+ | 注入大量全新领域知识、持续预训练(CPT);必须上 A100 / H100 / H200 / B200 多卡节点 |
注:以上显存估算基于常见上下文长度(2K~4K)与较小 Batch Size(配合梯度累积)。若需微调 32K 以上长序列或大 Batch,需额外预留激活值显存。各模型的具体版本与量化显存门槛,可直接查阅 NexGPU 模型选卡指南(例如 Qwen 模型选卡与部署页)。
结合这张表,选卡时有两条非常实用的工程经验:
- 第一,16GB/24GB 显存是单卡微调的黄金甜点区,但别硬塞超大底座。 用一张 24GB 显存的消费级显卡(如 RTX 3090 或 RTX 4090),跑 8B 模型的 16-bit LoRA 非常从容,跑 14B~27B 模型的 QLoRA 也能塞下。但如果你发现为了塞进更大模型,不得不把
per_device_train_batch_size压到 1、把截断长度砍到 512,甚至想靠单卡开启 DeepSpeed ZeRO-3 CPU Offload 来救场,往往会遇到通信拖慢甚至算子崩溃的坑。关于何时该果断升级硬件,可以参考《消费级显卡什么时候不够用:四条越界信号和换卡的判断口径》。 - 第二,从 SFT 走向 RLHF(DPO / GRPO)时,记得给参考模型留余量。 做 DPO 偏好对齐或 GRPO 强化学习微调时,除了正在训练的策略模型,显存或计算链路里往往还需要处理 Reference Model(参考模型)的逻辑或多次采样生成,显存水位会比单纯跑 SFT 高出一截。此时直接租用单张 80GB 显存的数据中心卡(如 A100、H100),或者租用多卡节点,远比在单张小显存卡上极限抠字眼省时间。
第三步:三大主流微调框架怎么搭?选对镜像省去配环境折腾
算清了显存,接下来就是选工具。当前开源社区里,LLaMA Factory、Unsloth 和 Axolotl 已经形成了三足鼎立的成熟生态。它们不仅决定了你的操作方式,也直接影响你租用 GPU 时的机器挑选策略:
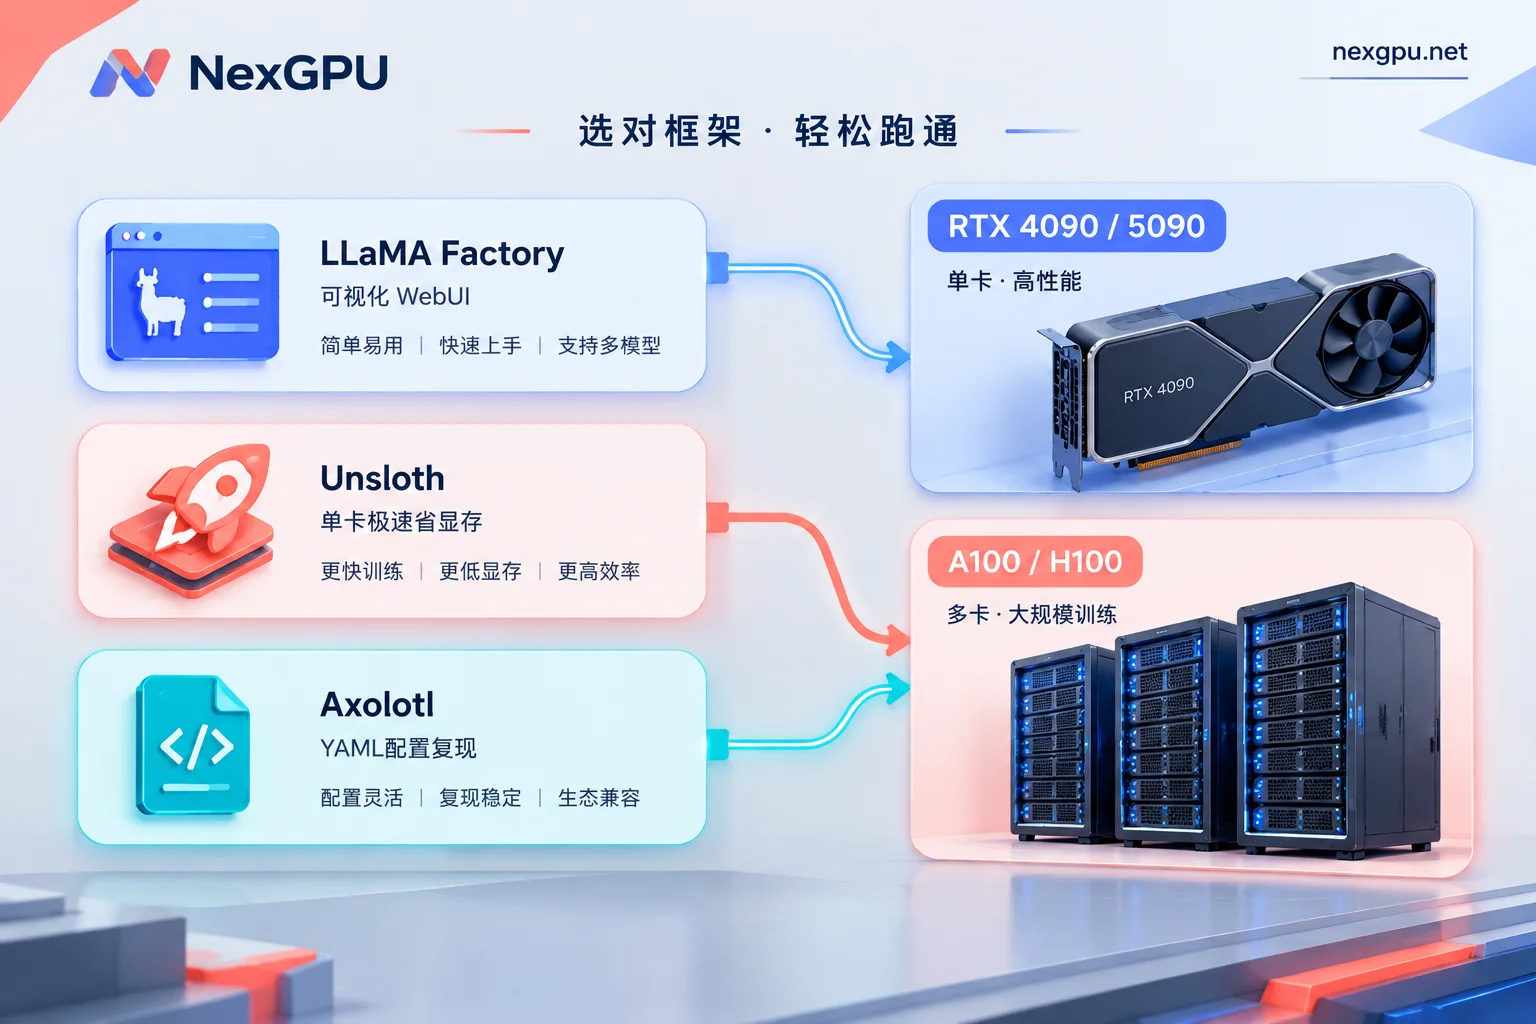
1. LLaMA Factory:零代码 WebUI 与全模型覆盖,新手与企业通吃
- 框架特点:支持 100+ 主流文本与多模态大模型,内置 LlamaBoard 可视化网页界面,点点鼠标就能完成数据集加载、LoRA/QLoRA 参数配置、SFT/DPO/KTO 训练监控以及导出评测。
- 怎么配 GPU:如果是第一次微调,强烈建议用 LLaMA Factory + 8B 模型 + 单张 RTX 4090/5090,先拿 10% 的样本在 WebUI 里把数据格式和 Loss 曲线跑通;如果是团队做多模型矩阵对比或 32B/70B 级别的分布式微调,LLaMA Factory 也能无缝对接 DeepSpeed,直接租用多卡 A100/H100 节点即可。
2. Unsloth:手写 Triton 内核的“省显存与加速狂魔”
- 框架特点:通过底层重写 CUDA/Triton 算子并手动推导反向传播,Unsloth 能在 0 精度损失的前提下,把微调速度提升约 2 倍,同时将显存占用削减 70%~80%。此外,LLaMA Factory 现已支持将 Unsloth 作为内置加速后端一键开启。
- 怎么配 GPU:当你手里预算有限,或者想在单张 24GB 显卡(RTX 3090/4090)上挑战更长上下文、更大参数量(如 14B/27B QLoRA)时,Unsloth 是把单卡硬件压榨到极致的利器。
3. Axolotl:YAML 配置驱动,适合严肃实验与分布式复现
- 框架特点:完全靠一份 YAML 配置文件管理数据预处理、打包(Multipack)、微调超参数与 FSDP/DeepSpeed 策略,可审计性极强,深受需要严格复现实验结果的算法工程师青睐。
- 怎么配 GPU:非常适合跑在多卡 RTX 4090 节点或 A100 / H100 / H200 数据中心多卡节点上,进行长周期的领域知识注入或持续预训练。
在实际操作中,很多人还没开始训模型,就先在本地或裸机上被 CUDA 版本不匹配、FlashAttention-2 编译失败、bitsandbytes 报错 折磨了大半天。在 NexGPU 上,你可以直接跳过这一步:
打开 镜像模板(Templates),在“训练与微调”分类下,平台已经为你预置好了 LLaMA Factory、Unsloth、Axolotl 以及原生 PyTorch、TensorFlow、JAX 等开机即用的环境镜像,底层驱动、CUDA 和核心依赖全部预装就绪。如果你的项目代码严格锁定了特定的 CUDA 或内部依赖版本,也支持直接填写你自己的公开或私有 Docker 镜像仓库地址,并自定义启动命令与环境变量。不知道具体场景该怎么搭?还可以先去 AI 微调等场景做法页 看看推荐的显存、卡型、镜像与大致预算。
第四步:在 NexGPU 上跑微调,怎么把算力成本压到最低?
微调不同于 7×24 小时在线的推理服务,它是一种典型的脉冲式、阶段性负载:洗数据、调参数、跑几个 Epoch、测效果、再改数据。针对这种节奏,善用平台的选卡和计费机制,能帮团队省下一大笔预算:
1. 先选微调环境,再让系统帮你“排雷”筛卡
进入 NexGPU 算力市场(选卡操作详见《如何选择 GPU》文档),每一行都是一台真实可租的物理机器,消费级(RTX 3090、4090、5090 等)与数据中心级(A100、H100、H200、B200 等)分开列价,算力单价和磁盘单价一目了然。
更省心的是,当你先选定微调镜像或模型环境再去筛机器时,显存不够的机器会被自动标出并注明原因,从源头避免租错卡导致 OOM。你可以按显存大小、价格、地区、可靠性和网络带宽自由筛选。
2. 善用 Jupyter、SSH 直连与备用端口看看板
实例拉起后(支持邮箱直接注册,无需繁琐的实名认证和配额审批,详见快速上手指南),你可以按习惯选择连接方式(详见《连接实例》文档):
- 喜欢交互式调试数据集和 Notebook 的,直接一键打开已带好令牌的 Jupyter,或者使用浏览器里的 网页 root 终端;
- 习惯用本地 VS Code Remote 写代码的,直接用公网 IP 加端口走 SSH 直连(不经跳板机,支持配置默认公钥);
- 跑 LLaMA Factory WebUI、TensorBoard 或 SwanLab 监控 Loss 曲线时,每台实例除了默认映射外,还专门预留了一组备用端口供你暴露自己的 Web 服务;如果想在浏览器里直观管理微调数据集文件和进程,还可以一键安装可视化管理面板(aaPanel)。
3. 吃透“停机保盘”与“销毁停费”的计费规则
微调过程中经常需要暂停训练去清洗下一批数据,或者开会讨论评测结果。在 NexGPU 的计费体系中,账单只有算力、存储、流量三项,没有最低消费、开通费或起租时长,且下单时的单价会一直锁定到该实例销毁:
- 算力费按秒计量、按小时计价:实例进入“运行中”才开始算钱,只要点击“停机”,算力计费立刻停止,同时磁盘里的模型权重和数据集完好保留,下次随时开机接着训;
- 存储费按 GB/月计:从实例创建起算,停机期间因为占着磁盘仍会照收存储费,只有销毁实例才会彻底释放磁盘并停止所有计费(关于停机与销毁的详细账单逻辑,强烈建议顺手读一下站内的《GPU 实例关机还收不收费?算力停了,存储还在计》和《租的 GPU 实例数据怎么保存:停机保盘、销毁清空与三条外移路线》)。
因此,最省钱的微调姿势是:创建实例时按数据集和 Checkpoint 的总大小留足磁盘空间(注意实例创建后不支持中途扩容磁盘),小批量调试时随时停机省算力费;等最终的 LoRA 权重训练完毕、合并导出并备份到外部对象存储或 Hugging Face 后,输入实例编号确认销毁(平台采用独占容器,不读取也不备份磁盘,销毁即彻底清空),做到一分钱多余的存储费都不花。
结语:从单卡验证到多卡集群,按阶段平滑演进
总结下来,大模型微调选 GPU 并不需要盲目跟风堆硬件:
- 跑通流程与风格微调(7B~14B):选 LLaMA Factory 或 Unsloth 预置镜像,租一台 RTX 3090 / 4090 / 5090 跑 LoRA/QLoRA,几顿快餐的算力成本就能拿到专属模型;
- 微调完立刻验证效果:可以无缝切到平台的 vLLM、SGLang、TGI 或 Ollama 推理镜像,拉起 OpenAI 兼容接口做 AB 测试;
- 中大型模型全参微调与多卡训练(32B~70B+):在 GPU 市场按“最少卡数”筛选 A100、H100、H200、B200 多卡整机节点(整机出租,下单金额 = 单卡价 × 卡数),直接跑起 DeepSpeed、FSDP 或 Megatron 分布式训练。
如果你的企业或实验室需要长期稳定的微调算力池、RDMA 高速互联多机集群、私有网络数据隔离,或是需要预留实例、包月包年、合同对公付款与开票、PO 采购,也欢迎整理好需求(可参考《企业GPU集群和预留实例怎么咨询:先备好这份需求清单再联系》),直接通过 联系销售页面 与我们的团队对接。
现在就去 NexGPU 镜像模板页 挑一个顺手的微调框架,开启你的第一次低成本模型定制吧!


