 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
模型拆到多张卡上时,选张量并行(TP)还是流水线并行(PP),主要看两件事:模型能不能在一张卡上装下,以及卡与卡之间用什么连接。先给结论:
- 一张卡装得下就不要拆。判断标准是权重加上下文 KV Cache 之后,显存还剩 20%–30% 余量。需要扛更多并发时,开多个单卡实例做数据并行,不必引入任何模型拆分的开销。
- 单机多卡、卡间有 NVLink:优先用 TP,PP 设为 1。
- 单机多卡只有 PCIe,或者需要跨机器:如果显存确实非拆不可,而且请求并发持续较高,考虑用 PP。
- 模型大到一台机器装不下:机内用 TP,跨机用 PP,这是大模型部署和训练的常见组合。
下面分别解释这几条判断的依据,以及动手前要确认的几件事。
两种并行分别切在哪里
张量并行是层内切分。它把每一层里注意力和 MLP 的权重矩阵按行或按列拆开,每张卡算其中一块。每算完一层,各卡都要做一次 All-Reduce 之类的集合通信,把结果合起来。层数越多,通信次数越多,而且每次都要等最慢的那张卡。
流水线并行是层间切分。它把模型按层分成几个连续的阶段(stage),比如前 20 层放第一张卡,后 20 层放第二张卡。卡与卡之间只在阶段边界传递一次激活值,属于点对点通信,传输量和频次都比 TP 低得多。代价是请求必须按顺序依次经过每个阶段,前面的阶段在算时,后面的阶段可能空着等,这段空闲就叫「气泡」。
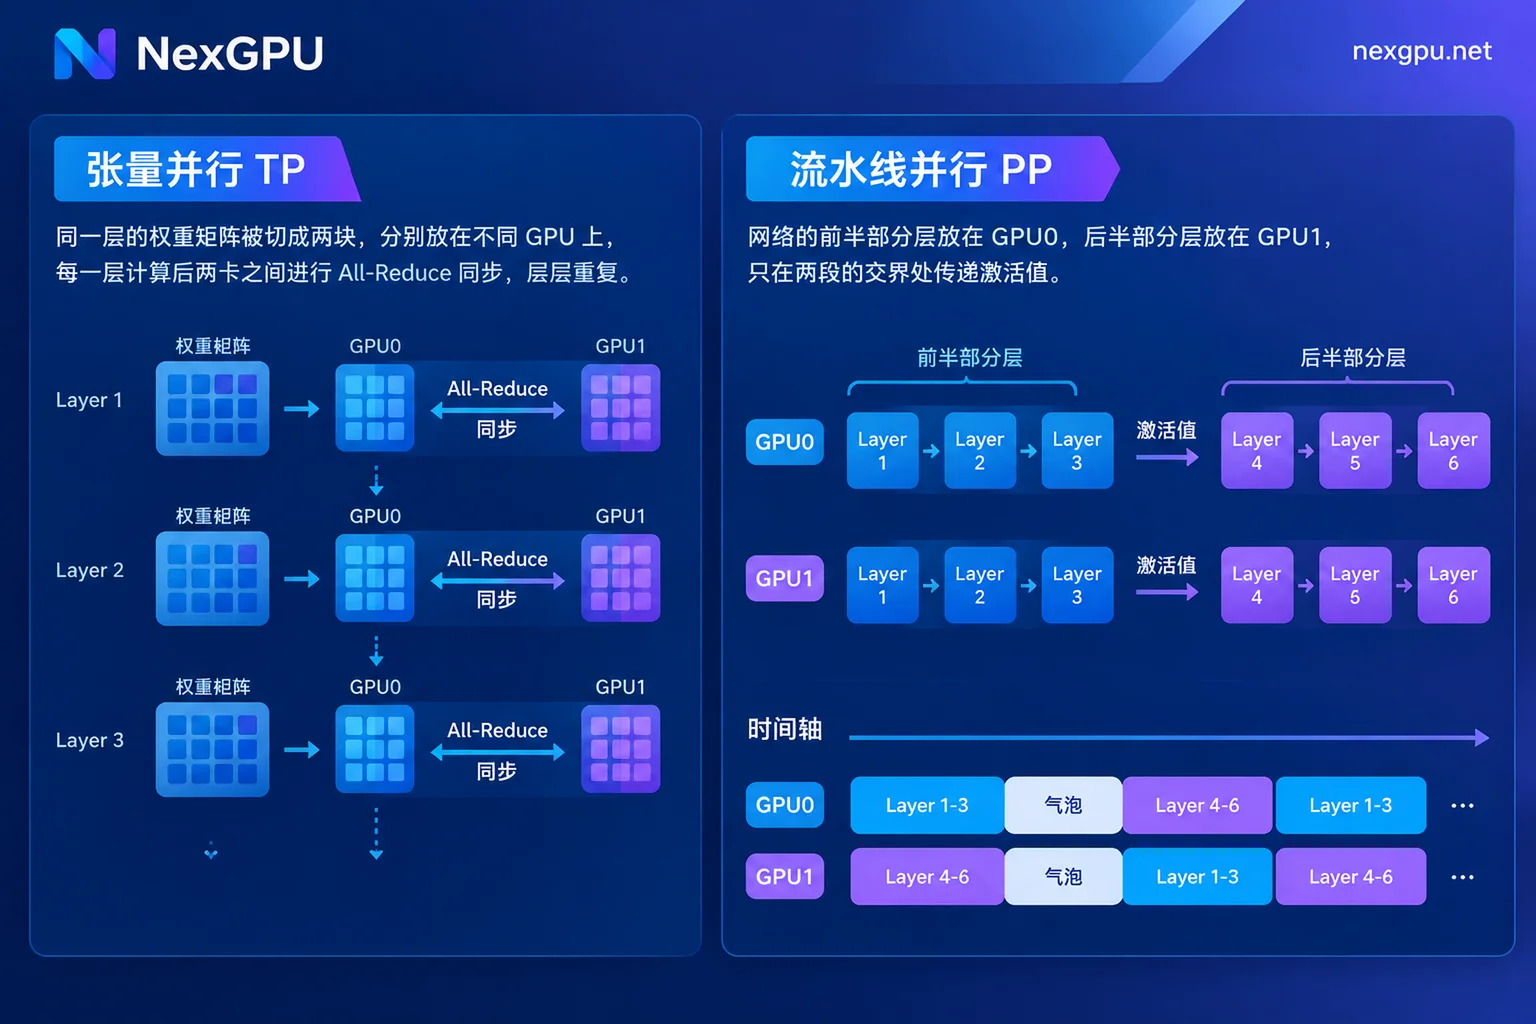
后面的选择都由这一个差别决定:TP 通信多且频繁,所以很依赖互联带宽;PP 通信少,但单个请求无法同时用上所有卡。
延迟优先还是吞吐优先
TP 让多张卡同时计算同一个请求的矩阵运算,首 token 时间和每个 token 的解码延迟都会下降。在线对话、交互式应用、并发不高但要求响应快的场景,TP 更合适。
PP 不会让单个请求变快,阶段之间的传递和排队反而会增加一点延迟。它要靠连续批处理(continuous batching)和足够多的并发请求,把每个阶段都同时填满,才能摊薄气泡。所以在低并发场景用 PP,常见的结果是显存问题解决了,但卡之间一直在轮流等待,利用率上不去。
简单说:并发低、看重延迟,选 TP;并发高、看重总吞吐,而且互联条件一般,PP 更有优势。
动手前先确认卡间连接
这一步最容易被跳过,却往往直接决定选型结果。进入多卡机器后执行:
nvidia-smi topo -m输出是一个 GPU 两两之间的连接矩阵。显示为 NV1、NV2 等带 NV 前缀的格子,表示两张卡之间是 NVLink;显示为 PIX、PXB、PHB、NODE、SYS 的,表示走 PCIe,其中 SYS 意味着还要跨 CPU 插槽,延迟更高。消费级显卡组成的多卡机器,大多属于 PCIe 互联。
TP 最适合的环境,是单机内用 NVLink 或 NVSwitch 互联的 2、4 或 8 卡。在 PCIe 或跨机网络上跑 TP,程序能启动,但卡数越多,通信占用的时间比例越高,GPU 容易空等算力。PP 对带宽的要求宽松得多,在 PCIe 单机或普通跨节点网络上都能稳定运行。
如果拿不准,就用同样的请求负载,分别测一组 TP 配置和一组 PP 配置,再对比延迟和吞吐。
并行度受模型结构约束
并行度不能随意设定,打开模型目录下的 config.json 核对两点:
- TP 的大小要能整除注意力头数(
num_attention_heads)和 KV 头数(num_key_value_heads)。使用 GQA 的模型 KV 头数通常较少,这一项往往决定 TP 的上限。即使能整除,TP 设得过大也会让通信开销的增长超过计算节省,收益递减。 - PP 的大小受总层数(
num_hidden_layers)限制,各阶段的层数要尽量均衡。层数分得不均时,层数多的阶段会成为整条流水线的瓶颈,其他卡只能等它。
具体该设成几,可以参考推理并行度设成多少合适,那篇按「先用显存确定最小 TP,再看互联和业务目标」的顺序逐步推导。
在 vLLM 里怎么配置
单机 4 卡且有 NVLink,只用 TP:
vllm serve <模型路径> --tensor-parallel-size 4单机 4 卡只有 PCIe,且并发较高,可以试 TP 和 PP 混合,或者纯 PP:
vllm serve <模型路径> --tensor-parallel-size 2 --pipeline-parallel-size 2
vllm serve <模型路径> --pipeline-parallel-size 4
第一种写法适合 4 张卡两两之间有更快连接的情况,比如两对卡分别挂在同一个 PCIe 交换芯片下,可以从 topo -m 的结果判断。跨机部署时,通常把 TP 设为每台机器的卡数,PP 设为机器数量,多节点环境的搭建按 vLLM 文档配置 Ray 集群。
微调时逻辑相同,代价更明显
训练和微调同样适用这套判断,只是反向传播也要通信,TP 对带宽的要求更高。PP 在训练时把一个 batch 拆成多个 micro-batch 依次送进流水线,用来减少气泡。Megatron-LM 这类框架的常见做法是机内 TP、机间 PP,再在外层叠加数据并行,也就是常说的 3D 并行。
如果只是对中小模型做 LoRA 之类的轻量微调,先确认单卡是否够用。单卡能完成的任务,拆分只会增加复杂度。
上线后吞吐不对,先排查这三项
多卡部署后吞吐没有明显提升,常见原因有三类:在 PCIe 上跑了较大的 TP、在低并发场景用了 PP、各阶段负载不均。可以按多卡推理吞吐没有翻倍的三步排查逐项检查。
租多卡节点时要留意的几点
同样是「4 卡」,不同节点的卡间连接可能完全不同,而这直接决定 TP 是否划算。在 NexGPU 选多卡节点时,先在价格与可租节点页查看节点规格。规格里没有写明互联方式的,开机后第一件事就是运行 nvidia-smi topo -m 确认。
NexGPU 按小时计费、按秒计量,可以先开一台短时实例,把 TP 和 PP 两种配置各测一遍再决定。测完注意区分停机和销毁:停机后仍会收取存储费,销毁后才全部停止计费。如果模型需要跨机部署,或者要评估整套集群方案,可以联系销售确认可用的多机配置。


