在AI技术的演进浪潮中,我们常听到开发者面临这样的困境:从个人实验室的“一张显卡跑模型”到企业级的“大规模分布式训练与推理”,中间似乎隔着一道难以逾越的算力鸿沟。当你的AI业务从Prototype(原型)迈向Production(生产环境),单一消费级显卡已不足以支撑高并发请求与庞大的模型微调参数。此时,GPU集群的搭建不仅是硬件的堆叠,更是对弹性、效...
对于大多数研发团队和独立开发者来说,“大模型训练”在过去很长一段时间里几乎等同于做一轮 LoRA 指令微调(SFT)。但到了 2026 年,行业落地的标准流水线已经发生了明显变化:开源基座模型本身已经足够聪明,真正拉开业务差距的,变成了领域持续预训练(CPT)与强化学习后训练(Post-Training,如 DPO、GRPO 与基于可验证奖励的 RLV...
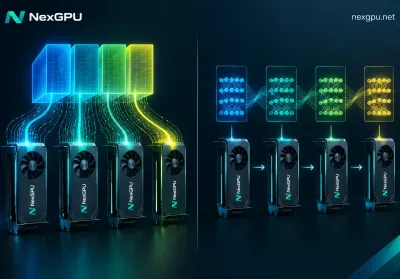
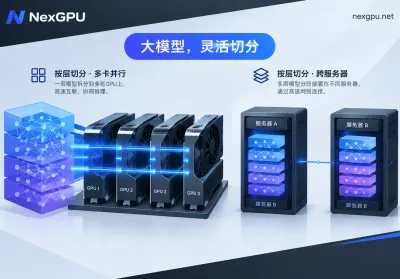
模型拆到多张卡上时,选张量并行(TP)还是流水线并行(PP),主要看两件事:模型能不能在一张卡上装下,以及卡与卡之间用什么连接。先给结论:一张卡装得下就不要拆。判断标准是权重加上下文 KV Cache 之后,显存还剩 20%–30% 余量。需要扛更多并发时,开多个单卡实例做数据并行,不必引入任何模型拆分的开销。单机多卡、卡间有 NVLink:优先用 T...
多数情况可以按这条规则选:单台机器里的多张卡,并且卡之间有 NVLink 这类高速互连,就优先用张量并行(TP);模型大到一台机器装不下、需要跨机时,机内用 TP,机器之间用流水并行(PP)。 如果模型和 KV Cache 一张卡就能装下,先别切分模型。这种情况下用单卡,或者开几个独立副本,通常更省事。下面说明这条规则的依据,以及几种需要另做判断的情况...
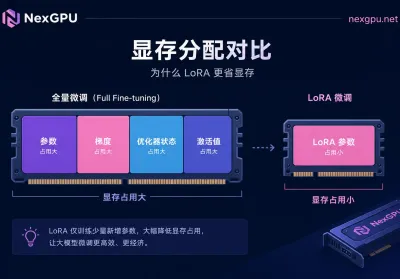
同一个 7B 模型,QLoRA 微调一张 24GB 消费级卡就能跑,全参数微调却要好几张 80GB 卡加参数切分。差别不在模型本身,而在训练时显存里到底装了几样东西。所以选卡的顺序永远是:先确定用哪种训练方式,再算显存账,最后才决定卡数和互联。四档训练方式对应的卡位先给一个可以直接对照的起点,具体到某个模型的显存门槛,官网的模型选卡指南按模型列得更细,...
 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客