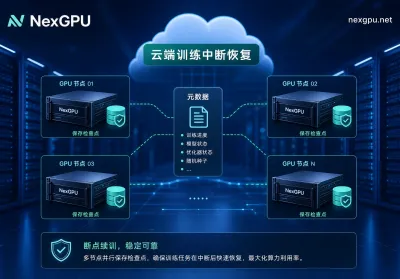
云端GPU长任务中断恢复与Checkpoint设置:4步配置

先估算两笔时间:单次保存检查点的耗时,以及中断后回退重算的耗时。把这两笔账合起来,除以平均中断间隔(MTBI),得到的就是业界通用的 Checkpointing Badput 指标。配置云端GPU长任务中断恢复与Checkpoint设置,就是把 Badput 压到可接受区间。下面按四步操作。先算两笔账:写检查点的时间与中断回退的时间在配置之前,先把中断...
Llama3 70B分布式微调算力需求:要几张卡、多少显存

先把结论摆出来:Llama3 70B分布式微调算力需求取决于微调方式和序列长度两个变量——全参数 FP16 走 FSDP/ZeRO-3 至少 4×80GB,常规配置 8×80GB;FSDP+QLoRA 4-bit 可以压到 2-4 张 24GB/48GB 中端卡;一旦序列长度拉到 8k 以上或卡间没有 NVLink,就要重新评估档位。下面直接给四档对照...

DeepSpeed多卡分布式训练踩坑指南:5步定位OOM

当你用 DeepSpeed 在 8 卡 A100 上跑大模型微调,刚启动就报 CUDA out of memory,或者训练到第 3 个 step 直接卡死不动时,别急着加显存——这篇 DeepSpeed多卡分布式训练踩坑指南按五个落点依次排查,多数问题在配置层就能解决。不过动手前有个前提:请先确认 DeepSpeed 版本。2026 年 8 月发布的...

云厂商集体提价下AI团队挑选GPU租用的4个评估维度

7月22日,云计算服务提供商 DigitalOcean 发布官方通告,宣布自8月1日起将旗下多款 NVIDIA 与 AMD 的 GPU 实例按需价格上调约 30%。其中 NVIDIA H100 80GB 的单时租金从 3.39 美元升至 4.41 美元,H200 以及 AMD MI300X 也迎来同步上涨。官方将原因归结为生成式人工智能(Generat...
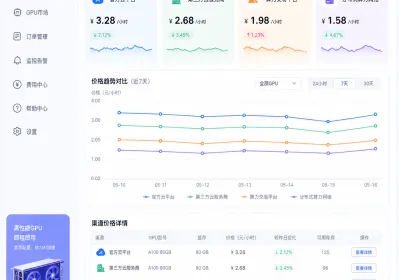
算力租赁H100报价差2.9倍:2026年7月团队破局复盘

7月中旬数据砸下来:同卡报价差近3倍上周市场上传出一组新鲜数字,直接戳中不少中小团队的痛点。有人把Azure、RunPod、Vast等几个渠道的报价程序化抓取,7月4日一天就拿到1417条观测值。H100这一行最扎眼:最低1.33美元/小时,最高3.85美元,中位数2.59美元,同日同卡差了2.9倍。H200更夸张,低到0.50高到4.39,跨度8.8...