 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
先估算两笔时间:单次保存检查点的耗时,以及中断后回退重算的耗时。把这两笔账合起来,除以平均中断间隔(MTBI),得到的就是业界通用的 Checkpointing Badput 指标。配置云端GPU长任务中断恢复与Checkpoint设置,就是把 Badput 压到可接受区间。下面按四步操作。
先算两笔账:写检查点的时间与中断回退的时间
在配置之前,先把中断损失拆清楚。你真正损失的算力时间由两部分组成:写检查点占用的训练时间(包括同步阻塞或异步延迟),以及中断后从上一个检查点回退重算的时间。PyTorch 官方把两者合并为 Checkpointing Badput,即“检查点写入耗时 + 恢复时计算回退耗时”占整体平均中断间隔(MTBI)的百分比。MTBI 指两次中断之间的平均时间,抢占式实例可能只有几小时,独占稳定节点则可能以天计。(PyTorch 官方博客《Distributed Checkpoint》,https://pytorch.org/blog/distributed-checkpoint/)
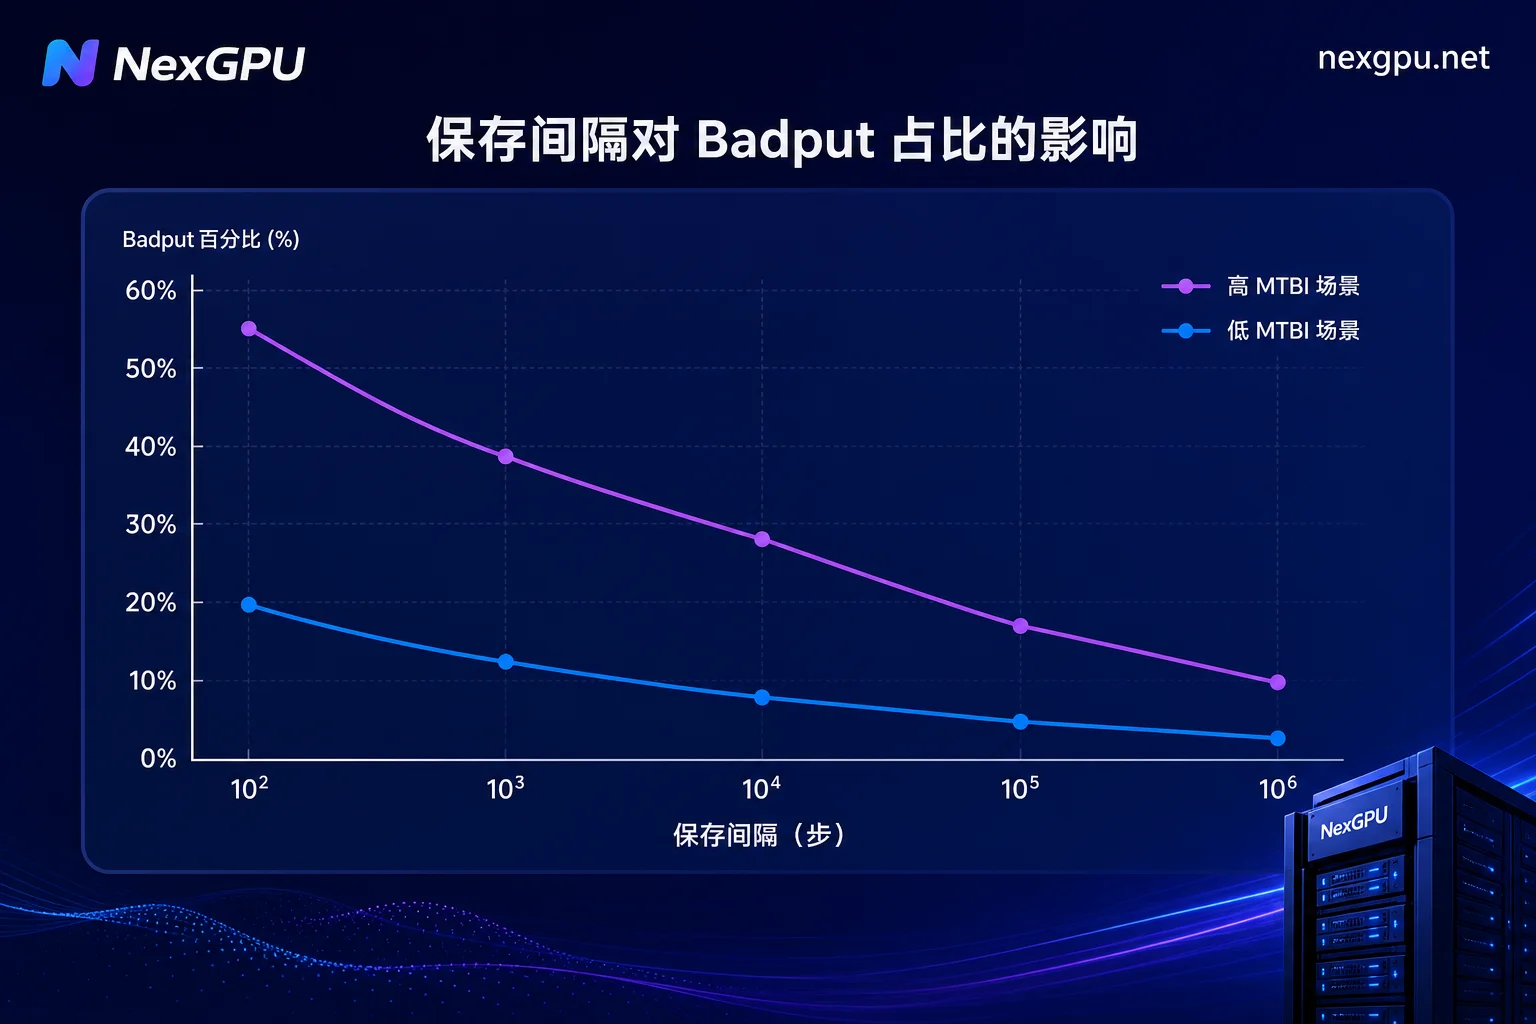
理解了 Badput,你就知道为什么“多久存一次”不能拍脑袋:存太频繁,写检查点的时间占比上升;存太稀疏,中断后回退重算的时间膨胀。
为什么单 Rank 汇总保存在多卡长任务上会越来越慢
很多团队还在用 torch.save 把权重汇总到 rank0 再写盘。这种单 Rank 汇总方式在卡数增多、模型变大后问题明显:所有分片要经过通信汇聚到一个进程,汇总通信量随模型大小线性增长;串行写盘期间,训练主路径被阻塞;保存耗时随模型参数膨胀。踩过这些坑的团队可以参考 DeepSpeed多卡分布式训练踩坑指南。
PyTorch Distributed Checkpoint (DCP) 采用 Fully Parallel Saving (FPS) 架构,每个 GPU Rank 并行向独立分片写出权重与优化器状态,并附带记录全局张量布局的元数据文件。官方口径下,保存时间随 Rank 数量成 1/N 线性收敛,并且支持在恢复时跨不同 GPU 拓扑重新切分(Re-shard)。
第一步:选保存机制——并行分片保存与元数据文件各解决什么问题
配置云端GPU长任务中断恢复与Checkpoint设置,第一步是确定保存机制。建议直接用 PyTorch DCP 的 Fully Parallel Saving,而不是 torch.save。DCP 的核心架构是每个 Rank 并行写自己的分片,同时产生一个元数据文件,记录全局张量如何分布在各个分片中。每个检查点目录内包含一个记录全局张量布局的元数据文件,以及各 Rank 写出的分片文件;具体文件命名以你所用 PyTorch 版本的实际产物为准。
建议同时保存权重与优化器状态。只存权重无法恢复 Adam 动量,恢复后训练质量会下降。分片保存可同时存两者,代价是体积翻倍。若只存权重,需评估是否可接受优化器状态重建。
落地动作:把检查点从 torch.save 迁移到 torch.distributed.checkpoint,确认每个 Rank 的保存路径独立且可并行写入。
第二步:定保存频率——按平均中断间隔与单步耗时反推档位
第二步“多久存一次”没有万能答案,需要你实测两个数:业务实例的平均中断间隔(MTBI)和单步训练耗时。然后按 Badput 目标反推保存间隔步数。
官方只给出 Badput 的定义口径,下面的推导式是本文按平均回退步数 N/2 做的简化估算,用于定档位、不用于对外报数。
公式:
- 假设单步耗时 T(秒),保存间隔 N 步,则两次保存之间的训练时长为 N*T。
- 中断发生在保存点之后任意时刻,平均回退步数约 N/2。
- 回退耗时约 (N/2)*T,再加上一次保存耗时 S。
- Badput ≈ (S + (N/2)*T) / MTBI。
先给自己定一个可接受的 Badput 上限(例如 5%,该阈值由业务成本容忍度决定,非官方推荐值),再按上述公式解出 N 的上限。注意抢占式实例的 MTBI 短,所以要加密保存;独占稳定节点可以放宽。
落地动作:先跑 24 小时收集实例中断时间戳,估算 MTBI,再按公式算保存间隔步数。
第三步:开异步写盘与保存计划缓存,把写检查点挪出训练主路径
确定了保存机制和频率后,第三步是开启异步写盘与 Save Plan Caching。引入这两项机制后,背景检查点处理耗时缩短高达 6.5 倍(Databricks 工程博客与 PyTorch 官方联合口径,https://www.databricks.com/blog/fast-fault-tolerant-pytorch-training-ai-runtime)。
- Save Plan Caching:复用已经计算好的分片保存计划,避免每次保存都重新推导张量分布。
- 独立进程异步写盘:把检查点序列化与写盘放到后台进程,避免 GIL 争用阻塞训练主线程。
异步写盘并非零成本:你需要暂存检查点副本(显存或内存),可能触发 GPU Out of Memory显存溢出解决方法。且写盘未完成时若发生崩溃,可能拿到不完整的检查点。建议先写临时目录,全部写完再原子重命名。
落地动作:在训练脚本中开启 DCP 的异步保存模式,并监控后台写盘完成延迟。
第四步:恢复演练——8卡存的检查点怎么在4卡上接着跑
云端GPU长任务中断恢复与Checkpoint设置里,按量与抢占式场景最独特的问题是:8 卡训练保存的 checkpoint 能在 4 卡上恢复吗?答案是:能,但前提是元数据完整、逻辑全局张量一致。DCP 基于元数据中的全局张量布局做 Re-shard,恢复时可更换 GPU 数量与并行切分策略。
恢复时需同步调整:
- 梯度累积步数:全局 batch size 变化时,为保证等效 batch,需调整累积步数。
- 学习率调度步位:如果学习率按全局步数衰减,恢复后要继续用原来的步数计数器。
- 优化器状态与 RNG/数据加载进度:建议在检查点中额外保存 RNG 状态和数据加载器的 shuffle 种子,保证数据顺序可复现。
恢复演练流程:
- 用 8 卡训练到第 1000 步,保存检查点。
- 主动模拟中断(例如直接终止进程)。
- 启动 4 卡训练脚本,加载同一检查点,指定 world_size=4。
- 对比恢复后前若干步的 loss 与 grad norm 是否与中断前处于同一量级、无突跳,而不是要求逐位数值一致——换卡数后归约顺序变化会带来正常的数值差异。
- 记录恢复后的稳定吞吐,可参考 GPU利用率优化。
请注意,Re-shard 不是无条件成功的。它依赖元数据完整和逻辑全局张量一致,若切分策略变更时没有正确调整超参,可能出现局部不收敛。务必先在小规模任务上演练。
按量与抢占式实例的额外配置:存储路径、重连与自动重启顺序
云端按量与抢占式 GPU 的成本优势能否兑现,取决于中断恢复是否足够轻量。以 NexGPU 的按量资源与预制模板为例,你可以把检查点目录、保存频率与卡数变更策略提前写进启动配置,让缩卡续跑成为常规动作而非事故处理。
- 检查点目录放持久化存储(如云盘),不要放实例本地盘。
- 保留最近 N 份完整检查点,并原子化提交。
- 收到回收信号后,先停训练、落盘未完成的异步写盘,再退出。
- 重启脚本自动定位最新完整检查点,按新卡数重新调用 DCP 的 load 接口。
NexGPU 提供多种 GPU 服务器型号选择、按量使用、即开即用与预制模板部署,可把这些配置固化为模板。注意,本段不承诺具体价格或恢复耗时,实际表现需自测。
一次中断恢复实测该记录哪些指标
配置完不等于可靠,需要实测一轮完整的“主动中断—恢复”演练,并记录以下指标:
| 指标 | 含义 | 记录方式 |
|---|---|---|
| 单次保存耗时 | 同步保存时长 | 日志中保存开始到结束 |
| 异步写盘完成延迟 | 后台写盘最终完成时间 | 异步回调时间戳 |
| 检查点体积 | 分片总和 | 存储占用统计 |
| 中断后回退步数 | 从上个保存点回退的步数 | 对比全局步数日志 |
| 从加载到稳定吞吐的时间 | 恢复后重新达到稳定性能 | 监控吞吐曲线 |
| Badput 占比 | (保存+回退)/MTBI | 根据上述数据计算 |
这些数值必须自测,因为不同的存储介质、网络与实例规格差异很大。目前缺乏公开的 NVMe 或对象存储写入带宽基准,不要依赖外部“经验值”。
配置检查清单与四个常见误判
最后,用清单收束四步配置:
- [ ] 检查点目录位于持久化存储,且每个 Rank 分片路径独立
- [ ] 元数据文件与权重分片一起保存
- [ ] 已按 MTBI 和单步耗时计算出保存间隔步数
- [ ] 已开启异步写盘与 Save Plan Caching
- [ ] 完成一次 8 卡存、4 卡恢复的演练
常见误判:
- 存得越勤越安全:错,频率应与 MTBI 匹配。
- 异步写盘完全无开销:错,仍占用内存/显存暂存副本。
- 换卡数必须重训:错,元数据完整时 DCP 支持 Re-shard。
- 只存模型权重就能续跑:错,缺优化器状态会降低恢复质量。
以上四步构成一套完整的云端GPU长任务中断恢复与Checkpoint设置,任何检查点方案都只能压缩而非消除中断损失。
常见问题
训练中断了怎么从checkpoint继续训练?
使用 DCP 的 load 接口加载最新检查点,重启训练脚本,指定相同的模型配置。脚本会自动根据元数据重新分片,恢复权重和优化器状态。注意保持全局步数计数器不变,并从该步继续。
pytorch distributed checkpoint怎么用?
核心步骤:初始化 dist.init_process_group,构建模型后调用 torch.distributed.checkpoint.save 保存,load 恢复。需为每个 Rank 指定独立分片路径,并确保元数据文件存在。
torch.save保存大模型checkpoint太慢怎么办?
改用 DCP 的并行分片保存,替代单 Rank 汇总。保存时间随 Rank 数近似线性下降,同时开启异步写盘和 Save Plan Caching,可进一步缩短耗时。
8卡训练保存的checkpoint能在4卡上恢复吗?
可以。DCP 依据元数据做 Re-shard,恢复时指定新的 world_size 即可。需调整梯度累积步数和学习率调度,并确认优化器状态与 RNG 状态已保存。
抢占式实例被回收训练白跑了怎么办?
不会白跑。只要检查点目录在持久化存储,实例重建后自动加载最近检查点续跑。建议保留最近 N 份并原子化提交,避免写盘中的损坏。
大模型训练checkpoint多久保存一次合适?
没有通用档位。用 MTBI 与单步耗时代入本文公式测算:MTBI 越短保存越密,独占稳定节点可放宽。首次配置后按实测保存耗时回调一轮。
异步保存checkpoint会拖慢训练吗?
异步写盘本身不阻塞训练,但会占用内存或显存暂存副本,并可能增加崩溃风险。开启后需监控保存完成延迟,确保它小于保存间隔。



评论(0)