 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
FlashAttention-3显存与速度优化只压缩注意力中间矩阵的 HBM 读写,不减权重和 KV Cache,且加速收益绑定 Hopper 架构(H100/H200)。PyTorch 官方博客 2024 年 7 月的测试数据显示,FP16 下 H100 算力利用率从 FA2 的 35% 提升到 75%(740 TFLOPS),FP8 吞吐接近 1.2 PFLOPS。要落地这项优化,按「卡型—显存分账—耗时占比—生效验证」四步走,就能定位 FlashAttention-3显存与速度优化里到底哪一项收益属于你。其中第一步到第四步是核心操作流程,前面的显存分账与架构前提是判断依据,后面的对照记录表与 OOM 排查是收尾环节。
先分账:FlashAttention-3显存与速度优化压的是哪一笔显存
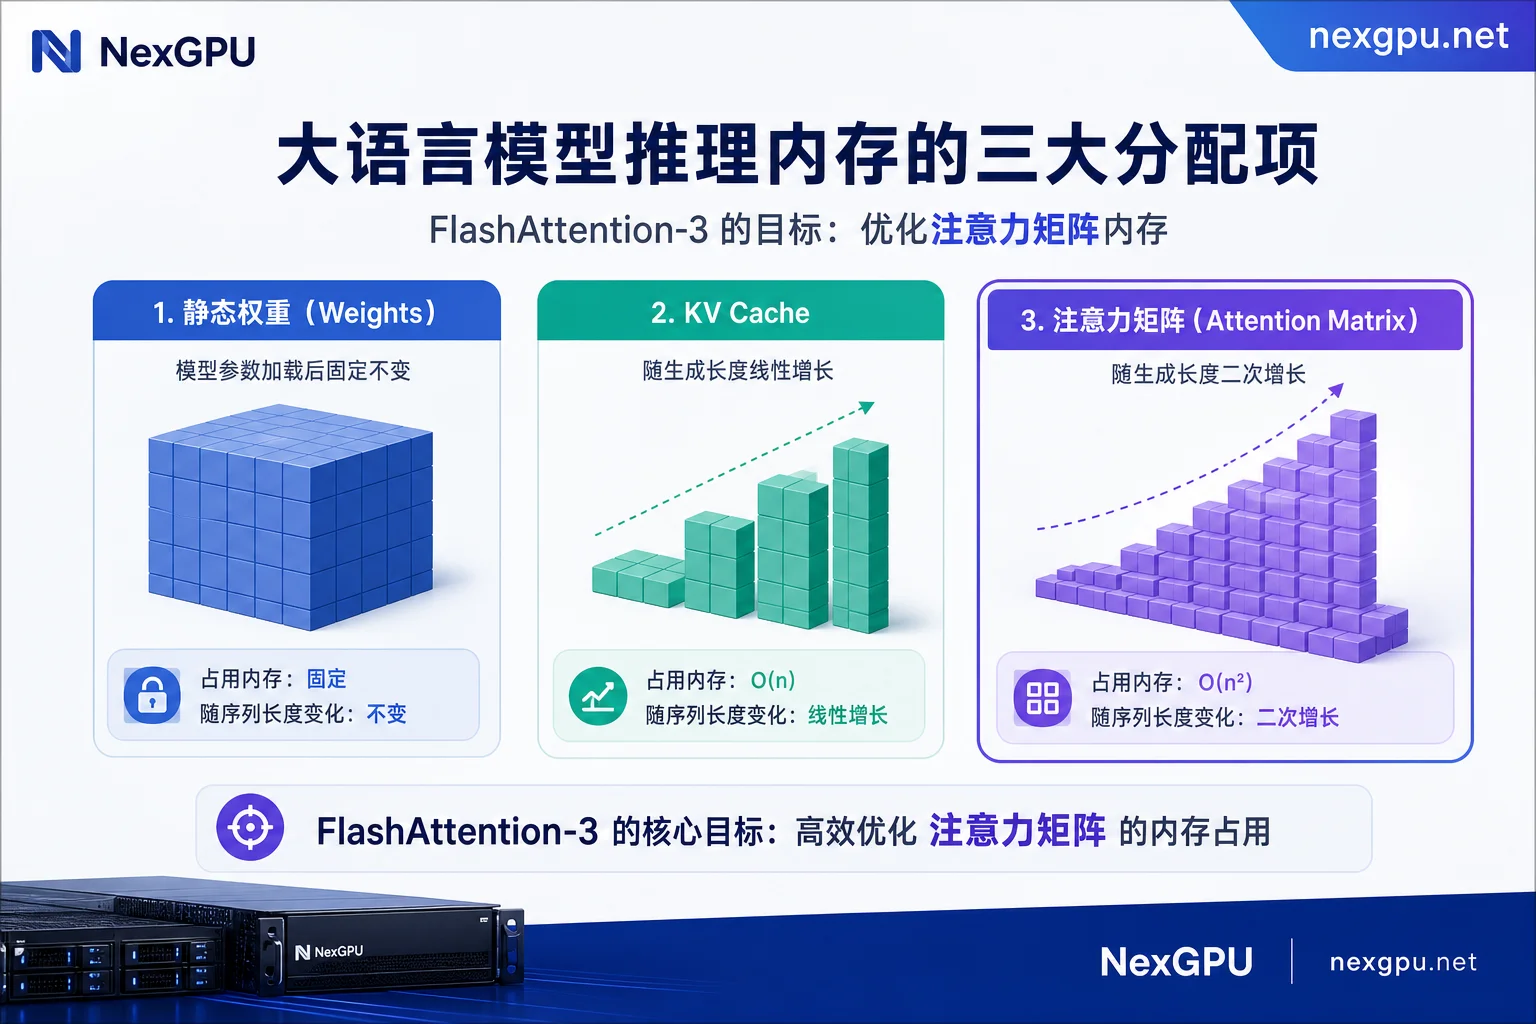
长序列推理时显存被三块占用:静态权重、随上下文长度线性增长的 KV Cache、以及序列长度平方级的注意力中间矩阵。FA3 通过分块与在线 Softmax,只消除第三笔——注意力中间矩阵在 HBM 上的物化读写,权重和 KV Cache 一分不减。
| 显存项目 | 增长规律 | FlashAttention-3 是否削减 |
|---|---|---|
| 静态权重 | 固定 | 否 |
| KV Cache | 随序列长度线性增长 | 否 |
| 注意力中间矩阵 | 随序列长度平方增长 | 是(分块 + 在线 Softmax,避免物化写入 HBM) |
搞清楚这一点,你就明白为什么开了 FlashAttention 依然可能 CUDA Out of Memory——瓶颈往往在随 128k 长上下文线性膨胀的 KV Cache(见文末常见问题)。
收益前提:TMA 与 Warp-Specialization 为什么绑定 Hopper 架构
FA3 的加速不来自编译选项,而来自 Hopper 架构(Compute Capability 9.0)的硬件单元。Tensor Memory Accelerator(TMA)负责异步数据搬运,Warp-Specialization 把线程束分成生产者与消费者,让计算与 HBM 搬运重叠。PyTorch 官方博客(2024 年 7 月)测试显示,FP16 下 H100 算力利用率从 FA2 的 35% 提升到 75%(740 TFLOPS),FP8 吞吐接近 1.2 PFLOPS,数值误差比基准 FP8 低 2.6 倍。
第一步:确认卡型与内核版本——flashattention 3 需要什么显卡
执行 torch.cuda.get_device_capability() 看 Compute Capability 是否等于 9.0。如果是,再检查 FlashAttention 安装目录下是否有 hopper 子目录。所以如果你在问「4090 能用 FlashAttention-3 吗」,答案是:能装库,但调不起 hopper 专用内核,实际执行会回退到 FA2 或 SDPA。RTX 4090(Ada 架构)和 A100(Ampere 架构)都拿不到这档收益,只能走 FA2 或 PyTorch SDPA 路径。
第二步:按序列长度与 batch 估算 Attention 占比
先用 PyTorch Profiler 分段计时,看 Attention 环节占端到端耗时的比例。序列越长,Attention 在端到端耗时中的占比越高,具体比例必须以你自己 Profiler 的分段计时为准,不要照搬他人数值。这一步决定了 FlashAttention-3显存与速度优化对你的端到端收益上限。
第三步:FP16 75% 利用率与 FP8 近 1.2 PFLOPS 分别对应什么负载
FP16 模式(740 TFLOPS,比 FA2 快 1.5-2.0 倍)适合训练与高精度推理;FP8 模式(接近 1.2 PFLOPS)适合吞吐优先的推理,但要用你的数据实测精度损失是否可接受。这些数字来自 FA3 官方博客在 H100 上的测试,不要外推到其他卡型。若你同时关心 H100 与 H200 的差异,可参考 H100与H200推理性能对比。
第四步:怎么确认 FlashAttention-3 真的生效了
用 torch.backends.cuda.sdp_kernel 上下文管理器显式启用或禁用 FlashAttention 后端做对照;直接调用 flash_attn_interface 验证可用性;再用 PyTorch Profiler 查看实际执行的内核名称,确认没有回退到 Math 路径。如果在你自己的 H100 上已确认生效,仍想优化显存峰值相关配置,可看 GPU Out of Memory显存溢出解决方法。
同负载开关对照该记录哪些指标
要量化 FlashAttention-3显存与速度优化的实际收益,必须控制变量。固定模型、序列长度、batch 与精度,只切换 attention 后端,记录以下指标:
| 指标 | 说明 |
|---|---|
| 显存峰值 | 观察中间矩阵是否被压缩 |
| TTFT(首 token 延迟) | 反映前向计算速度 |
| 稳态吞吐(tokens/s) | 反映整体处理能力 |
| 输出一致性 | 对比 FA3 与 FA2 的生成结果差异 |
只有控制变量的对照,才能区分 FA3 收益与其他调参收益。
开了 FlashAttention 还是 OOM 怎么办:四个常见误判
第一个误判:以为开了 FA 就能解决长文本 OOM,实际瓶颈是 KV Cache,需要配合分页式 KV 管理、量化或上下文并行。第二个误判:把 FA2 的收益当成 FA3。第三个误判:非 Hopper 卡期待同档加速。第四个误判:未验证内核生效就下结论。
非 Hopper 卡的替代路径
拿不到 Hopper 卡时,FlashAttention-3显存与速度优化的收益无法直接复现。如果手上是 4090 或 A100,先走 FA2/SDPA 路径,再用量化压缩权重与 KV Cache(可参考 FP8与INT4量化对GPU显存的影响),或用张量并行摊显存。如果要判断长期卡型,最可靠的方式是做一次同模型、同序列长度、同 batch 的开关对照——NexGPU 提供多种 GPU 服务器型号与按量使用,配合预制模型模板可省去自行编译内核的环境成本,短时跑完对照再决定长期跑在哪一档卡上。
常见问题
我用的是 4090,能不能编译使用 FA3 的完整加速?
不能。4090 是 Ada Lovelace 架构(Compute Capability 8.9),缺少 Hopper 专属的 TMA 硬件单元与异步指令集,无法运行 FA3 的 hopper 目录内核。所谓魔改编译获得完整 1.5-2.0 倍加速的说法未被证实。
FA3 比 FA2 在 H100 上快多少?
根据 PyTorch 官方博客 2024 年 7 月的 H100 测试,FP16 下 FA3 比 FA2 快 1.5-2.0 倍,算力利用率从 35% 提升到 75%(740 TFLOPS)。FP8 模式吞吐接近 1.2 PFLOPS。
怎么确认我的推理代码真的走 FA3 而不是静默回退?
两步确认:调用 flash_attn_interface 看是否可用;用 PyTorch Profiler 查看执行的内核名称,若看到 flash_attn_3 相关名称而非 Math 或 mem_efficient 就说明生效。也可以用 sdp_kernel 上下文管理器强制指定后端做对照。
FA3 的 FP8 模式精度会不会掉?
FA3 官方博客显示其 FP8 数值误差比基准 FP8 降低 2.6 倍,并非一定无损失。建议用你的模型与数据实测输出一致性,尤其在微调场景下优先用 FP16。
长上下文 128k 推理太慢,开启 FA3 后仍显存不足怎么办?
先确认瓶颈是 KV Cache 而非中间矩阵——FA3 不削减 KV Cache。可配合 PagedAttention、KV Cache 量化或上下文并行,也可用 RTX 4090多卡与A100单卡训练选型 评估不同卡型的显存策略。



评论(0)