 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
若负载以长上下文或高并发 Decode 为主,H200 更划算;若为短上下文、低并发或 Prefill 主导,继续用 H100 更省。这一判断基于两者计算核心完全一致,H200 的溢价仅购买了更大的显存容量与更高的带宽。
差价买走的是显存:H100 与 H200 共用同一颗计算核心
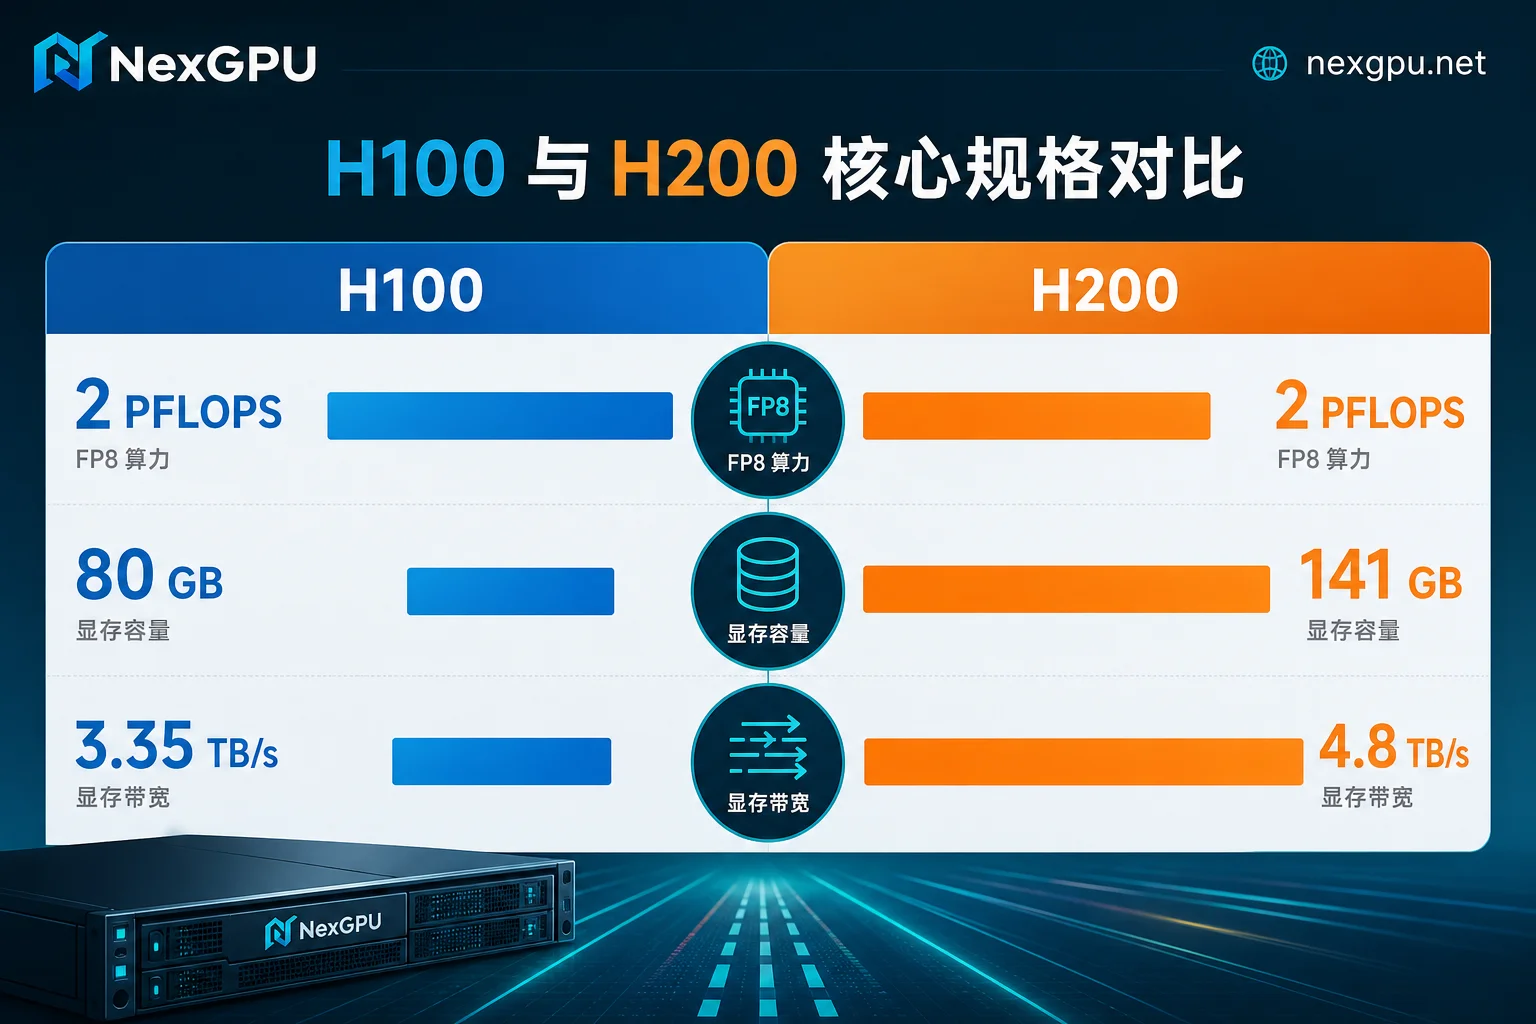
许多工程师在对比这两款显卡时容易陷入误区,认为 H200 拥有更强的计算单元。事实上,NVIDIA H200 SXM 与 H100 SXM 均基于相同的 Hopper GH100 架构,其 FP8 稠密峰值均为 2 PFLOPS,NVLink 4.0 互联带宽同为 900 GB/s。真正的升级体现在显存子系统:H200 配备了 141GB HBM3e 显存,带宽高达 4.8 TB/s,相比 H100 的 80GB HBM3(3.35 TB/s),容量增加了 76%,带宽提升了 43%。
这意味着,为 H200 支付的额外费用,购买的并非更多的浮点运算能力,而是更快的数据搬运速度和更大的存储空间。对于不依赖高带宽或大容量显存的负载,这种硬件升级无法转化为实际的性能收益,导致溢价换不回单位产出收益。
Decode 阶段吞吐差异:带宽瓶颈何时显现
在大模型推理过程中,自回归解码(Decode)阶段是典型的内存密集型任务。每生成一个 Token,都需要将模型权重和 KV Cache 从显存读取到计算单元,此时计算核心往往处于等待数据的空闲状态。因此,显存带宽成为制约吞吐量的瓶颈。
公开实测数据显示,在 Llama 3 70B 等大规模模型的推理场景中,H200 的输出吞吐较 H100 提升约 45%,从约 21,806 tok/s 提升至 31,712 tok/s。这一差距在长上下文场景下更为显著:当上下文长度超过 16K tokens 时,KV Cache 体量激增,H200 凭借更高的带宽,其 Decode 阶段吞吐可达 H100 的 1.83 至 2.14 倍。
| 测试场景 | 模型规模/上下文 | H100 表现基准 | H200 相对提升 | 关键瓶颈 |
|---|---|---|---|---|
| 标准推理 | 70B 级模型输出吞吐 | 21,806 tok/s | +45% (31,712 tok/s) | 显存带宽 |
| 长上下文 | 70B / >16K tokens | 1.0x (基准) | 1.83~2.14x | KV Cache 读写速度 |
| Prefill 阶段 | 任意规模 | 相同算力 | 算力相同,带宽收益有限 | 计算核心利用率 |
需要注意的是,上述倍数仅在受带宽限制的 Decode 阶段成立。若负载以 Prefill(预填充)为主,由于两者算力相同,H200 并无明显优势。数据来源类型参考主流 GPU 云平台实测与 MLPerf 记录,适用前提为 70B 级别模型及特定上下文长度。
单卡装 70B 能跑多少并发
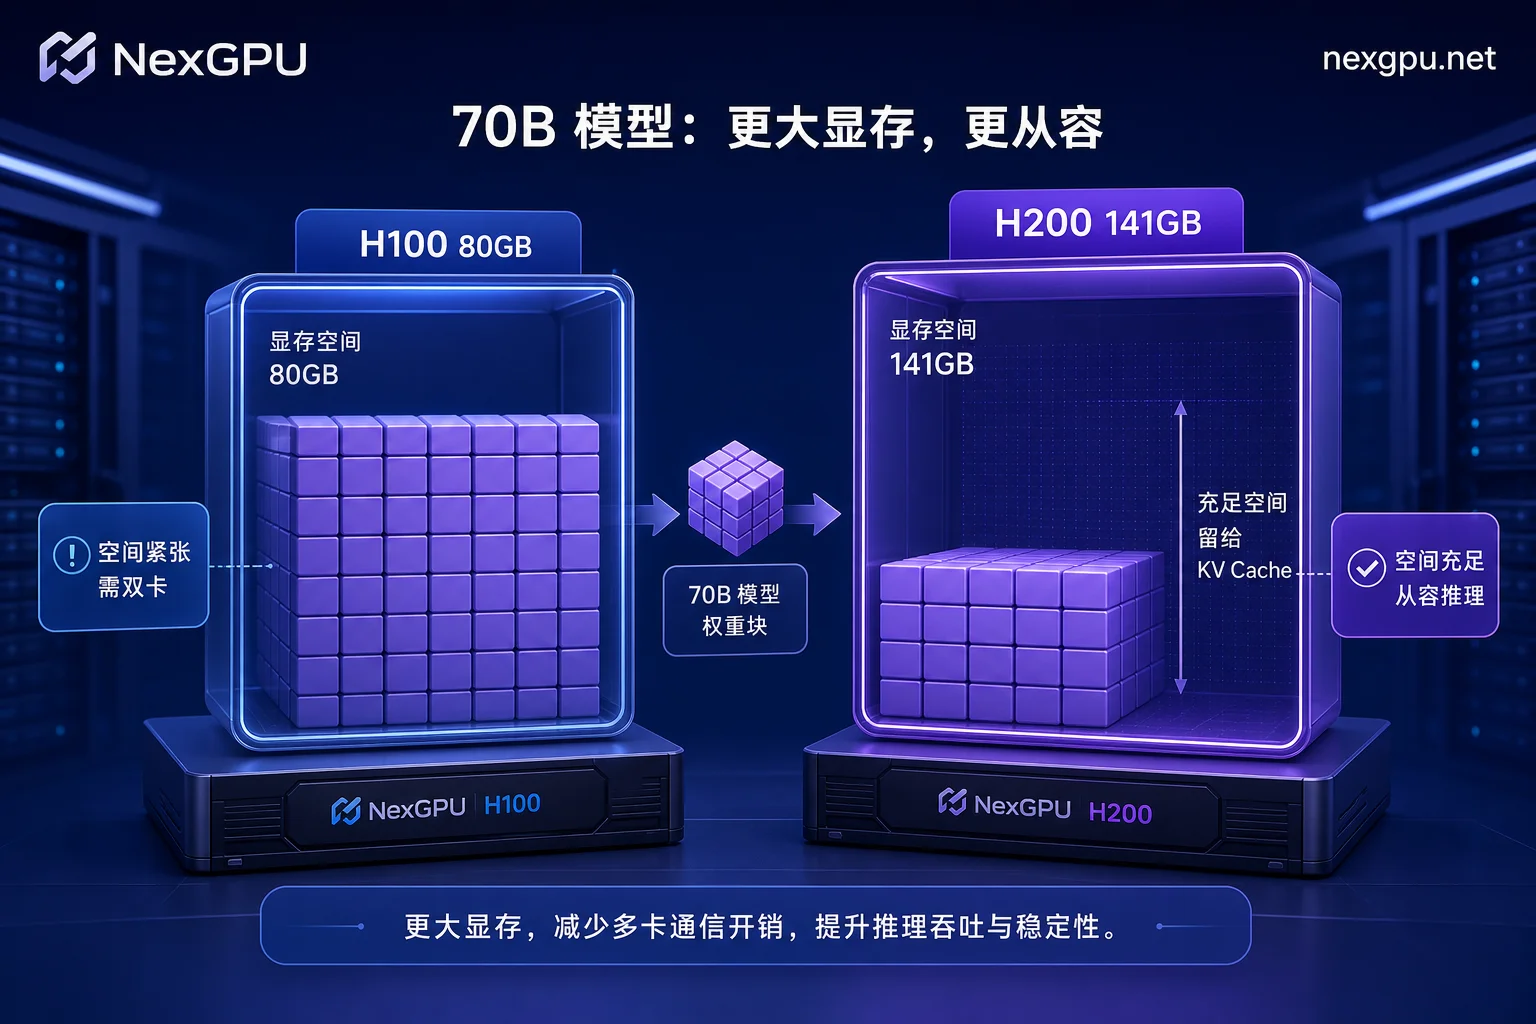
显存容量直接决定了部署架构的复杂度。以 70B 参数的模型为例,按「参数量 × 每参数字节数」估算,FP8 精度下权重约占 70GB 左右,加上运行时开销和基础 KV Cache,总显存需求往往逼近 80GB 上限。在 H100 上,这通常意味着余量极度紧张,极易触发 OOM(内存溢出),迫使团队采用双卡张量并行(TP)方案,从而引入额外的卡间通信延迟。
相比之下,H200 的 141GB 显存提供了充足的缓冲空间,能够轻松容纳 70B FP8 权重及较大规模的 KV Cache,实现单卡部署。这不仅节省了一张卡的租赁成本,更消除了 TP 带来的通信开销和调度复杂性。为了验证具体负载的适配性,可以使用 FP8与INT4量化对GPU显存的影响 中的估算方法,或直接利用 NexGPU 提供的按量实例进行对照测试,用实测峰值显存替代理论推算。
时租溢价折成每百万 Token 成本值不值
判断 H100 和 H200 哪个划算的最终依据是单位产出成本。根据第三方云平台公开数据(统计时点约为 2024-2025 年区间),H100 SXM 时租约为 $2.59-$3.29/小时,而 H200 SXM 约为 $3.59-$4.59/小时,溢价幅度在 25% 至 40% 之间。各平台与地区差异会导致溢价率浮动。
我们将这一溢价折算为每百万 Token 的成本公式:
$$ \text{成本比} = \frac{1+\text{溢价率}}{1+\text{吞吐增幅}} $$
盈亏平衡点在于吞吐增幅等于溢价率。例如,若 H200 时租贵 25%,但吞吐提升 45%,则每百万 Token 成本降低约 13.8%;若 H200 时租贵 40%,但吞吐提升 45%,则每百万 Token 成本仅降低约 3.5%。然而,如果负载的吞吐提升不足 25%,或者由于低并发导致 GPU 利用率低下,那么支付高额溢价将导致单位成本上升。因此,必须基于真实业务负载下的平均吞吐而非峰值数据进行核算。
继续留在 H100 更省钱的三类负载
并非所有场景都适合迁移至 H200。以下三类情况中,H100 依然是更具性价比的选择:
- 短上下文、短输出场景:此类负载 Decode 占比低,KV Cache 占用小,带宽瓶颈不明显,H200 的高带宽优势无法发挥。
- 低并发或 Prefill 主导任务:瓶颈在于计算核心而非显存搬运,鉴于两者算力相同,H100 能以更低价格提供同等性能。若需进一步压缩成本,可考虑 A100租用 作为更低档位卡型。
- 已稳定运行的多卡拓扑:若现有集群已通过优化解决显存问题,换卡带来的重新调参、环境迁移及潜在兼容性风险可能抵消节省的 Token 成本。
此外,需警惕“加卡即线性提速”的误区。在多卡环境下,KV Cache 的冗余复制和通信开销会导致边际效益递减,H200 的优势不会随卡数无限放大。该结论来自大规模集群部署的公开实践观察,而非本文推断。
671B 级模型的额外变量:8×80GB 装不下时省掉的是什么
当模型规模跨越单节点物理极限时,选型逻辑从“性价比”转变为“可行性”。DeepSeek-V3/R1 671B 模型在 FP16 精度下需约 1.4TB 显存,即便采用原生 FP8 并包含 MTP 参数,也需约 685GB。这超出了标准 8×80GB H100 节点 640GB 的物理上限。
此时,H200 的价值体现为规避复杂的工程妥协:
- 方案 A(H100):必须使用 AWQ 4-bit 量化将权重压缩至约 335GB 才能单机运行,但这会牺牲部分精度;或采用跨机 16×80GB 部署,面临高昂的网络通信开销。
- 方案 B(H200):单台 8×H200 节点拥有约 1128GB 显存,可直接承载未量化的 FP8 模型,免去精度取舍与跨机通信负担。
对于这类超大模型,DeepSeek-R1私有化部署GPU配置 显示,选择 H200 实际上是在购买“免量化”和“免跨机”的工程确定性,这部分隐性成本节约往往被低估。
常见问题
H200 真的比 H100 算力更强吗?
否。两者均采用相同的 GH100 计算核心,FP8 稠密峰值均为 2 PFLOPS。H200 的优势仅在于 141GB HBM3e 显存和 4.8 TB/s 带宽,而非计算能力本身。
70B 模型能在单张 H200 上跑 FP8 吗?
可以。70B 模型 FP8 权重约占 70GB,加上 KV Cache 和运行时开销,通常在 100GB 以内,H200 的 141GB 显存足以容纳,无需像 H100 那样常因余量不足而被迫双卡并行。
长上下文推理为什么更推荐 H200?
因为长上下文导致 KV Cache 巨大,解码阶段频繁读写显存。H200 带宽比 H100 高 43%,在 16K+ 上下文场景下,吞吐可达 H100 的 1.83-2.14 倍,显著摊薄单位 Token 成本。
什么时候选 H100 更划算?
当负载以 Prefill 为主、上下文极短或并发很低时。这些场景瓶颈不在带宽,且 H100 时租便宜 25%-40%,若吞吐提升不足 25%,选 H100 能直接节省预算。
如何准确评估是否值得升级?
不要只看参数表。建议在 NexGPU 等平台按量开机,使用真实业务数据跑一轮同负载对照,记录实测吞吐与峰值显存后停服,再代入每百万 Token 成本公式进行最终决策。



评论(0)