 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
先把结论摆出来,你可以直接跳到自己那一档:
- 16GB 显存:主干换 FP8,文本编码器换 fp8 版本,1024×1024 基本能跑满流程,画质损耗很小。
- 10~12GB:GGUF Q5_K_M 或 Q4_K_S 主干 + fp8 的 T5,配合 ComfyUI 的低显存模式。
- 8GB:GGUF Q4 档 + fp8 T5 + CPU 卸载,能出图,但要接受等待。
- 6GB:只能靠逐层卸载硬撑,速度会掉到让人放弃的程度。
- 24GB 及以上:不用量化也能跑,只需处理好解码阶段的显存尖峰。
下面说清楚每一步动了什么、代价在哪。
显存到底花在了哪三块
FLUX.1 的 dev 和 schnell 共用同一套架构:约 12B 参数的 DiT 扩散主干,加上约 4.7B 参数的 T5-XXL 文本编码器,再加 CLIP ViT-L 和 VAE 解码器。
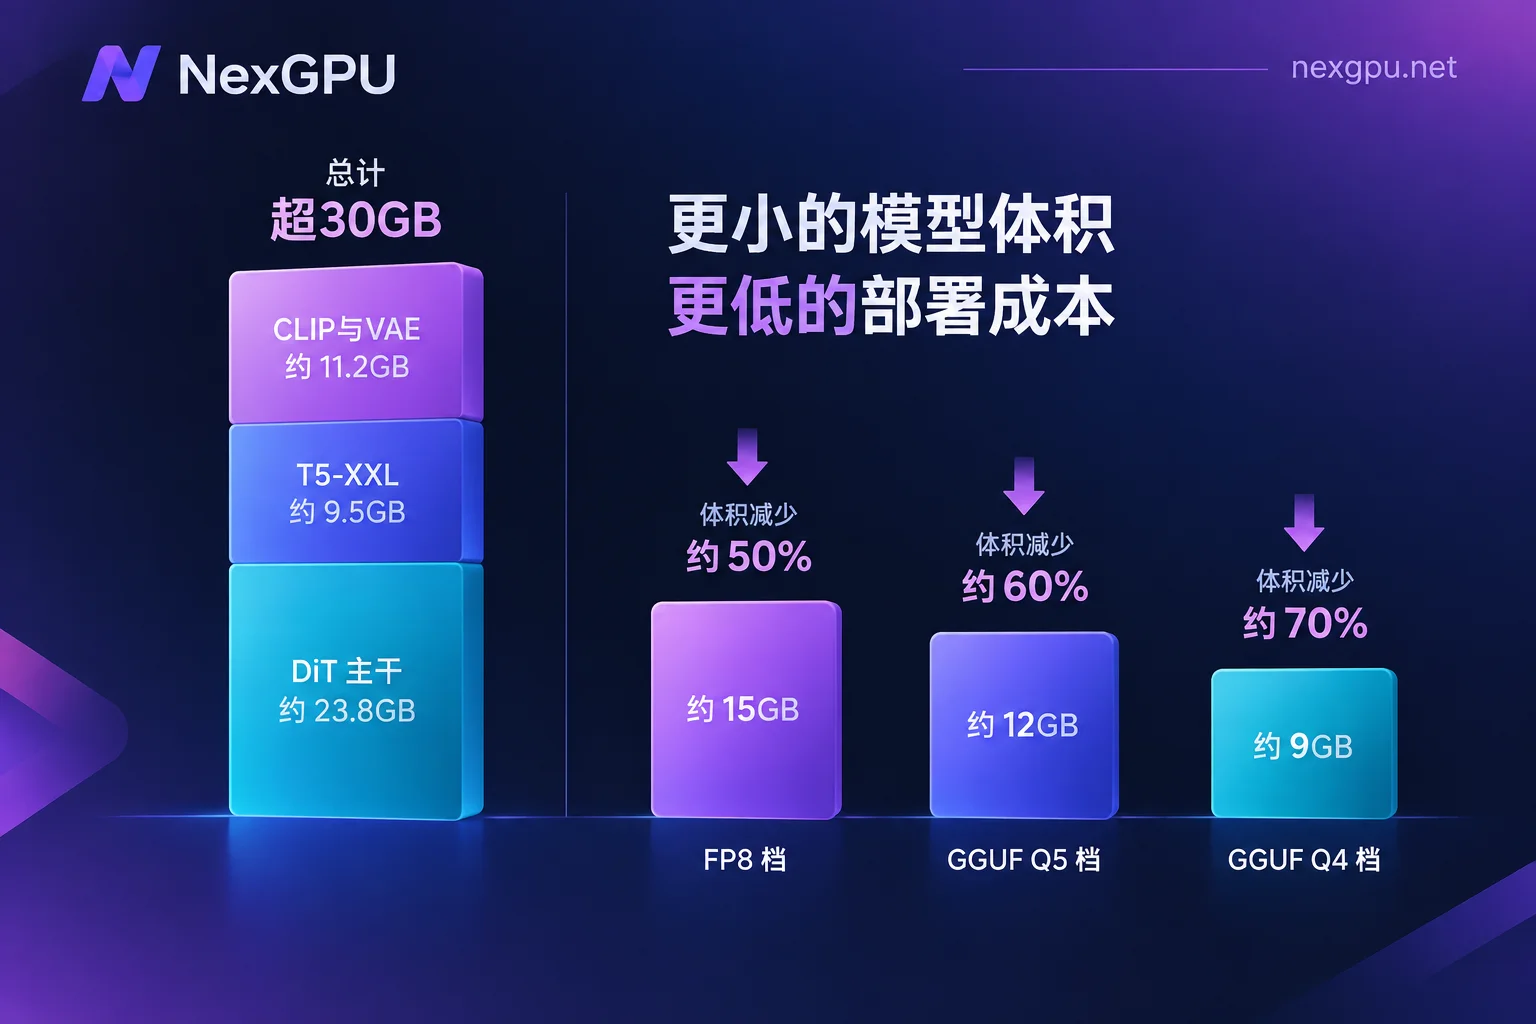
按 FP16 精度算,主干本身约 23.8GB,T5-XXL 约 9.5GB,两者相加已经超过 33GB。这就是为什么哪怕 24GB 的消费级旗舰卡,在默认全精度、所有模块同时驻留显存的情况下也会逼近甚至越过上限,而 8GB、12GB 的卡连模型都加载不完就报 CUDA Out of Memory。
看清这个结构很重要:降门槛的所有手段,本质上只有两类——要么把权重压小(量化),要么让它们别同时待在显存里(卸载)。第三类是处理生成末尾 VAE 解码那一下的瞬时尖峰。三类手段可以叠加,代价各不相同。
手段一:量化主干和文本编码器
这是收益最直接的一步,也应该最先做。
FP8 档(适合 16GB)。 把主干换成 FP8 权重(常见文件名形如 flux1-dev-fp8.safetensors),体积从 23.8GB 砍到约 11.9GB。在 RTX 4080、RTX 4060 Ti 16GB 这类卡上,配合 fp8 的文本编码器,可以完整跑 1024×1024 出图,画质损耗在肉眼层面很难察觉。如果你的卡是 16GB,优先走这条路,别急着上更激进的量化。
GGUF 档(适合 8~12GB)。 ComfyUI 侧用 city96 的 ComfyUI-GGUF 插件,加载 Q4_K_S 或 Q5_K_M 格式的主干,权重能压到 6~8GB 区间。Q5_K_M 质量更稳,Q4_K_S 更省,12GB 卡建议先试 Q5_K_M,8GB 卡通常要落到 Q4 档。
别忘了文本编码器。 很多人只量化了主干,结果还是 OOM,原因就是 T5-XXL 那 9.5GB 没动。把它换成 t5xxl_fp8_e4m3fn,差不多能省一半。主干 GGUF + T5 fp8 的组合,是 8GB 卡跑通 FLUX 的常规配方。
NF4 路线。 bitsandbytes 的 4bit(NF4)量化是另一条可选路径,思路和 GGUF 类似,都是把权重压到 4bit 量级。选哪条主要看你用的前端更支持哪种加载方式,不必两边都折腾。
量化的代价是画质和细节的轻微退化,越激进越明显,尤其体现在文字渲染、细密纹理和手部这类本来就难的地方。如果你在做需要交付的商业图,建议拿同一组 seed 和 prompt,在 FP8 和 Q4 之间对比几张再决定。
关于不同精度档位省下多少显存的换算逻辑,可以看这篇更系统的拆解:FP8与INT4量化对GPU显存的影响有多大?4笔账分开算。
手段二:把不用的模块卸到内存里
量化之后仍然不够,就轮到卸载。核心思路是:文本编码器只在开头用一次,VAE 只在结尾用一次,它们没必要全程占着显存。
ComfyUI 侧:默认就是流式加载,显存吃紧时可以加 --lowvram 启动参数,让模型按需分块调入显存。
Diffusers 代码侧,两个函数强度不同,别用混:
# 模块级卸载:文本编码器、VAE 用完就退回内存,推荐先用这个
pipe.enable_model_cpu_offload()

# 子模块逐层卸载:更省,6GB 显存也能跑起来,但明显更慢
pipe.enable_sequential_cpu_offload()
enable_model_cpu_offload() 是性价比最高的选择,速度损失可以接受。enable_sequential_cpu_offload() 是最后手段,它把权重按层反复在内存和显存之间搬运,每一步去噪都要过一遍 PCIe,速度下降是数量级的。6GB 卡能不能跑 FLUX?能,但你得问自己愿不愿意为一张图等这么久。
注意这两个函数要在把 pipeline 手动 .to("cuda") 之前调用,否则会冲突。
手段三:解决 VAE 解码那一下尖峰
一个很常见的现象:去噪过程全程正常,进度条走完,最后一秒报 OOM。问题出在 VAE 解码——它要一次性把 latent 还原成完整像素图,1024×1024 及以上分辨率时显存占用会突然拉高。
Diffusers 里加两行就能绕过:
pipe.vae.enable_tiling()
pipe.vae.enable_slicing()
分块解码再拼接,避开瞬时峰值。代价是极大分辨率下可能在拼接边缘看到轻微接缝,日常出图基本无感。
如果你的报错不止这一种,定位顺序可以参考:GPU Out of Memory显存溢出解决方法:5步定位。
手段四:换 schnell,省的是时间不是显存
这点容易被误解。FLUX.1 [schnell] 和 dev 架构相同、参数量相同,显存占用规模是一样的,换过去并不会让原本 OOM 的机器变得能跑。
schnell 的价值在时间。它经过时间步蒸馏,1~4 步即可出图,而 dev 通常要 20~50 步。当你已经开了量化和卸载、单步本身就慢的时候,步数减少 4~7 倍带来的体感改善非常明显。另外 schnell 的 guidance_scale 固定为 0,不吃 CFG 调节——如果你的工作流依赖精细的 guidance 控制,那就得留在 dev 上。
所以顺序是:先用量化和卸载解决"能不能跑",再用 schnell 解决"要等多久"。
本地降门槛的隐性成本:内存和 PCIe
这一段值得单独说,因为它是很多人折腾一整天仍然失败的真正原因。
量化和 CPU 卸载没有消灭负担,只是把显存压力转移给了系统内存和 PCIe 通道。如果主机内存不足 32GB(建议 32~64GB),系统会开始往硬盘的页面文件里换页,表现就是整机假死、风扇狂转、单张图耗时膨胀几十倍。这时候你以为是显卡不行,其实是内存不够。
同样,如果显卡跑在 PCIe x4 或者老一代插槽上,逐层卸载的搬运开销会被进一步放大。
所以本地方案的完整前提是:足够的系统内存 + 像样的 PCIe 带宽 + 你愿意付出的调试时间。三者缺一,折腾的收益就会快速归零。
什么时候别再折腾,直接换显存
判断标准很实际,出现下面任意一条,继续优化就不划算了:
- 已经压到 Q4 档,画质掉到影响交付;
- 单张图要等几分钟以上,而你需要反复调 prompt 迭代;
- 要跑 LoRA 训练、ControlNet 叠加、批量出图或更高分辨率——这些都会在推理基线上再加显存;
- 主机内存本来就不够,升级内存的钱和一段时间的云端算力差不多。
显存档位对应的自由度大致是:24GB(如 RTX 3090、RTX 4090)可以不量化或只用轻量 FP8 跑完整流程,配合 VAE 分块就很顺;48GB(如 L40S、A6000)能把 DiT、T5、VAE 全部按原精度常驻,彻底省掉卸载带来的传输瓶颈,也给 LoRA 训练和多工作流并行留了余量。
真要换到云端,省事的做法是直接用现成的 ComfyUI 镜像开机,而不是自己从裸系统装驱动、装依赖、下模型——那部分时间成本往往比算力本身更贵。在 NexGPU 的镜像模板 里可以找到 ComfyUI、PyTorch 这类一键部署的环境;不确定自己的工作流该配哪张卡,可以先看 按模型的选卡指南。
几个会影响账单的边界,动手前先知道:按小时计费、按秒计量,没有最低消费和合约;账单只有算力、存储、流量三项;停机之后算力停收,但存储还在计费,只有销毁实例才全部停止——这意味着你如果打算隔天继续调图,停机保留环境是合理的,但长期不用就该把模型权重导出后销毁。下单时的单价会锁定到实例销毁为止。这些口径可以在 价格页 对着可租节点确认。
一个实际的用法:先在本地用量化版本把 prompt 和工作流调顺,需要出高质量成品、批量渲染或训练 LoRA 时再开云端大显存实例集中跑一批,跑完导出成果销毁。这样既不用忍受本地的画质折损,也不会让机器空转烧钱。
如果你想看完整的云端部署步骤,可以接着读:Flux.1模型云端GPU部署教程:显存要多大?



评论(0)