 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
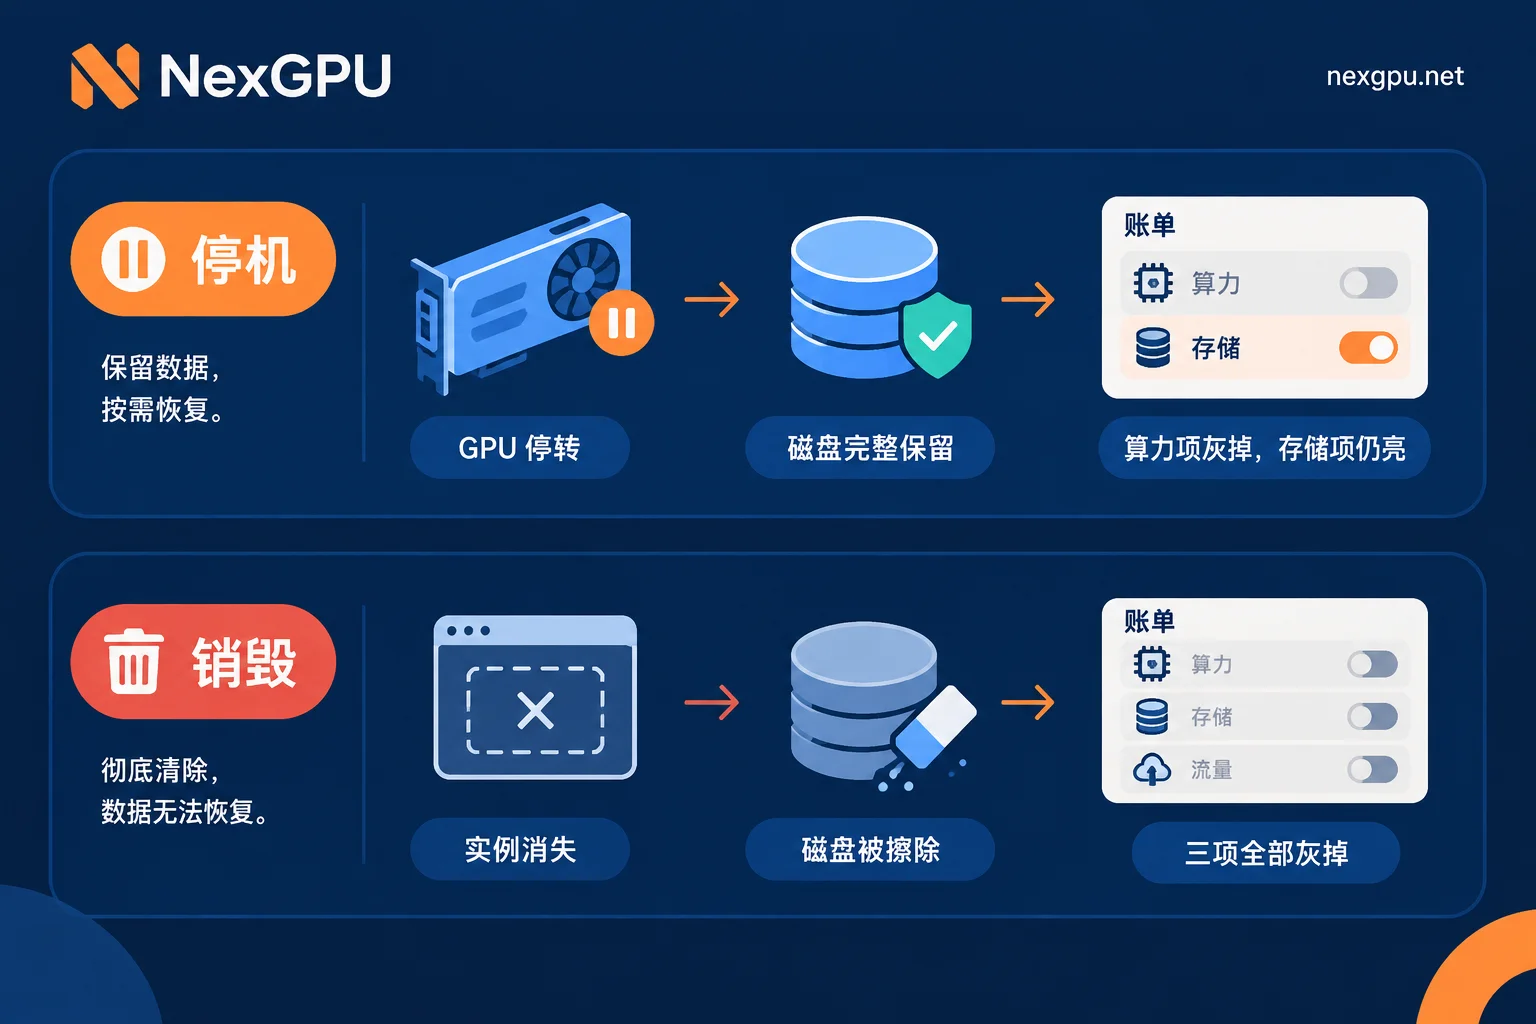
先给结论:销毁(Terminate / Destroy)会丢数据,而且找不回来。销毁这个动作是把实例连同随它创建的系统盘、标记为随实例删除的数据盘一起回收擦除,实例无法再启动,盘上没有导出的模型权重、Checkpoint、生成结果、改过的配置文件全部消失,平台侧也没有回收站可以捞。
停机(Stop)不会丢数据。停机只是停掉 GPU 和 CPU 的运行、释放计算资源,磁盘仍然挂在实例上,环境、依赖、数据原样保留,重新开机就还在。代价是磁盘空间一直被占着,所以停机期间存储费照收。
把这两句话换成账单语言:在 NexGPU,账单只有算力、存储、流量三项。停机停的是算力那一项,存储还在计;只有销毁,三项才全部停止。这也是很多人第一次租卡时踩的坑——以为点了关机就不花钱了,过几天看账单发现还在扣。
销毁之前,哪些东西必须先搬出去
按照“重建成本”来分类,比按文件夹分类更实用。
必须外移的:
- 微调产出的 LoRA / 适配器权重、合并后的模型文件
- 训练中的 Checkpoint(尤其是任务没跑完、打算换机器续跑的)
- 生成的图片、视频、音频成品,以及 ComfyUI 的工作流 JSON
- 你自己写的训练脚本、推理服务代码、改过参数的配置文件
- 数据集里经过清洗、标注、切分的那一份(原始公开数据集不用,能重新下)
- 数据库文件、向量库索引(如果跑了 RAG)
requirements.txt、pip freeze导出的环境清单、启动命令记录
不用外移的:
- 从 Hugging Face / ModelScope 拉下来的原始基础模型——重新拉一次就有,占空间还大
- conda / pip 的包缓存、CUDA 相关系统组件
- 镜像里本来就自带的那部分环境(换台机器选同一个镜像模板就能还原)
判断标准很直接:重新下载能拿到的,不用搬;只存在于这台机器上的,必须搬。
三条外移路线,按你手上的东西选
路线一:对象存储(大文件首选)
模型权重、Checkpoint、成批的生成结果,走对象存储最稳。在实例里装好 rclone 或对应的 CLI 工具,配好 S3 / OSS 兼容的 endpoint 和密钥,然后同步目录:
rclone copy /workspace/outputs remote:my-bucket/outputs -P带 -P 能看进度,大文件传输时别关终端,或者直接放进 tmux / screen 里跑,免得 SSH 断线中断传输。
路线二:代码仓库(脚本和配置)
训练脚本、推理服务代码、工作流文件推到 Git 仓库里。这类文件体积小但最容易被忽略——很多人记得存模型,忘了存那个调了两天才跑通的启动参数。养成习惯:改通一次就 commit 一次,不要等到销毁前才想起来。
路线三:模型社区(权重类)
微调完的权重可以直接用 huggingface-cli upload 或 ModelScope 的 CLI 推到自己的私有仓库,好处是下次换机器用一条命令就能拉回来,不用再配对象存储的密钥。
传完一定要验证,不要传完就直接销毁。至少做两件事:在存储端确认文件列表和大小对得上(rclone ls remote:my-bucket/outputs 和本地 du -sh 对照),关键的模型文件核对一下校验和。有条件的话,在另一台便宜的机器上拉回来加载一次,确认文件没损坏——权重文件传输截断是很常见的,而且加载时才报错。
关于“能不能挂一块独立于实例的持久盘、销毁实例时盘还在”,不同平台的做法差别很大,同一个平台不同实例类型也可能不一样。下单前先在控制台确认你这台机器挂的盘是不是随实例删除,不确定就直接问客服,别拿别家的规则套过来。NexGPU 的计费口径可以在 关于页的计费说明 看到,具体机型的盘怎么算,Telegram 客服也能直接确认。
更细的备份操作和目录规划,可以看这篇:租的 GPU 实例数据怎么保存:停机保盘、销毁清空与三条外移路线。
那到底该停机还是该销毁
这不是“哪个更好”的问题,是看你多久会回来用。
倾向停机的情况:
- 明天、后天还要接着跑,环境配置复杂(编译过算子、装过一堆特定版本的依赖),重建要花掉半天
- 任务分阶段,中间要等数据、等标注、等人确认结果
- 你抢到的是一个不容易再租到的机型,或者当时锁定的单价现在不一定还能拿到——在 NexGPU,下单时的单价锁定到销毁为止,销毁后再租就是按新的价格重新下单
倾向销毁的情况:
- 任务已经跑完,产出都导出验证过了
- 只是试跑、验证可行性,环境用镜像模板一键就能还原
- 接下来一两周不会碰,存储费攒着不划算
- 下一步要换更大或更小的卡,反正这台也留不住
算一笔粗账就清楚了:存储费 × 你打算闲置的天数,对比重建环境的时间成本 + 重新拉数据的流量。闲置几小时到一两天,停机通常更省事;闲置一周以上,多半是导出后销毁更合算。如果你的环境本来就是从镜像模板一键起的、没做多少定制,重建成本很低,那就更没必要留着一台停机实例慢慢扣存储费——云 GPU 镜像模板怎么选 里讲了怎么让环境尽量“可一键重建”。
还有一种常被忽略的中间状态:长任务跑一半机器出问题或者你必须换机器。这时候真正救命的不是停机,是训练脚本里本来就写好的 Checkpoint 自动保存 + 自动上传。参考 云端 GPU 长任务中断恢复与 Checkpoint 设置,把保存间隔和外传动作配进训练循环,比事后补救可靠得多。
销毁那一刻的操作顺序
把顺序固定下来,就不容易出事:
- 停掉正在跑的训练/推理进程,确认没有进程还在往磁盘写文件
- 按上面的清单把产出同步到对象存储 / Git / 模型仓库
- 在存储端核对文件数量、大小、校验和,关键权重最好试着加载一次
- 把环境信息留档:
pip freeze > requirements.txt一起传走,启动命令记在 README 里 - 确认实例上没有挂着你还需要的、但并不随实例保留的盘
- 执行销毁,回到控制台确认实例状态已经变成已销毁,账单里这台机器的三项计费都归零
第 6 步值得单独看一眼。有的人点了销毁就关页面,后来发现操作没生效或者还有另一台忘了处理的实例在扣费。销毁完刷新一下实例列表,比事后对账单省心。
几个容易混的地方
“关机了怎么还在扣钱”——停机停的是算力,磁盘还占着,存储费继续走。想彻底停就得销毁。
“数据盘应该是独立的吧”——不一定。随实例创建、标记为随实例删除的盘,销毁时一起没。下单时确认清楚,别默认。
“我在别的云上销毁过还能恢复”——各平台的生命周期设计不同,有的有回收保护、有的有单独的卷保留策略。不要把一个平台的经验直接套到另一个平台,以你正在用的这个平台的文档和客服说法为准。
“先销毁再想办法找回”——没有这一步。销毁是不可逆的,唯一的保险是销毁之前就把东西搬走。
想好了这次任务要租什么卡、跑多久、跑完是留着还是销毁,就可以去 价格与可租节点页 挑机型下单——记住单价是锁定到你销毁为止的,这一点会影响你对“留着还是清掉”的判断。



评论(0)