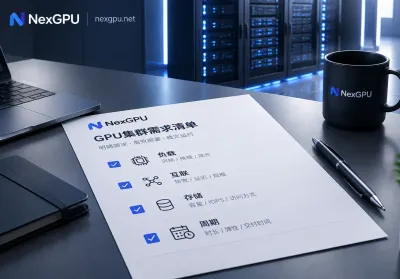
咨询GPU集群或预留资源时,不要只报一个显卡型号和数量。先把这批卡要跑什么、卡之间要不要高速通信、数据怎么读写、要用多久、平均能用满多少写成一份清单,再通过企业对接入口提交。这样对方能直接判断有没有合适的节点、多久能交付、怎么计费,不用反复追问。下面按实际顺序讲:先判断需不需要咨询,再整理清单,最后说明沟通时要问清哪些事。先判断:你的需求需要人工对接吗...
当你用 DeepSpeed 在 8 卡 A100 上跑大模型微调,刚启动就报 CUDA out of memory,或者训练到第 3 个 step 直接卡死不动时,别急着加显存——这篇 DeepSpeed多卡分布式训练踩坑指南按五个落点依次排查,多数问题在配置层就能解决。不过动手前有个前提:请先确认 DeepSpeed 版本。2026 年 8 月发布的...
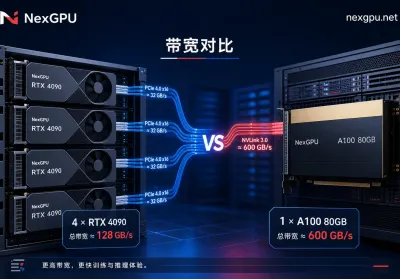
RTX 4090多卡与A100单卡训练选型的核心,不是比较显存总量,而是看你的任务是否受限于跨卡通信。根据NVIDIA官方数据手册,A100 80GB的NVLink带宽高达600 GB/s,而RTX 4090多卡受限于PCIe 4.0,跨卡通信需经系统内存中转,带宽仅约64 GB/s。因此,若任务需要频繁同步,堆4090可能不如一张A100。两个必须分...
0 条留言
 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客