 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
多卡推理吞吐没有翻倍,大多不是硬件坏了,最常见的原因是用错了并行方式。张量并行(TP)和流水线并行(PP)主要用来装下单卡放不下的模型,或者降低单个请求的延迟。它们让几张卡一起处理同一批请求,总吞吐不会按卡数相乘。想让吞吐接近翻倍,模型又能单卡装下时,更合适的做法是每张卡跑一个独立副本,前面加负载均衡(数据并行)。
如果你确实需要 TP,吞吐还会受三件事影响:并发请求够不够、卡间互连是 PCIe 还是 NVLink、Decode 阶段的计算量是否太小。下面按排查顺序逐项说明。
第一步:确认你用的是哪种并行
先看启动参数。以 vLLM 为例:
tensor_parallel_size=2或4:一个模型被切成几份,分到几张卡上。从对外服务的角度看,这仍然是一个副本。pipeline_parallel_size>1:按层切分,请求依次经过不同的卡。- 每张卡各起一个独立实例,或使用框架自带的数据并行选项:这才是多个副本。
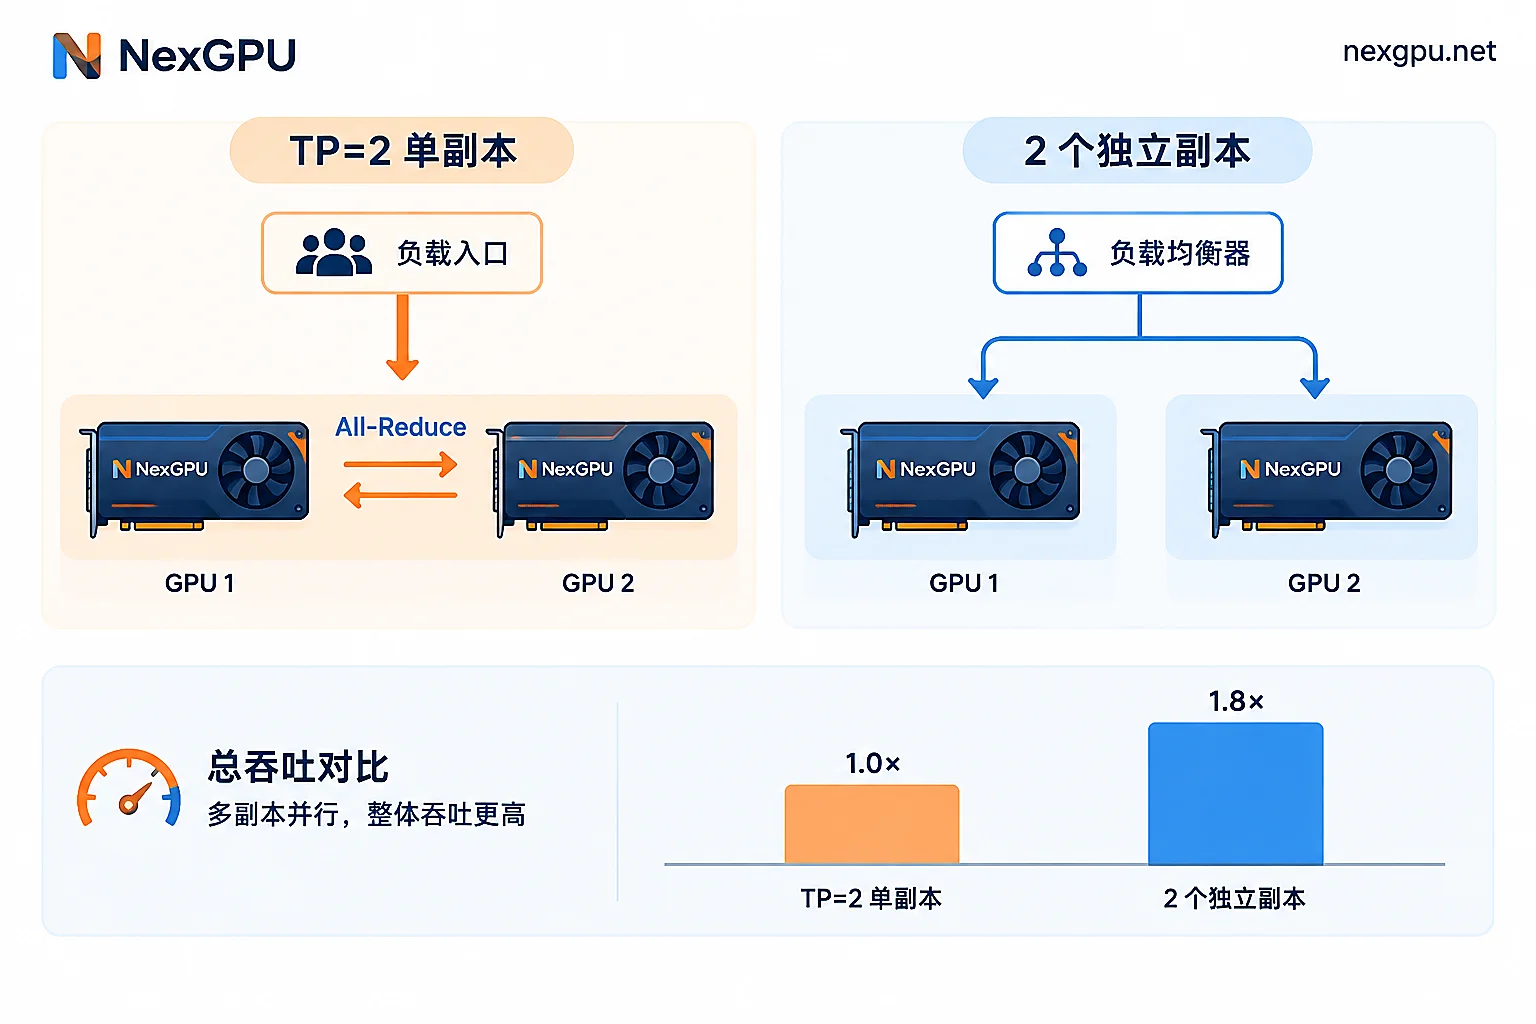
TP 模式下,所有卡共同完成同一次前向计算。它解决的是“模型放不下”和“单请求太慢”的问题,并不会把处理能力乘以卡数。假设模型在单卡上就能放下,还留有足够的 KV Cache 空间,那么改成两个独立副本,通常比 TP=2 更接近两倍吞吐。原因是副本之间不需要通信,每张卡各自满负荷工作。
PP 的问题更明显。请求要按阶段在卡间传递,存在流水线气泡和点对点传输延迟。并发不高时,大部分卡都在等上一段的输出,吞吐不可能成倍增长。
第二步:检查并发能否填满批处理
这一点很容易在压测时被忽略。vLLM 等引擎依靠连续批处理(Continuous Batching),把同时到达的多个请求合成一批,用来填满 GPU 的计算单元。如果压测只有几个并发,或者线上实际流量本来就不大,加卡之后每张卡分到的计算更少,总吞吐自然不会翻倍。这种情况下,你看到的结果反映的是请求量不足,而不是卡的上限。
排查方法:
- 单卡和多卡用相同的 Prompt 长度、生成长度分布做压测。
- 逐步提高客户端并发,例如从 1 开始成倍增加,记录总 Tokens/s。
- 观察曲线在哪个点开始变平。如果单卡在低并发时就已经接近平台,而多卡还在上升,说明之前的测试并发太低,多卡还没吃饱。
另外要分清两个指标:总吞吐(所有请求加起来的 Tokens/s 或 RPS)和单请求延迟(首字延迟 TTFT、每 Token 生成速度)。TP 常常能明显改善延迟,但总吞吐的提升有限。先确认你的业务目标是哪一个,再判断结果算不算“没翻倍”。
第三步:确认卡间互连
只要用了 TP,Transformer 每一层的注意力计算和 MLP 之后,都要做一次跨卡 All-Reduce 来同步中间结果。自回归解码每生成一个 Token 就要完整走一遍所有层,所以这种同步非常频繁。
- PCIe:带宽大约在 32~64 GB/s 这个量级,频繁同步时容易出现通信等待。吞吐的提升会被大量抵消,某些配置下甚至比单卡更低。
- NVLink / NVSwitch:带宽可以达到每秒数百 GB,TP 的通信开销小得多。
可以用 nvidia-smi topo -m 查看卡之间的连接方式。消费级显卡和不少 PCIe 版数据中心卡之间没有 NVLink,这类机器上开大 TP 的效果往往不理想。
Decode 阶段为什么特别难扩展
LLM 推理分两个阶段。Prefill 一次处理整段输入,属于计算密集型,比较容易从多卡并行中获益。Decode 逐个生成 Token,单步计算量很小,主要受显存带宽限制。用 TP 切分之后,每张卡每次处理的矩阵更小,内核启动和卡间同步的固定开销在总耗时中的占比随之上升,扩展效率因此下降。生成文本越长、Decode 占比越高,“加卡不翻倍”的现象就越明显。
按你的情况调整
模型能单卡装下,并留有足够 KV Cache 空间: 优先使用多副本。每张卡跑一个实例,可以用 CUDA_VISIBLE_DEVICES 把实例绑定到不同的卡,再在前面加负载均衡;也可以使用所用框架提供的数据并行功能,具体参数以对应版本的文档为准。这是最接近线性扩展的方案,前提是流量足够把每个副本都喂饱。
模型单卡装不下: TP 无法避免。这时按显存需求取能装下模型的最小 TP,剩余的卡用来起更多副本。例如 4 张卡、模型需要 2 张才能装下,通常“2 个 TP=2 的副本”比“1 个 TP=4 的副本”吞吐更高。具体如何取舍,可以参考推理并行度设成多少合适和张量并行和流水并行怎么选。如果长上下文导致 KV Cache 占用过多显存、单卡放不下,可以先看长上下文推理显存不够怎么办,有时调整上下文长度或量化方式就能回到单卡部署。
并行方式没问题,但 GPU 利用率始终上不去: 这时问题可能出在调度、批处理参数或数据输入链路上,可以按多卡推理 GPU 利用率上不去的五步排查继续定位。
租多卡之前先想清楚
如果你是为了提高吞吐而准备租多卡,先用单卡把“模型能否装下、单卡在高并发下能跑到多少”测出来,再决定是租多张卡跑多副本,还是租一台带 NVLink 的多卡机器跑 TP。前者对卡间互连没有要求,选卡范围更宽;后者下单前要确认节点的互连类型。可以在 NexGPU 价格页 查看可租节点的配置。如果需要多卡或集群方案,或者不确定某个节点的拓扑,可以联系我们确认。
还要注意费用:多副本意味着多个实例同时计费,压测结束后只停机仍会收取存储费,确认不再使用时要销毁实例,费用才会全部停止。


