 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
2026年11月初,全球AI算力租赁市场接连曝出两则引发行业震动的消息:先是微软被曝逐步终止与甲骨文的AI算力租赁租约,并收紧对多家新兴云服务商的长期采购,核心原因是早年签下的上一代英伟达GPU硬件逐渐老化,已难以匹配最新模型架构的规格要求;紧接着,Anthropic在最新披露的招股书修订稿中显示,尽管营收暴增,却因用户需求突增超出长约预订容量,被迫临时加购50亿美元高价短期算力,叠加高达8954亿美元的跨周期算力承诺,在三季度重回经营亏损。
这两起标志性事件,撕开了2026年GPU租用市场最真实的现状:芯片迭代与模型架构演进的速度,已经远超传统长约合同的周期。 无论是动辄买断数年的重资产锁死,还是盲目囤积单一代际的显卡,都会在模型换代时变成沉重的财务包袱。
与此同时,算力消耗的重心也在发生剧烈迁移。中国信通院2026年行业报告显示,推理算力占比已突破70%成为市场绝对主力,但仍有45%的团队因需求画像不明确导致算力利用率不足35%,更有大量用户曾遭遇隐性收费与配置错配。特别是在2026年下半年,以原生多模态视觉模型(VLM)、一次性长文档OCR解析(如Unlimited-OCR)以及全天候企业级AI Agent(如NVIDIA Nemotron 3.5 Super VL、GLM-5.3-Flash)为代表的新型工作流全面爆发,单纯靠纯文本时代的“参数量×2”经验来租卡,极易踩中显存溢出(OOM)或算力空转的深坑。
如果你正打算为团队的AI Agent、多模态视觉理解或批量文档OCR业务寻找高性价比的算力底座,本文将从2026年底的最新负载特征出发,手把手教你算清显存账、选对显卡代际,并用按需弹性的方式把每一分预算都花在刀刃上。
一、2026年算力市场洗牌给中立开发者的三个启示
为什么连科技巨头和顶级大模型实验室都在重新审视算力租约?把视角拉回到中小研发团队、AI创作者与企业算力采购身上,这三个行业信号直接决定了接下来的选型策略:
1. 硬件代际红利交替加快,“按需换代”胜过“长约死磕”
以消费级旗舰卡为例,自购一张RTX 5090加上配套高功率电源、水冷散热与服务器机箱,整机投入普遍突破4万元,而AI加速卡在架构迭代面前平均18个月就会面临显著的性能折旧。在云端租用场景下,今天你用消费级显卡做初期验证,下个月模型升级到原生多模态架构需要更高显存带宽时,随时切换到32GB显存的RTX 5090或数据中心级的A100、H100、H200乃至B200,才是最健康的现金流管理方式。
2. 工作流从“单轮聊天”转向“多模态感知 + Agent长链路执行”
在2026年的生产环境中,孤立的文本问答已难以构成业务壁垒。真实的业务往往是一条复合流水线:上传扫描版PDF或业务图表 → 视觉语言模型(VLM/OCR)提取结构化Markdown与表格数据 → AI Agent调用工具链进行多步推理与代码执行。 这种负载既有高密度的视觉Token首字计算(Prefill),又有Agent多轮挂起等待工具返回时的间歇期,要求底层算力既能抗住并发峰值,又能在业务低谷期快速收缩成本。
3. 账单透明度比“表面低价”更重要
许多团队在对比GPU租用平台时只看每小时的卡时标价,却在月底结算时发现被额外收取了端口映射费、镜像拉取授权费、最低消费门槛或高昂的捆绑带宽费。这也是为什么越来越多开发者倾向于选定计费结构极简、单价锁定且无隐性附加费的算力市场。
二、算清多模态、OCR与AI Agent的“显存账”:为什么比纯文本更吃配置?
在之前的博客文章中,我们已经详细拆解过大模型微调GPU怎么选以及Qwen纯文本与MoE模型的部署方案。但到了多模态视觉(VLM)、文档OCR与AI Agent场景,显存的消耗结构发生了本质变化。
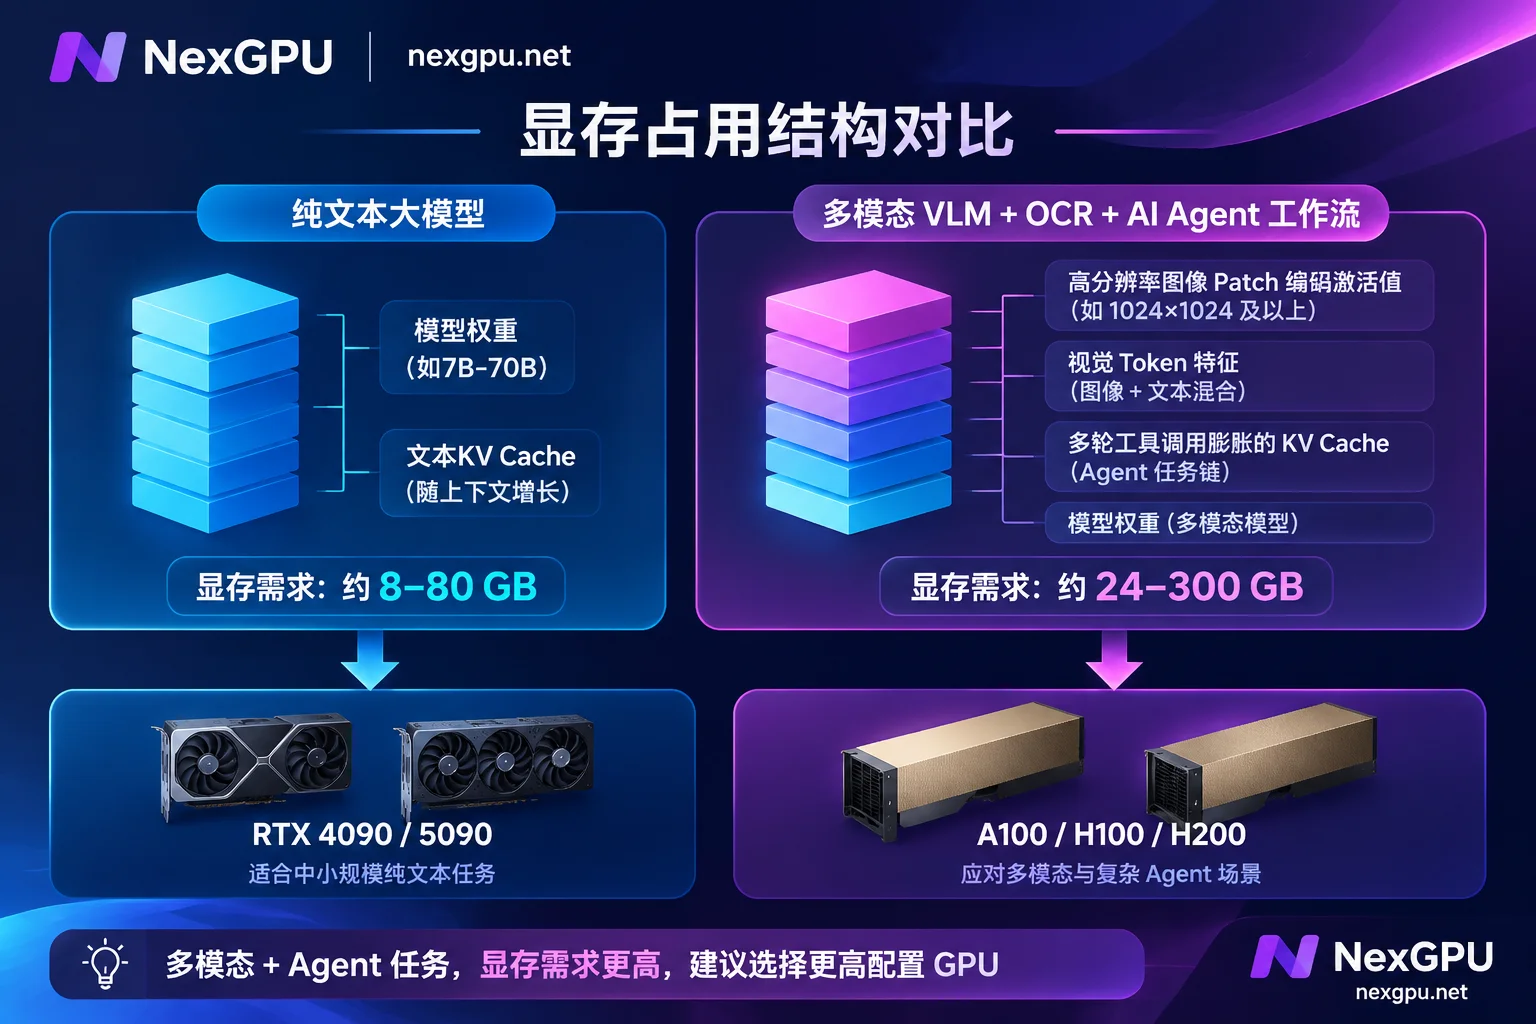
1. 视觉编码器(Vision Encoder)与高分辨率图像Patch开销
传统LLM只处理离散文本Token,而多模态模型(如Qwen-VL系列、MiniCPM-V、GLM-5.3-Flash等)以及新一代VLM架构的文档解析模型(如支持一次性多页解析的Unlimited-OCR),需要先通过视觉编码器将高清图片或PDF页面切分为成百上千个视觉Patch。
- 当你在做密集型财务报表OCR、医疗单据识别或UI自动化回归Agent时,往往不能开启高倍率的视觉下采样压缩(否则小字和表格线会模糊丢失)。
- 一张高分辨率扫描图进入模型后,等效的视觉Token数量动辄数千甚至上万,加上视觉编码器本身的激活值(Activations),其瞬时显存峰值往往比同参数量的纯文本模型高出 25%~40%。
2. AI Agent多轮轨迹带来的KV Cache膨胀
AI Agent与普通聊天机器人的最大区别在于“长程状态保持”。一个自动化执行任务可能包含十几个步骤:读取文档、查询数据库、执行Python脚本、校验结果、修正输出。每一次工具调用(Tool Call)的返回结果都会追加到上下文历史中,导致KV Cache随着并发会话数和上下文长度快速膨胀。
3. 2026主流多模态/OCR/Agent场景选卡速查表
为了避免租到显存不够的机器白白浪费排查时间,你可以参考以下负载分级来匹配消费级与数据中心级GPU(各模型的具体当前版本与量化后显存门槛,建议直接查阅 NexGPU 模型选卡指南):
| 典型业务场景 | 代表性开源模型/工具栈 | 显存特征与负载瓶颈 | 推荐租用GPU级别 | 适用阶段与部署建议 |
|---|---|---|---|---|
| 轻量化多模态 & 批量长文档OCR | 3B~8B级VLM、专用视觉OCR模型、结合Whisper的图文音流水线 | 权重占比小(BF16约8GB~16GB),但批量处理多页PDF时要求较高显存余量存图像特征 | 消费级单卡 RTX 3090 / RTX 4090 | 适合日常批量文档转Markdown、知识库ETL清洗;按需开机跑批,跑完即停 |
| 中大型视觉理解 & 桌面/GUI Agent | 11B~32B级多模态模型、74B MoE量化版(如面向本地/单卡优化的Agent模型) | 24GB显存在高分辨率多图输入或长上下文时容易触顶,32GB显存能提供关键的KV Cache安全垫 | 消费级旗舰单卡/双卡 RTX 5090 / 双卡 RTX 4090 | 适合32B级模型量化推理、复杂图表解析与中小团队内部Agent服务 |
| 企业级全天候多模态Agent & 高并发API | 70B~120B+原生多模态/MoE模型(如Nemotron 3.5 Super VL级别)、多模型协同路由 | 权重与高并发KV Cache均需要超大显存池,且对卡间通信与高显存带宽极其敏感 | 数据中心级单卡/多卡 A100 / H100 / H200 / B200 | 适合生产环境7×24小时在线服务、多Agent并发调度,建议搭配vLLM或SGLang启用前缀缓存 |
如果你对单卡消费级与数据中心级卡型的底层差异还不熟悉,可以延伸阅读本站的RTX 4090云服务器租用与扩容指南、A100租用实操指南以及H100/H200选卡与成本精算。
三、在 NexGPU 落地多模态与 AI Agent 的四步标准动作
很多初次接触GPU租用的开发者或从传统公有云迁出的团队,最头疼的就是“选卡像开盲盒”和“配环境耗掉一整天”。在 NexGPU(nexgpu.net),整套流程被简化为透明、可预期的四个步骤:
第一步:善用「模型选卡指南」与「场景做法页」反推硬件
不需要自己在论坛里到处翻帖估算显存。在开卡前:
- 打开 NexGPU 模型选卡指南,里面将主流开源模型按多模态视觉、OCR、AI Agent、文本大模型、图片生成、视频生成、语音识别、数字人、3D生成等品类做了精细归类。点进对应模型页(例如查看 Qwen 系列单模型页),页面直接写清了当前版本、量化后的显存门槛、推荐租哪张卡,以及从开卡、选镜像、拉权重到起服务的完整步骤。
- 如果你是按业务目标立项,可以直接访问 NexGPU 场景做法页,查看 AI Agents、大模型私有化部署、批量数据处理 等专题页,每页都明确列出了所需显存、推荐卡型、适用镜像与大致开销。
第二步:在 GPU 市场按真实指标筛卡,杜绝“显存不够硬开”
进入 NexGPU 价格与算力市场(详细选卡逻辑可参考官方文档 如何选择 GPU),你会看到每一行代表一台真实可租的物理机器或独占容器节点:
- 消费级与数据中心级分开列价:RTX 3090、4090、5090 等消费级显卡,与 A100、H100、H200、B200 等数据中心级显卡清晰分列,你可以按显存大小、价格、所在地区、可靠性、网络带宽、最少卡数自由筛选。
- 前置防呆提示:当你先选定环境模板再筛选机器时,系统会自动把显存不够的机器标出并注明具体原因,从源头上杜绝“开完机拉起模型才发现OOM”的尴尬。
- 算力与磁盘单价透明拆分:每台机器分开标出算力单价和磁盘单价;如果需要租用多卡节点跑百亿/千亿级多模态模型,多卡节点采用整机出租模式,下单金额 = 单卡价 × 卡数,账目一目了然。
第三步:选预置镜像开机即用,或挂载私有 Docker 镜像
多模态模型和 OCR 引擎往往对 PyTorch、CUDA 以及视觉依赖库版本非常挑剔。在 NexGPU 镜像模板库 中,所有模板不分档向全量用户开放,预装好驱动、CUDA、框架与依赖:
- 直接拉起 OpenAI 兼容接口:选择大模型推理分类下的 vLLM、SGLang、TGI 或 Ollama 模板(需要高吞吐生产环境部署可参考vLLM部署实战指南)。服务拉起后即为标准的 OpenAI 兼容接口(
/v1/chat/completions),无论是接入 LangChain、Dify 等 Agent 编排框架,还是用image_url传递 Base64 图像做批量 OCR 解析,业务代码无需任何改造即可无缝对接。 - 自定义 Docker 镜像应对版本锁定:如果你的多模态 OCR 项目或 Agent 工具链锁定了特定的 CUDA 版本或私有算子依赖,官网建议直接使用自己的 Docker 镜像——支持填写公开或私有仓库地址,并可自定义启动命令和环境变量。
第四步:直连调试、开放备用端口与可视化管理
实例启动后,你可以根据团队习惯选择最高效的连接方式(详见 连接实例文档 与 实例管理文档):
- 三种直连通道:支持浏览器内直接打开 root 权限的网页终端;支持SSH 直连(公网 IP 加端口直接连入,不经跳板机中转,且可预设默认公钥);若所选环境带有 Jupyter,可一键打开且已自动带好访问令牌。
- 公网 IP 与备用端口:每台实例自带公网 IP 和端口映射,并额外留有一组备用端口专门给你的自定义服务使用(例如同时暴露 vLLM 推理端口、OCR 预处理 API 端口与 Agent 监控面板端口)。注意:平台不支持在实例创建后增删端口映射或扩容磁盘,建议在创建实例时一步规划好所需磁盘容量与端口分配。
- 可选可视化面板:如果不习惯纯命令行管理海量的待解析 PDF 文档和模型权重,可以一键安装 aaPanel 可视化管理面板(会占用部分磁盘空间),直接在浏览器里管理文件上传下载、后台守护进程与定时批处理任务。
四、拒绝隐性收费:如何用“三项极简账单 + 停机保盘”压降 50% 算力成本?
回到文章开头提到的行业痛点:无论是初创企业还是个人开发者,最怕的就是算力空转和看不懂的复杂账单。NexGPU 的计费规则专为弹性工作流设计,帮助你实现精细到秒级的成本控制。
1. 账单只有三项,下单即锁定单价
在实例详情页中,费用明细被严格拆分为且仅包含三项:算力费、存储费、流量费。
- 无任何附加套路:没有最低消费、没有开通费、没有端口占用费、没有镜像授权费,也没有最短起租时长限制。
- 单价锁定机制:你在 价格页面 下单时的单价会一直锁定到该实例销毁为止,不用担心使用中途遭遇临时涨价。
2. 算力按秒计量,用“停机保盘”应对间歇性工作流
理解算力费与存储费的起止边界,是省钱的核心技巧:
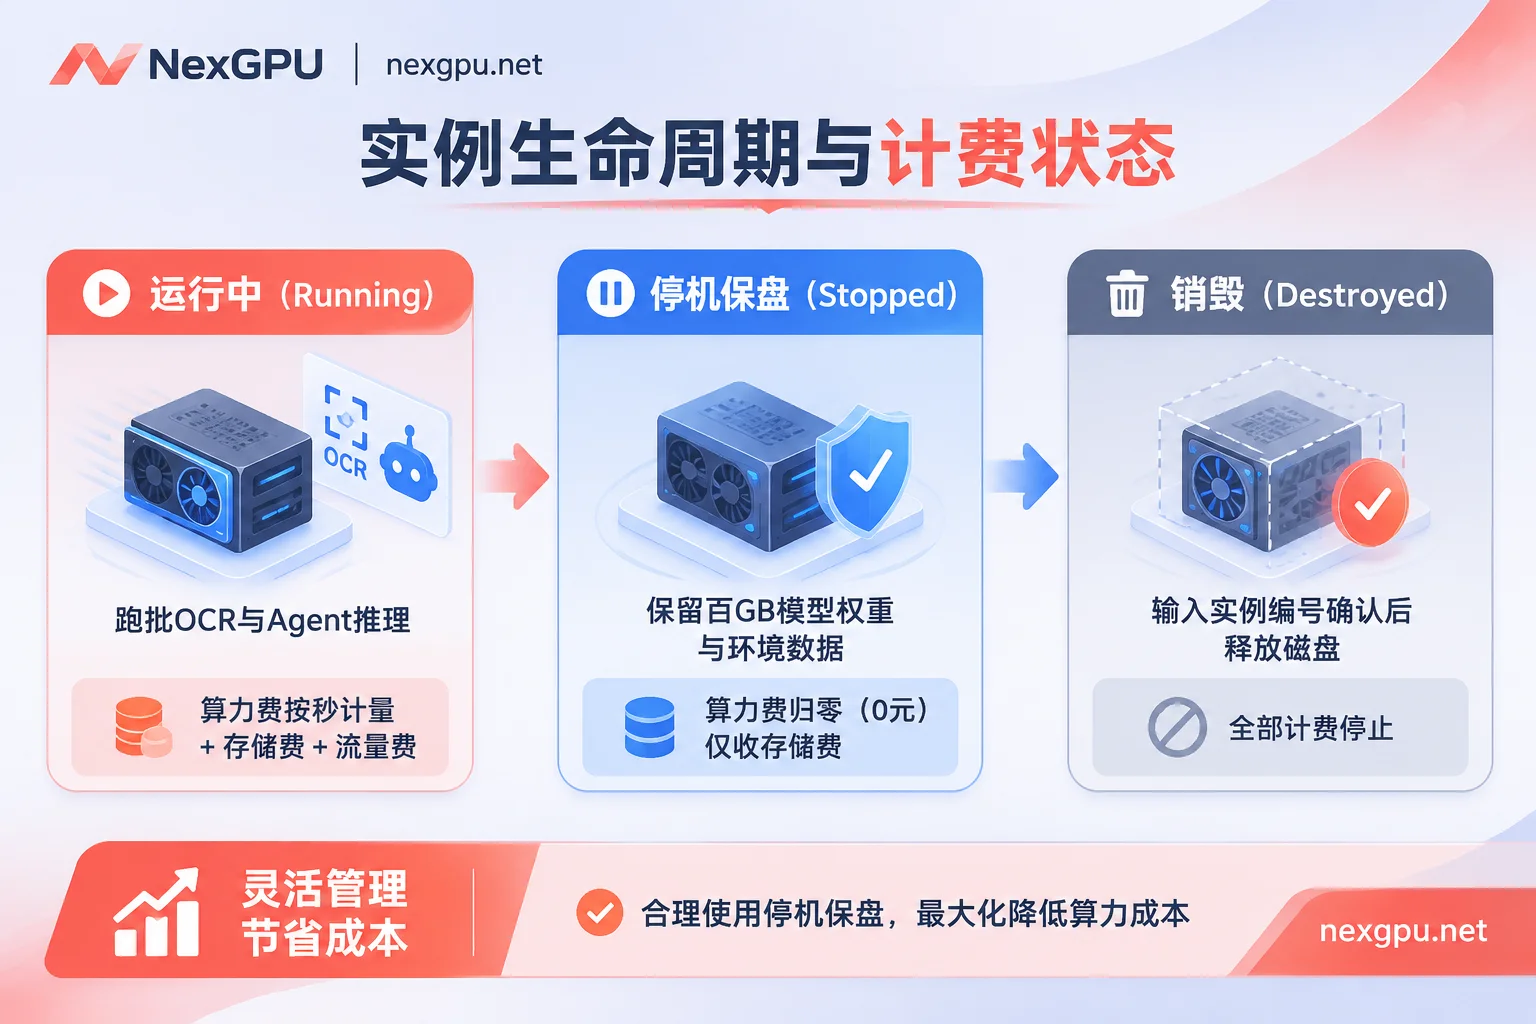
- 算力费:按秒计量、按小时计价。只有当实例正式进入“运行中”状态才开始计费;一旦执行停机或销毁,算力计费立即停止。
- 存储费:按 GB/月计费,从实例创建时起算(包括拉取镜像期间),停机后依然保留磁盘和数据并照常收取存储费,只有销毁实例才会停止计费并立即释放磁盘。
实战省钱打法:
假设你的团队搭建了一套“数百GB开源多模态权重 + 专有行业OCR清洗管线 + Agent测试环境”:
- 日常调试与跑批阶段:白天研发人员在线调试 Agent 轨迹,或夜间集中2小时跑完10万页扫描PDF的结构化解析。任务一结束,直接在控制台点击停机。
- 停机期间:昂贵的 GPU 算力费瞬间归零,你只需支付极低比例的磁盘存储费,而好不容易配好的环境、下载好的百GB模型权重和业务数据完好无损,第二天上班一键启动即可接着跑。
- 彻底结项阶段:当某个短期评测项目彻底结束、数据已导出完毕后,执行销毁(为防止误操作,系统要求输入实例编号确认;请注意平台不读取也不备份磁盘内容,销毁即释放磁盘且不可恢复,销毁前请务必通过 SSH 或面板迁出重要成果)。
此外,平台采用友好的预付费保护机制:当账户余额偏低时会提前发送预警邮件;即使余额耗尽,系统也会先自动停机(不立即销毁数据),只有负余额超过设定时长才会自动销毁,中途随时通过 USDT(TRC20)或支付宝 充值即可恢复运行。
五、从个人快速验证到企业级多卡集群的平滑演进
不同规模的团队在GPU租用上的诉求截然不同。NexGPU 通过统一的算力底座,支持从单兵作战到企业级集群的无缝跨越:
- 零门槛极速起步(创作者与独立开发者):只需邮箱注册,不需要繁琐的实名认证和漫长的配额申请;注册后不用绑定支付方式就能直接查看实时价格(详见 快速上手指南 与 常见问题 FAQ)。同时开启的实例数量没有人为上限,只受账户余额约束,非常适合同时拉起多台实例做不同视觉模型的 A/B 评测,或进行 Blender 与 3D 渲染分段并行加速。
- 多卡节点自助下单(微调与高并发推理团队):当单卡显存装不下百亿/千亿级原生多模态模型,或需要使用 DeepSpeed、FSDP、Megatron 进行后训练与强化学习微调(参考大模型训练与强化学习后训练选卡实操)时,可直接在 GPU 市场按最少卡数筛选 A100、H100、H200 等高显存多卡节点自助下单。
- 定制化企业方案(研发中台与算力采购):针对需要大规模长期部署私有化 AI Agent 平台或训练专属行业底座的企业,NexGPU 提供支持 RDMA 高速互联、数据隔离、私有网络与专属算力集群 的企业级方案;同时支持预留实例、包月包年、专属算力池,以及签署正式合同、对公付款与开票、PO 采购流程。如有定制需求,可直接通过 Telegram 联系中英双语客服,或访问 联系销售页面 通过邮件对接合同与开票事宜。
结语
2026年底的AI行业已经证明,算力不再是“盲目囤得越多越安全”的固定资产,而是需要精密匹配模型代际与业务波峰波谷的流动生产力。面对多模态视觉、长文档OCR与AI Agent带来的全新显存挑战,与其被不透明的长期合约或高昂的硬件折旧绑架,不如把算力交给按秒计量、配置透明的弹性市场。
现在就前往 NexGPU 模型选卡指南 或浏览 2026年GPU租用全流程指南,挑一张最契合你当前模型的显卡,几分钟内拉起你的专属多模态与智能体服务吧!


