 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
在开源大模型生态中,通义千问(Qwen)系列凭借极其丰富的模型矩阵,已经成为企业和开发者做私有化落地的首选之一。无论是覆盖轻量到中大型尺寸的 Qwen2.5 与 Qwen3 Dense 系列(如 7B、14B、32B、72B),引入混合专家架构(MoE)的 Qwen3-30B-A3B 与旗舰级 Qwen3-235B-A22B,还是专精强化学习推理的 QwQ-32B、多模态视觉理解的 Qwen2.5-VL,庞大的家族让它几乎能适配所有业务场景。
但型号丰富也带来了幸福的烦恼:做 Qwen 部署时,到底该选哪张 GPU 卡?
许多团队在落地初期都会经历类似的波折:用单卡跑 32B 模型时,刚拉长上下文就触发显存溢出(OOM);部署多模态 Qwen-VL 处理高分辨率图表或视频流时,视觉编码器与 KV Cache 瞬间吃光显存;或者在多卡节点上折腾 CUDA 驱动、编译 vLLM 与 SGLang,光环境对齐就耗费两三天。
要绕开“买贵了浪费预算”或“租小了跑不动”的坑,我们需要先把显存账算清楚,再把推理框架与算力租赁机制配合起来。本文将从架构显存核算、GPU 选型、推理引擎对比到云端实操,为你梳理一套零阻力的 Qwen 部署方案。
一、 算清显存账:不同尺寸与架构的 Qwen 模型怎么选 GPU?
在进行 Qwen 部署前,首先要明确显存(VRAM)的三大去向:模型权重 + KV Cache(上下文缓存) + 激活值与框架开销。对于新增了视觉模块的 Qwen-VL 系列,还需要额外预留视觉编码器(Vision Encoder)和处理高分辨率图像 Token 的显存。
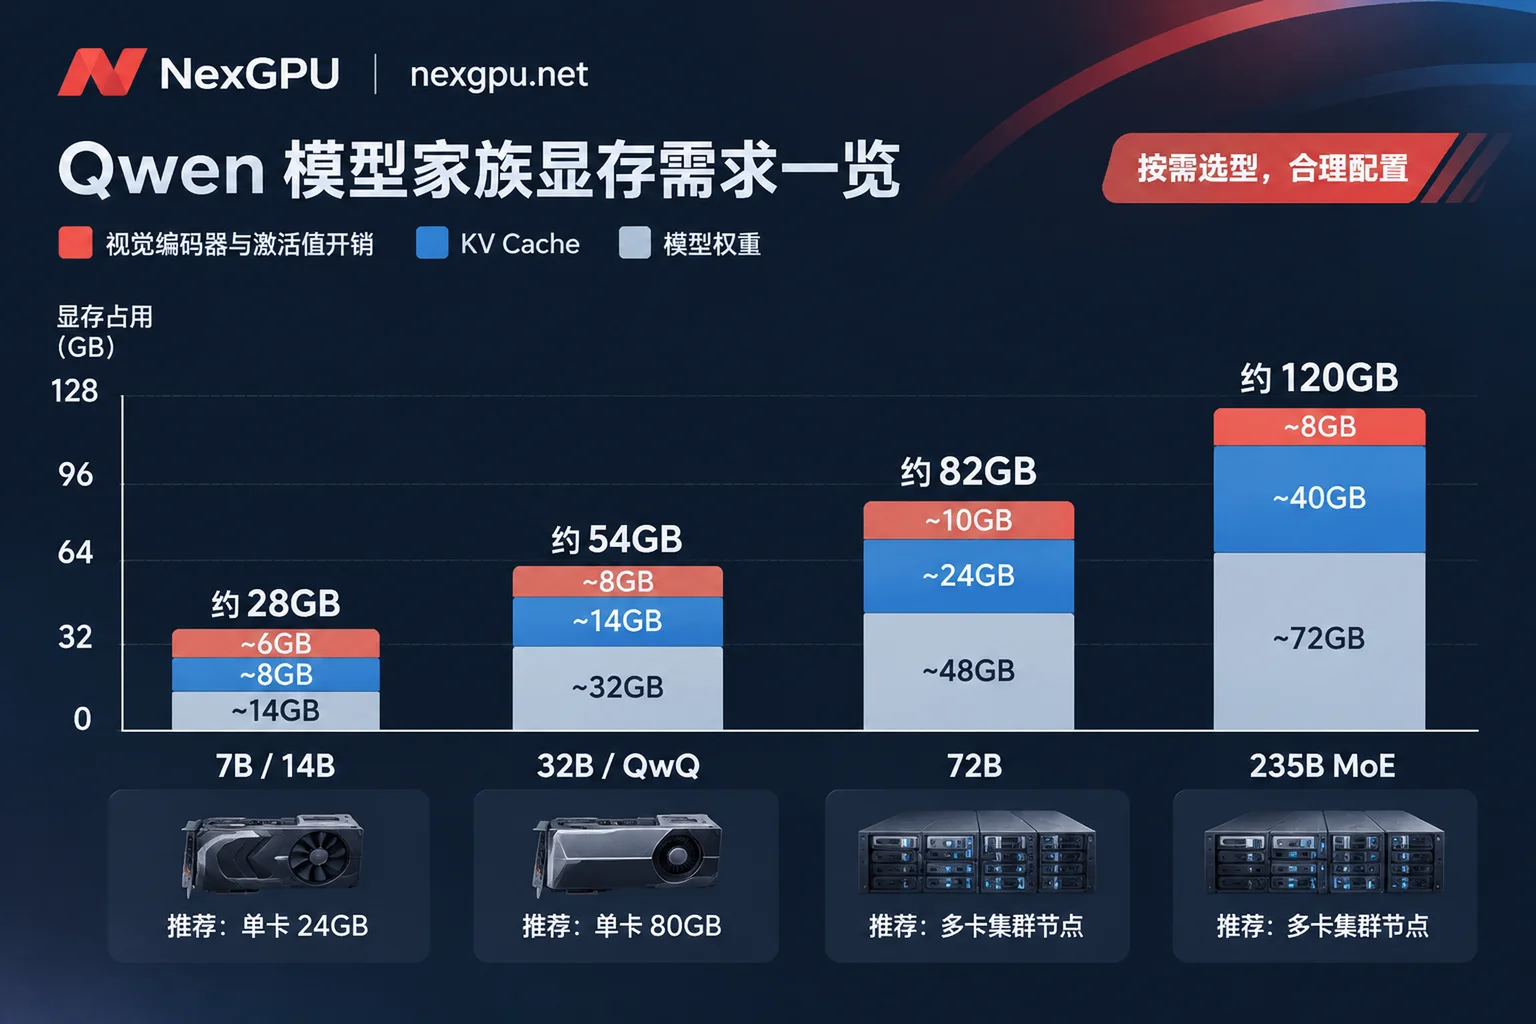
结合社区实测经验,我们可以将主流 Qwen 家族的硬件门槛划分为四个梯队(各模型的当前版本与量化后的精确显存门槛,建议直接查阅 NexGPU 模型选卡指南 或访问 Qwen 专属模型页 以官网实时数据为准):
1. 轻量级与单卡甜点区(7B / 14B / 30B-A3B MoE)
- 适用模型:Qwen2.5-7B / 14B、Qwen2.5-VL-7B,以及采用 MoE 架构的 Qwen3-30B-A3B(总参数 30B,单次激活仅 3B)。
- 显存需求:7B 模型在 FP16/BF16 半精度下权重约占 15GB~16GB,配合常规并发的 KV Cache,单张 24GB 显存显卡即可流畅运行;14B 模型半精度权重约 28GB~30GB,若通过 AWQ/GPTQ/GGUF 进行 4-bit(INT4)量化,显存占用可压至 10GB~12GB 左右。而 30B-A3B 这类轻量 MoE 模型通过 4-bit 量化后,同样能塞进单张大显存消费级显卡。
- 选卡建议:单张 RTX 3090(24GB)、RTX 4090(24GB) 或 RTX 5090。如果你对单卡 24GB 的承载极限拿不准,可以参考我们此前的《RTX 4090云服务器怎么租:24GB显存的能力边界、选卡防坑与单卡向多卡平滑扩容指南》。
2. 企业级主力与代码/推理甜点(32B Dense / QwQ-32B / VL-32B)
- 适用模型:Qwen3-32B、Qwen2.5-Coder-32B、QwQ-32B(强化学习推理模型)、Qwen2.5-VL-32B。
- 显存需求:32B 规模是目前企业兼顾“深度推理能力”与“推理成本”的黄金尺寸。在 FP16/BF16 全精度下,仅模型权重就需要约 64GB 显存,加上 32K~128K 长上下文的 KV Cache,总显存需求通常在 75GB~90GB 以上;若采用 INT4 量化,显存门槛可降至 20GB~24GB 左右,使单卡 24GB 勉强可跑,但在高并发或开启长思维链(Thinking Mode)时仍建议留足余量。
选卡建议:
- 量化测试/中小并发:单张 RTX 4090 / 5090(跑 INT4/GGUF 量化版),或 2×RTX 4090(48GB 总显存,跑 INT8 量化或长上下文 INT4)。
- 全精度/生产级高并发:单张 A100(80GB)、H100(80GB),或 4×RTX 4090 多卡节点。
3. 大尺寸复杂任务与长文本分析(72B Dense / VL-72B)
- 适用模型:Qwen2.5-72B、Qwen2.5-VL-72B、Qwen2.5-Math-72B。
- 显存需求:FP16 精度下权重高达 144GB 以上,即便使用 INT4 量化也需要 40GB~48GB 以上的显存空间。
- 选卡建议:量化版可选 2×RTX 4090 / 5090 或单张 A100 / H100(80GB);FP16 生产环境建议租用 2×A100 / H100(80GB) 或 H200 节点。
4. 旗舰级 MoE 与超大规模集群(Qwen3-235B-A22B)
- 适用模型:Qwen3-235B-A22B(总参数 2350 亿,激活参数 220 亿)。
- 显存需求:作为对标顶级闭源模型的旗舰版本,全精度或 FP8/INT4 部署均需跨卡并行。
- 选卡建议:在 NexGPU 算力市场 按“最少卡数”筛选 2~4 张 H100 / H200 或 4~8 张 A100 的多卡整机节点。如果对数据中心级大卡的代际差异感兴趣,可进一步阅读《2026年H100租用实战指南:供需反转下的选卡逻辑、A100/H200对比与成本精算》。
选卡防坑小贴士:在 NexGPU 创建实例时,如果你不确定某台机器能不能装下目标模型,可以在控制台“先选环境/模型再筛机器”——显存不够的机器会被系统自动标出并注明原因,直接从源头避免开机后才发现 OOM 的尴尬。详情可查阅如何选择 GPU 文档。
二、 推理框架怎么挑?Ollama、vLLM、SGLang 与 TGI 的场景对齐
选好显卡后,第二步是决定用什么推理引擎拉起服务。不同框架的底层调度逻辑差异极大,直接影响 Qwen 部署后的首字延迟(TTFT)和并发吞吐。
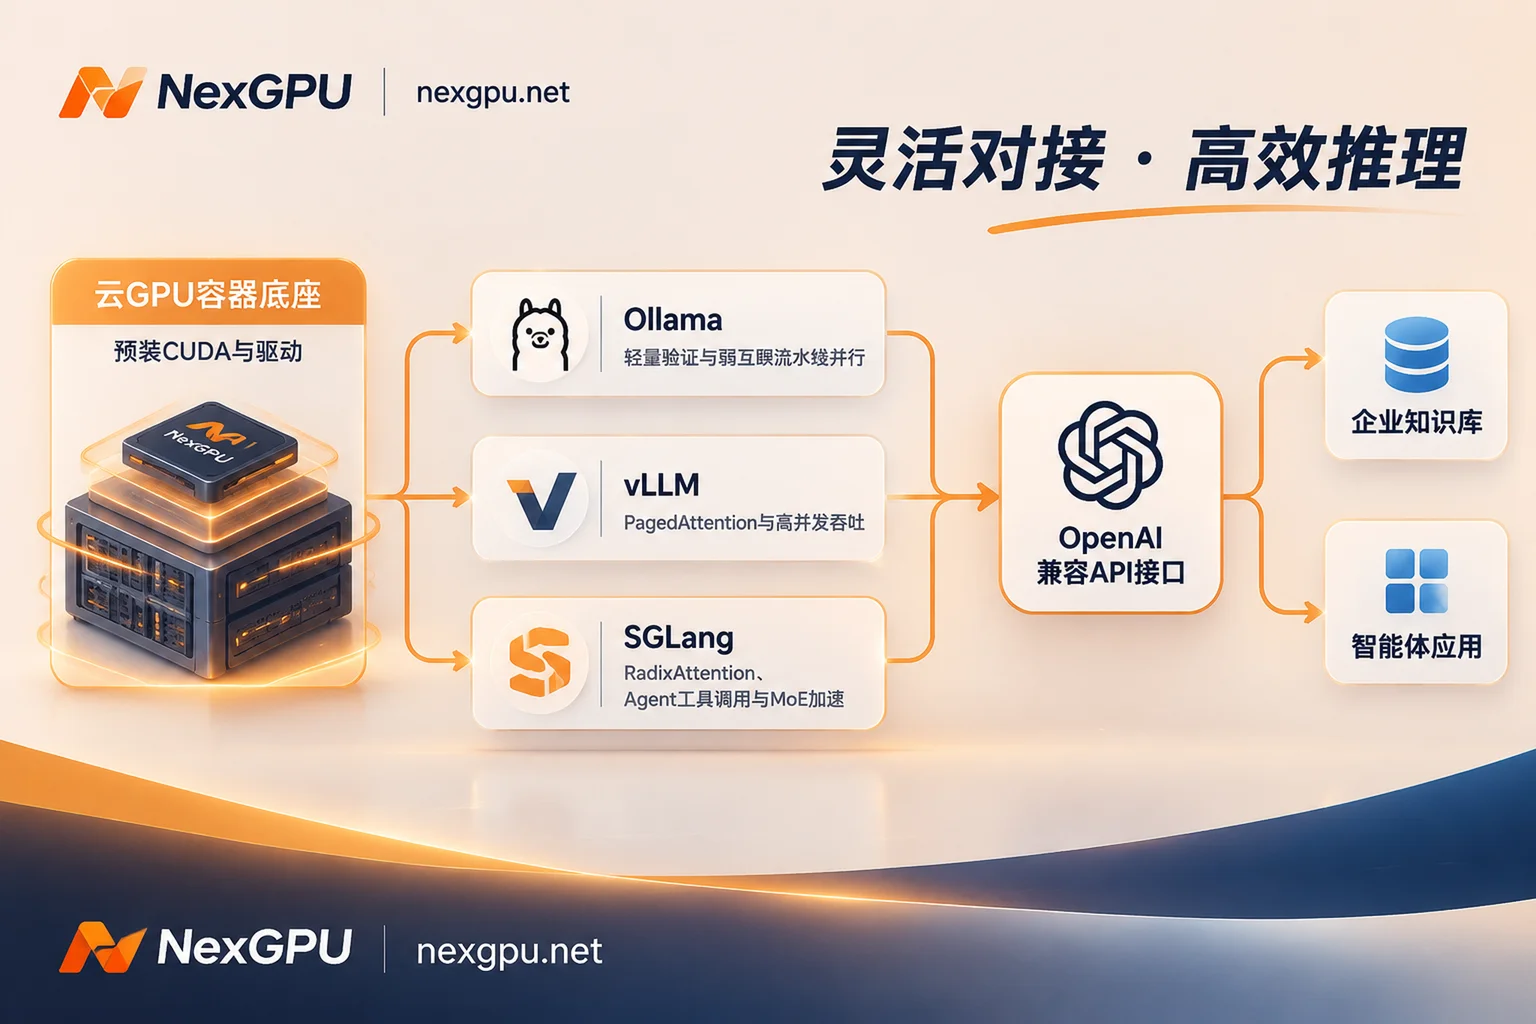
在 NexGPU 镜像模板库 中,“大模型推理”分类已预装了主流框架(驱动、CUDA 与依赖均已配齐,拉起后默认提供 OpenAI 兼容接口),你可以按以下业务特征直接对号入座:
Ollama:个人验证、内部工具与弱互联多卡兜底
- 特点:基于
llama.cpp,对 GGUF 量化格式支持极佳,一条命令即可拉起模型。 - 隐藏优势:在多张消费级显卡(无 NVLink,仅靠 PCIe 互联)跑 32B/72B 模型时,张量并行(TP)容易受限于跨卡高频通信开销;而 Ollama 默认倾向于按层切分的流水线并行(PP),每生成一个 Token 的跨卡通信次数极少,在弱互联环境下反而非常稳健。相关技巧可参考《Ollama 部署显存焦虑?如何按需租用 GPU 服务器,打造极致性价比的本地推理体验》以及《张量并行和流水线并行怎么选:按显存、卡间连接和并发三步判断》。
- 特点:基于
vLLM:高并发 API 服务与通用生产环境首选
- 特点:凭借 PagedAttention 机制,能将显存碎片率压到最低,在多用户并发请求下吞吐量优势明显。
- 适用场景:将 Qwen2.5 / Qwen3 接入企业知识库(RAG)、客服后台或代码补全插件。如果你正准备从本地测试转向生产交付,推荐阅读《vLLM部署实战指南:从Ollama迁到高并发生产环境,如何选卡、配镜像与开放OpenAI兼容接口》。
SGLang:Agent 多轮工具调用、结构化输出与 MoE 加速
- 特点:专为复杂大模型程序设计的引擎,其 RadixAttention 支持自动跨请求复用 KV Cache 前缀。
- 适用场景:当你用 Qwen3 构建 AI Agent(高频触发 Function Calling / Tool Call,有着大量相同的 System Prompt 前缀)、要求严格的 JSON 结构化输出,或者部署 Qwen3-30B-A3B / 235B-A22B 等 MoE 模型及 Qwen2.5-VL 多模态模型时,SGLang 往往能显著压低首字延迟。
自带 Docker 镜像:应对特定版本锁定
- 如果你的业务代码对 CUDA 版本、PyTorch 版本或特定分支的
transformers有严格锁定,官网建议直接在模板页填写你自己的 Docker 镜像(支持公开或私有仓库),并自定义启动命令和环境变量。
- 如果你的业务代码对 CUDA 版本、PyTorch 版本或特定分支的
三、 在 NexGPU 落地 Qwen 部署的四步实操流程
传统云厂商租用 GPU 往往伴随着繁琐的实名认证、漫长的配额申请工单,以及令人头疼的驱动安装与端口安全组配置。在 NexGPU,整个流程被压缩到了分钟级(完整图文引导可查看快速上手文档):
第一步:免实名注册与透明比价
只需使用邮箱注册账号,不需要实名认证,也不需要提交 GPU 配额申请。注册后即可进入 GPU 算力市场 查看实时价格,无需预先绑定支付方式。充值支持 支付宝 与 USDT(TRC20),同时开启的实例数量不受限制(仅受账户余额约束)。
第二步:按硬指标筛卡与选镜像
在算力列表中,每一行代表一台真实可租的物理机器,消费级(RTX 3090、4090、5090 等)和数据中心级(A100、H100、H200、B200 等)分开列价,且每台机器均分开标出算力单价和磁盘单价。
- 你可以按显存大小、价格、所在地区、可靠性、网络带宽、最少卡数进行精准筛选。
- 若需部署 Qwen3-32B 全精度或 72B/235B 模型,选择多卡节点整机出租,下单金额即等于
单卡价 × 卡数。 - 选定机器后,直接勾选预置的 vLLM / SGLang / Ollama 推理模板;若后续还打算基于自有业务语料做 LoRA 或全量微调,也可以随时开一台预装了 LLaMA Factory、Unsloth 或 Axolotl 的训练与微调镜像(微调选卡逻辑可参考《大模型微调GPU怎么选:按显存账、微调方法与开源框架三步定卡》)。
- 注意磁盘规划:由于平台不支持实例创建后扩容磁盘,请在开机前预留充足的存储空间(例如跑 32B 模型建议预留 100GB 以上磁盘,以便存放权重文件与缓存)。
第三步:直连实例与拉起 OpenAI 兼容服务
实例开机后,系统默认提供三种无障碍连接方式(详见实例连接文档):
- 网页终端:直接在浏览器里打开 root 终端,无需本地配置客户端。
- SSH 直连:每台实例自带公网 IP 加端口,不经跳板机直接连接,支持预先设置默认 SSH 公钥。
- Jupyter 一键直达:若所选环境带有 Jupyter,点击即可一键打开且自动带好认证令牌。
如果你习惯图形化运维,还可以在实例中一键安装可视化管理面板(aaPanel),在浏览器里直观管理模型权重文件、监控推理进程与配置计划任务(注:安装面板会占用一定磁盘空间)。
第四步:端口映射对接 Dify / OpenWebUI 等业务端
除了默认连接端口外,每台实例还另留有一组备用端口专门给用户自己的服务使用(注意:创建后不支持增删端口映射,直接使用分配好的备用端口即可)。
当你在终端里用 vLLM 或 SGLang 将 Qwen 模型服务绑定到 0.0.0.0 及对应的内部备用端口后,外部的 AI Agents 编排平台(如 Dify、LangChain、FastGPT)或前端界面(OpenWebUI)就能直接通过 http://<公网IP>:<映射外部端口>/v1 调用你的私有化 Qwen 接口,实现完整的大模型私有化部署闭环。
四、 成本精算与运维避坑:如何把每一分算力预算花在刀刃上?
做 Qwen 部署不仅要“跑得通”,更要“用得起”。很多开发者在其它平台踩过隐形收费的坑,而在 NexGPU,计费规则保持极简透明(详见计费说明文档):
- 账单只有三项:实例详情页分项列出算力费、存储费、流量费。没有任何最低消费、开通费、端口费或镜像授权费,也没有强制起租时长。
- 按秒计量与单价锁定:算力费按秒计量、按小时计价,实例进入“运行中”才开始计费,停机或销毁立即停止计算算力费;且下单时的单价会一直锁定到该实例销毁,不受后续市场波动影响。
- 善用“停机保盘”省下非工作时间开销:
在研发联调阶段,你可能只有白天需要调用 Qwen 接口测试 Agent 链路。下班时只需在控制台点击“停机”(详见实例管理文档),此时算力费立即停收,系统会完整保留你的磁盘与已下载好的几十 GB Qwen 权重数据(停机期间仅按 GB/月照常收取低廉的存储费),第二天上班一键再启动即可无缝衔接。 - 余额保护机制:采用预付费模式,余额偏低时会发送预警邮件;万一余额耗尽,系统会先自动停机(不销毁数据),只有负余额超过设定时长才会自动销毁,中途充值即可原地恢复业务。
- 数据安全与销毁提醒:每个实例均为独占容器,平台绝不读取也不备份用户的磁盘内容。因此,当你不再需要某台机器、输入实例编号确认“销毁”前,请务必将微调好的权重或业务日志自行导出——销毁操作会立即释放磁盘以停止存储计费,且数据不可恢复。
五、 从单机验证走向多卡集群与企业级交付
当你的 Qwen 应用通过了 MVP 验证,并发量开始攀升,或者需要部署 Qwen3-235B-A22B 这类巨型模型以及使用 DeepSpeed、FSDP、Megatron 进行分布式训练时,算力架构也需要同步升级。
- 自助开启多卡高显存节点:在 GPU 市场中直接按最少卡数筛选 4 卡或 8 卡的 A100、H100、H200 节点自助下单。若在多卡并联时遇到吞吐未达预期,可参考本站技术专栏的《多卡推理吞吐没有翻倍是什么原因?按并行方式、并发和互连三步排查》与《MoE 模型专家负载不均怎么排查:先分清训练还是推理,再逐层定位》。
- 企业专属方案:对于对数据合规与网络延迟有严苛要求的研发团队和算力采购方,NexGPU 提供支持 RDMA 高速互联、数据隔离、私有网络、专属算力集群 的企业级方案。
- 灵活商务支持:如需预留实例、包月包年折扣、专属算力池,或需要签订正式合同、对公付款与开票、走 PO 采购流程,可直接通过 联系销售页面 或官方中英双语客服(支持 Telegram 直接沟通,合同与开票走邮件)快速对接。
无论你是第一次租卡跑 7B 多模态模型的独立创作者,还是正在为企业规划 32B/235B 私有化底座的架构师,现在就可以前往 NexGPU 模型指南 核对显存配置,选好预置镜像,几分钟内拉起属于你的高性能 Qwen 推理服务。


