 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
在语音识别(ASR)领域,OpenAI 开源的 Whisper 依然是 2026 年多语种转写、会议纪要生成、播客字幕对齐和客服质检的首选底座。但很多开发者和团队在真正把业务搬上 GPU 服务器时都会遇到同一个断层:在本地或测试环境跑通一个 transcribe.py 脚本只花了十分钟,可一旦面对几百小时的历史录音积压,或者要对外提供高并发 API 服务,立刻就会陷入“GPU 利用率只有 15%、长音频频频幻觉重复、云厂商包月显卡大半时间在空转烧钱”的泥潭。
如果你还在纠结原生 Whisper、faster-whisper 和 WhisperX 的基础显存账与显卡门槛,可以先看我们之前的《Whisper部署怎么选方案和GPU:从原生Whisper、faster-whisper到WhisperX的显存与选卡指南》。
本文将直接往前迈一步,聚焦 “从脚本跑通到生产交付” 的工程实战:在 2026 年的技术栈下,如何根据业务场景匹配 large-v3 与 large-v3-turbo?如何把单卡吞吐榨干?以及如何利用按小时计费的弹性 GPU 算力,把每百小时的音频转写成本压到商用 API 的十分之一以下?
一、2026 年做 Whisper 部署,为什么不能只跑一个“裸脚本”?
很多初次做 Whisper 部署的团队,第一反应是在云端开一台带卡的虚拟机,拉下官方权重,写个循环逐个读取音频文件。这种做法在生产环境中会迅速撞上三堵墙:
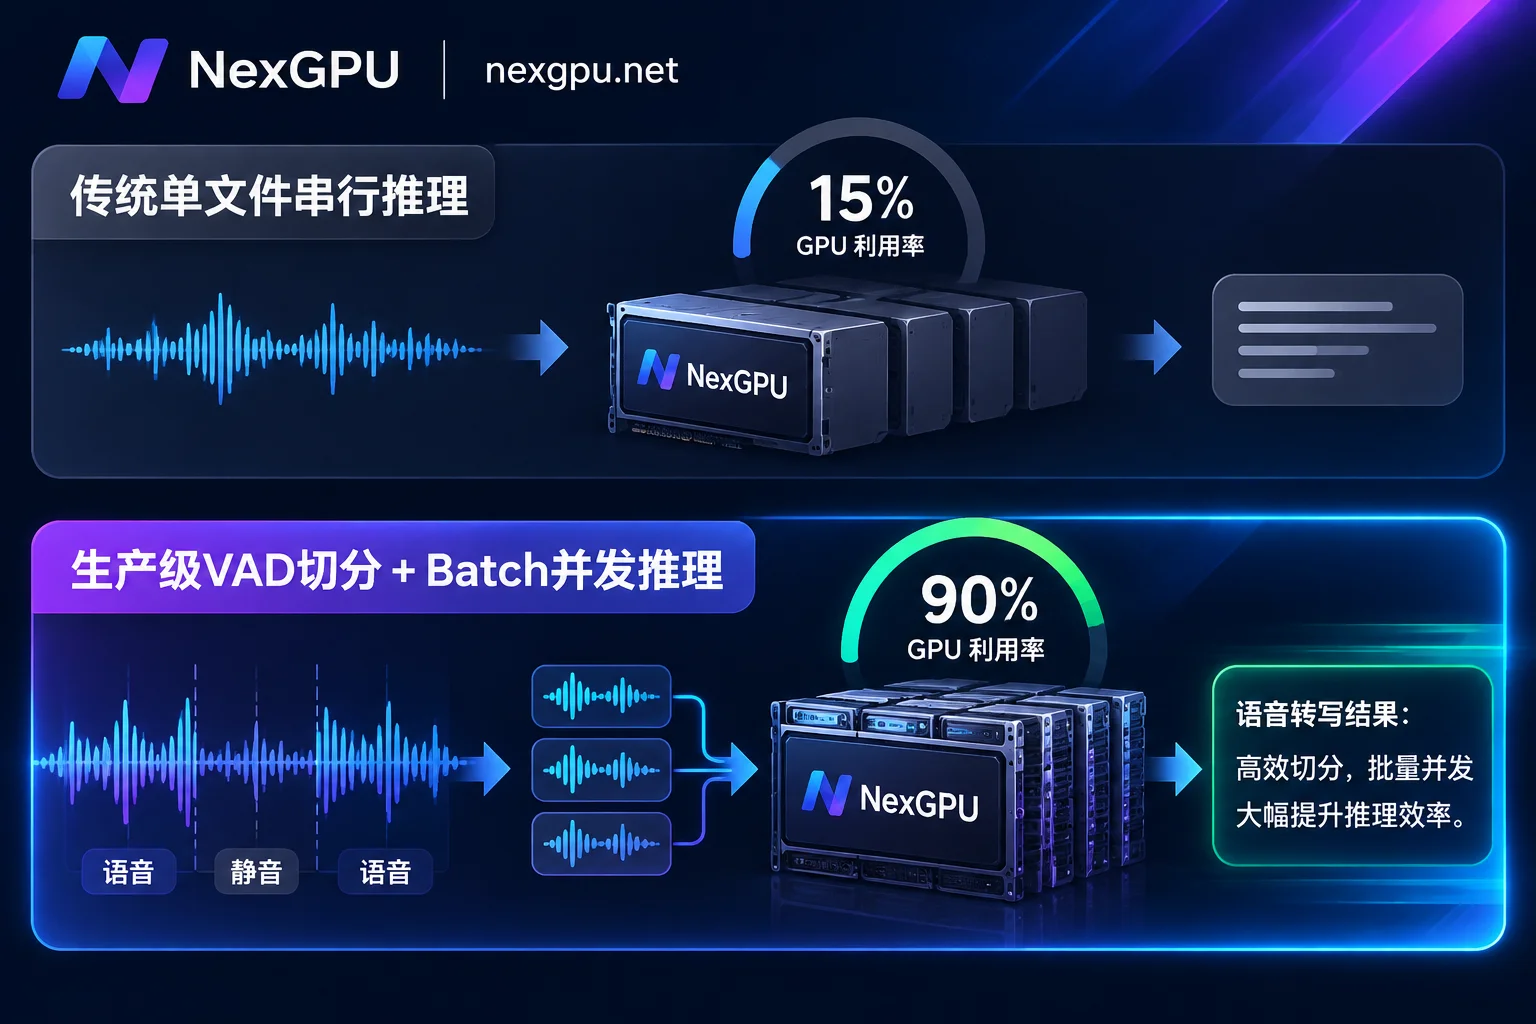
- 解码器自回归带来的算力闲置:Whisper 是标准的 Encoder-Decoder 架构。如果按单条音频顺序串行推理(Batch Size = 1),哪怕你租了一张 RTX 4090 或 A100,显卡的流处理器大部分时间都在等待内存带宽读取权重,GPU 核心利用率往往常年徘徊在 10%~20%,算力费花出去了,转写速度却上不来。
- 长音频静音段的“死亡复读机”幻觉:原生 Whisper 以 30 秒为滑动窗口。当会议录音或电话录音里出现较长的背景噪音或停顿时,如果没有前置的 VAD(语音活动检测)切分,解码器极易陷入无限循环的重复台词,甚至把整段时间戳全部带偏。
- 潮汐流量下的高昂闲置成本:语音转写业务天然具有极强的“波峰波谷”属性——比如每天凌晨集中处理前一天积压的数千通客服录音,或者自媒体团队每周集中两三天压制多语种视频字幕。如果为此常年包月租用固定配置的云服务器,超过 70% 的预算其实都在为闲置时间买单。
要解决这些问题,需要同时从模型权重迭代、推理运行时(Runtime)并发架构以及算力调度方式三个维度入手。
二、模型与推理引擎的黄金组合:按业务形态对号入座
到了 2026 年,一刀切地部署 whisper-large-v3 已经不再是最优解。结合当前开源社区成熟的工程方案,我们在生产环境中通常按以下三种业务流来定技术栈:
1. 权重选型:large-v3 还是 large-v3-turbo?
OpenAI 推出的 whisper-large-v3-turbo 将解码器(Decoder)从原本的 32 层大幅裁剪到了 4 层,参数量从 15.5 亿缩减至约 8.09 亿,而编码器保持不变。
- 什么时候无脑上
large-v3-turbo:绝大多数纯语音转文字(同语种转录)场景。因为自回归解码层数减少了 87.5%,它在 GPU 上的推理速度比完整版large-v3快数倍,显存占用直降约 40%(FP16 下约 6GB 显存即可轻松跑起),且词错率(WER)几乎与large-v3持平。 - 什么时候必须留着
large-v3:跨语种直接语音翻译(例如直接把日语音频流端到端输出为英文字幕)。由于turbo版在裁剪微调时剔除了翻译任务的数据,涉及跨语种直译或极重度方言口音的兜底场景,依然需要完整版 32 层解码器的large-v3,或者采用“turbo极速转写 + 轻量级本地 LLM 翻译”的两阶段流水线。
2. 三大主流生产级推理栈怎么选?
| 业务场景 | 推荐引擎栈 | 核心工程优势 | 典型显卡与选卡方向 |
|---|---|---|---|
| 海量离线音频批量转写 (播客归档、网课字幕、历史录音清理) | faster-whisper (CTranslate2 后端 + BatchedInferencePipeline) | 支持 INT8/FP16 混合精度量化与上下文感知批处理(Batching),显存省、吞吐比原生快 4 倍以上。 | 消费级高性价比卡(如 RTX 3090 / 4090)单卡或多实例并行 |
| 多人会议纪要与访谈精修 (需区分“谁在什么时间说了哪句话”) | WhisperX (faster-whisper + wav2vec2 + pyannote) | 集成强制音素对齐与说话人分离(Speaker Diarization),解决词级时间戳漂移,自带静音 VAD 过滤防幻觉。 | 显存需兼顾对齐与声纹模型,建议 24GB 显存及以上消费级或数据中心卡 |
| 高并发实时 API 网关 (多客户端同时发起短语音请求、智能体语音入口) | vLLM (Whisper 支持) (Continuous Batching + FP8 KV Cache) | 借用大模型推理的连续批处理、CUDA Graphs 与 torch.compile,支持 OpenAI 兼容的 /v1/audio/transcriptions 接口,高并发吞吐极强。 | 支持 FP8 与高计算密度的显卡(如 RTX 4090、RTX 5090 或数据中心级大卡) |
💡 选卡与模型参考:如果你不确定特定量化精度下各模型权重的准确显存占用,可以直接查阅 NexGPU 的模型选卡指南,里面针对语音识别、语音合成及文本大模型整理了详细的版本显存门槛与部署步骤;也可以直接前往音频转文字场景做法页查看完整方案配置与开销估算。
三、在 NexGPU 零阻力落地 Whisper 生产环境(四步实操)
自己从零配置 Whisper 生产环境,最让人头疼的往往不是 Python 代码,而是底层依赖地狱——特别是 CTranslate2、cuDNN 版本冲突,以及 ffmpeg 编解码库缺失导致的报错。在 NexGPU 上,你可以通过预置镜像与灵活的网络配置,在几分钟内拉起一套生产级转写服务。
第一步:选定预置镜像(免去 CUDA 与环境踩坑)
进入 NexGPU 的镜像模板库,你不需要从空白系统开始折腾驱动:
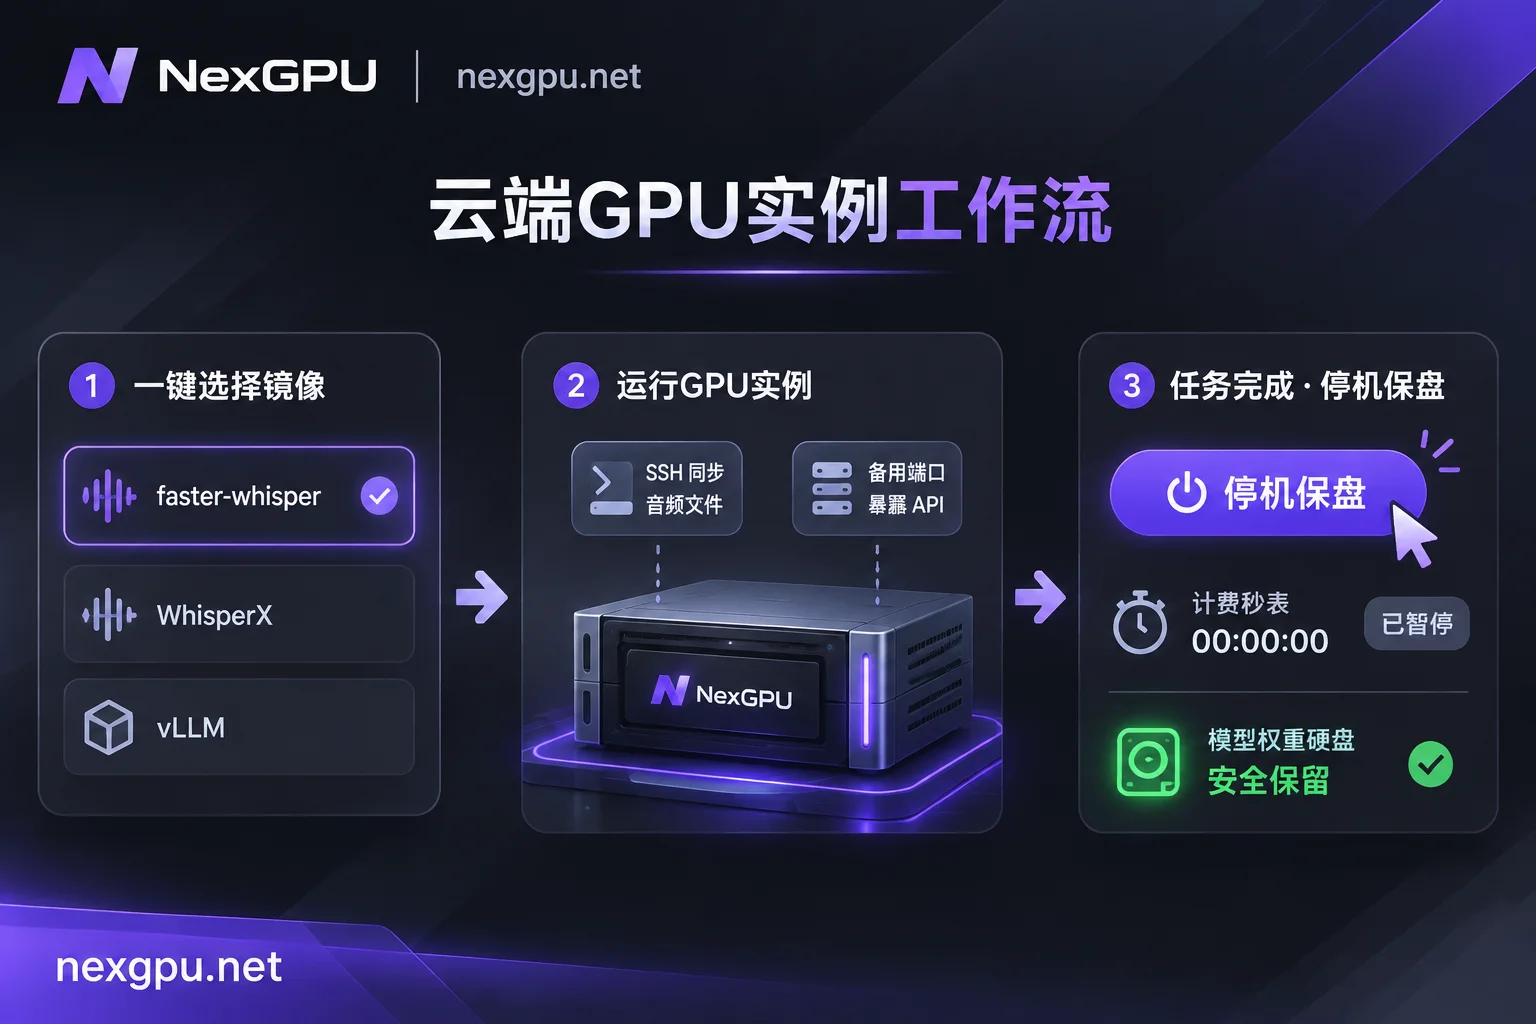
- 跑批量任务或带说话人分离:直接在“语音”分类下选择预置的 Whisper / faster-whisper / WhisperX 模板。镜像内已经预装好匹配的 NVIDIA 驱动、CUDA 环境及核心语音依赖,开机即可直接调用。
- 搭高并发在线 API 网关:如果打算用 vLLM 统一承载语音与文本接口,可以选择“大模型推理”分类下的 vLLM 模板(拉起后原生提供 OpenAI 兼容接口)。
- 企业自定义环境:如果你们团队已经将业务代码、特定版本的 CUDA 依赖与 FastAPI 封装成了标准生产容器,也可以直接在创建实例时填写自己的 Docker 镜像(支持公开或私有仓库),并自定义启动命令与环境变量。
第二步:在 GPU 市场按需精准筛卡
先选好镜像环境再进入 GPU 市场,系统会自动帮你过滤风险——显存不够运行该环境的机器会被自动标出并注明原因,彻底避免“开完机才发现 OOM(显存溢出)”的尴尬。
在筛选机器时,每一行代表一台真实可租的物理节点,你可以根据业务特性灵活调配(详细选卡逻辑可参考如何选择 GPU 文档):
- 算力与磁盘单价透明分列:批量处理几百 GB 的
.wav原始录音文件时,重点关注带宽和磁盘单价,挑选高带宽节点能大幅缩短音频上传与拉取 HuggingFace 模型权重的时间。 - 消费级与数据中心级分开列价:日常跑
faster-whisper或WhisperX,租用消费级的 RTX 3090、RTX 4090 或 RTX 5090 性价比极高;如果是企业级海量积压队列或需要与大参数 LLM 同机串联,则可切换至 A100、H100、H200 等数据中心级显卡(若想了解多卡与大显存卡的成本细节,可延伸阅读《RTX 4090云服务器怎么租》与《2026年A100租用指南》)。
第三步:连接实例、管理大体积音频与暴露 API 端口
实例开机后,NexGPU 提供了多种符合开发者直觉的连接与管理方式:
- SSH 直连与网页终端:每台实例均配备独立公网 IP 与端口,支持不经跳板机的 SSH 直连(可预设默认公钥),方便你直接用
rsync或scp高速同步本地音频目录;在外移动办公时,也可以直接点开浏览器里的 root 网页终端或一键带令牌打开 Jupyter 调试代码。 - 可视化管理面板(aaPanel):如果你不习惯纯命令行管理成千上万个音频切片和定时任务,可以在实例中一键安装 aaPanel 可视化面板(仅占用少量磁盘空间),直接在浏览器里拖拽管理音频文件、监控后台转写守护进程、配置 Cron 计划任务。
- 备用端口映射暴露服务:当你用 FastAPI 或 vLLM 把 Whisper 封装成 HTTP 微服务后,可以直接绑定实例预留的备用端口。通过公网 IP 加映射端口,你的业务后端或工作流(如 Dify、n8n)就能直接发起远程转写调用(需注意:端口映射在实例创建后不可增删,建议开机时规划好所需端口)。
第四步:性能调优的两个关键工程参数
在实例跑起来后,检查详情页的实时负载监控(可参考实例管理文档)。如果发现显存还空着一大半,调整以下两个参数就能让吞吐量翻倍:
- 开启 Batched 推理与 VAD 过滤:在
faster-whisper中使用BatchedInferencePipeline,将batch_size调至 16 或 32(视 24GB 显存余量而定),并务必开启vad_filter=True。这不仅能切掉无意义的静音段防止复读机幻觉,还能把有效语音片段拼成紧凑的 Batch 送入 GPU,瞬间把显卡利用率拉满到 85% 以上。 - 多 Worker 并发喂数:音频解码(FFmpeg 将 MP3/AAC 转为 PCM 特征)是典型的 CPU 密集型操作。如果单进程读取音频,往往是“GPU 等 CPU”。在启动服务时合理配置
num_workers或采用异步队列预处理音频,才能真正消除 I/O 瓶颈。
四、精算师视角:如何把语音转写成本砍掉 90%?
按 OpenAI 官方 Whisper API 的标准定价(约 $0.006 / 分钟),转写 100 小时的音频需要 **$36.00;如果是 10,000 小时的企业录音库,仅 API 调用费就高达 $3,600**。而在自建 GPU 实例上,借助 faster-whisper 配合 large-v3-turbo 的批处理能力,一张主流 GPU 在 1 小时内就能轻松吞吐数十乃至上百小时的音频,折算下来的硬件算力成本往往不到商用 API 的十分之一。
为了把这份成本优势彻底落袋,你需要用好 NexGPU 的弹性计费机制:
按秒计量 + 停机保盘(应对潮汐任务的神器)
NexGPU 的账单极其干净,只有算力、存储、流量三项,没有任何最低消费、开通费或起租时长限制,且下单时的单价会一直锁定到该实例销毁。- 当你每天跑完 2 小时的批量录音转写后,直接在控制台点击“停机”。
- 停机瞬间,算力费立即停止计费;而你下载好的几十 GB 模型权重(如 Whisper 权重、pyannote 声纹模型)以及配置好的 Python 环境会完好地保留在磁盘中(停机期间仅按 GB/月收取极低的存储费)。
- 第二天有新音频入库时,一键重新启动实例,省去重新拉取镜像和下载权重的时间,真正做到“跑任务时按秒付算力费,平时只花几毛钱养盘”。
多实例并发横向拆解“历史大积压”
由于在 NexGPU 上同时开启的实例数量不受配额限制(仅受账户余额约束,无需漫长的实名认证和工单配额申请),当你突然接到一个“明天早上前必须转写完 2000 小时访谈录音”的紧急任务时,不需要去抢昂贵的顶级豪卡。你可以直接用同一个预置镜像同时开启 10 台高性价比的消费级单卡实例,把音频列表均分成 10 份并行跑完,任务结束后全部销毁实例(输入实例编号确认后,磁盘立即释放,所有计费归零)。⚠️ 数据安全与防丢提醒:NexGPU 的实例均为独占容器,平台绝不读取也不备份用户的磁盘内容。由于平台不提供自动数据备份功能,且实例一旦销毁磁盘数据立即不可恢复,在执行销毁操作前,请务必确认转写生成的
.srt/.json文本结果已经全部同步回你的本地或对象存储中。同时,由于实例创建后不支持在线扩容磁盘,建议在开机初期就为原始音频预留充足的磁盘空间。- 企业级与大规模流水线扩展
如果你在做的是“ASR 语音转写 + 本地大语言模型会议摘要 + TTS 语音合成”的全链路私有化部署(例如搭配 Qwen 或 DeepSeek 模型,可参考我们的《Qwen 部署实战指南》与《vLLM部署实战指南》),需要多卡节点整机租用、私有网络数据隔离、专属算力池,或者需要签合同、对公付款与开具发票,可以直接前往联系销售页面定制企业方案。
五、结语:现在就开始你的低成本高吞吐部署
从实验室里的单条音频测试,到生产环境里稳定吞吐千万分钟的语音流水线,Whisper 部署的核心从来不是“能不能跑起来”,而是“如何用更少的显存、更高的批处理并发、更弹性的算力调度,把单位时间的转写成本压到极致”。
如果你正准备搭建自己的语音转文字服务,或者想把昂贵的外部 ASR API 替换为自主可控的开源方案,现在就可以通过邮箱快速注册(无需绑定支付方式即可查看全部实时价格,充值支持支付宝与 USDT),对照快速入门指南,在 NexGPU 算力市场选一张心仪的显卡,5 分钟内跑通你的第一条高并发 Whisper 生产流水线。


