ComfyUI 跑 Flux 显存不足怎么办?量化、启动参数与选卡边界

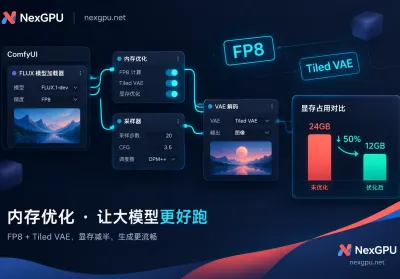
为什么 FLUX.1 在 ComfyUI 里容易爆显存FLUX.1(dev 或 schnell)采用约 120 亿参数的 Diffusion Transformer 架构,全精度(FP16/BF16)权重文件本身就需约 24GB 显存。加载后还要同时运行体积接近 10GB 的 T5-XXL 文本编码器,以及在高分辨率解码阶段调用 VAE,峰值显存需求轻...

跑 FLUX 显存不够怎么降门槛:按 8G/12G/16G/24G 分档给做法

先把结论摆出来,你可以直接跳到自己那一档:16GB 显存:主干换 FP8,文本编码器换 fp8 版本,1024×1024 基本能跑满流程,画质损耗很小。10~12GB:GGUF Q5_K_M 或 Q4_K_S 主干 + fp8 的 T5,配合 ComfyUI 的低显存模式。8GB:GGUF Q4 档 + fp8 T5 + CPU 卸载,能出图,但要接受...

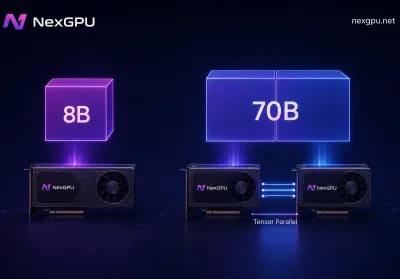
Llama 模型部署实操:选卡、vLLM 开服、多卡切分与停机费用边界

自部署 Llama 系列,真正卡住人的不是命令,而是三个判断:这个模型在你选的精度下要多少显存、单机单卡还是得切多卡、以及跑完之后账单从哪一刻停。把这三件事定下来,剩下的部署过程大概二十分钟就能跑通。下面按你实际动手的顺序来。先把显存账算完,再去挑卡显存需求由两部分构成:权重占用 + KV 缓存。权重那部分可以直接估算,参数量 × 每参数字节数,FP1...

FlashAttention-3显存与速度优化怎么做?4步实测

FlashAttention-3显存与速度优化只压缩注意力中间矩阵的 HBM 读写,不减权重和 KV Cache,且加速收益绑定 Hopper 架构(H100/H200)。PyTorch 官方博客 2024 年 7 月的测试数据显示,FP16 下 H100 算力利用率从 FA2 的 35% 提升到 75%(740 TFLOPS),FP8 吞吐接近 1....
FP8与INT4量化对GPU显存的影响有多大?4笔账分开算

先回答:量化省的不是同一块显存,收益也不能简单相加要算清FP8与INT4量化对GPU显存的影响,第一步先把显存占用拆成四笔互不替代的账:权重占的固定空间、随并发与上下文线性增长的KV Cache、计算过程中的中间张量、以及推理引擎与CUDA上下文的常驻开销。权重量化压的是第一笔,FP8 KV Cache压的是第二笔,中间张量与常驻开销基本不随量化下降—...