大模型训练GPU怎么选:先算显存账,再定互联和卡数

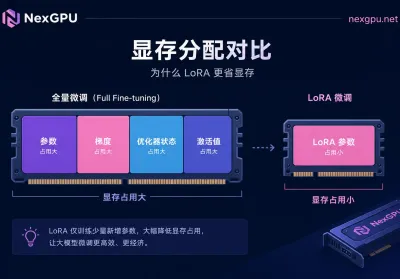
同一个 7B 模型,QLoRA 微调一张 24GB 消费级卡就能跑,全参数微调却要好几张 80GB 卡加参数切分。差别不在模型本身,而在训练时显存里到底装了几样东西。所以选卡的顺序永远是:先确定用哪种训练方式,再算显存账,最后才决定卡数和互联。四档训练方式对应的卡位先给一个可以直接对照的起点,具体到某个模型的显存门槛,官网的模型选卡指南按模型列得更细,...

云端GPU长任务中断恢复与Checkpoint设置:4步配置

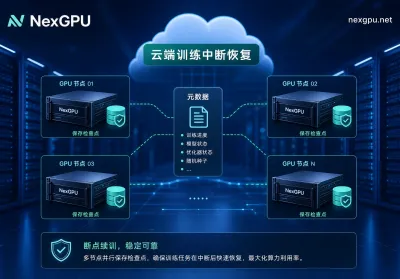
先估算两笔时间:单次保存检查点的耗时,以及中断后回退重算的耗时。把这两笔账合起来,除以平均中断间隔(MTBI),得到的就是业界通用的 Checkpointing Badput 指标。配置云端GPU长任务中断恢复与Checkpoint设置,就是把 Badput 压到可接受区间。下面按四步操作。先算两笔账:写检查点的时间与中断回退的时间在配置之前,先把中断...
Llama3 70B分布式微调算力需求:要几张卡、多少显存

先把结论摆出来:Llama3 70B分布式微调算力需求取决于微调方式和序列长度两个变量——全参数 FP16 走 FSDP/ZeRO-3 至少 4×80GB,常规配置 8×80GB;FSDP+QLoRA 4-bit 可以压到 2-4 张 24GB/48GB 中端卡;一旦序列长度拉到 8k 以上或卡间没有 NVLink,就要重新评估档位。下面直接给四档对照...

DeepSpeed多卡分布式训练踩坑指南:5步定位OOM

当你用 DeepSpeed 在 8 卡 A100 上跑大模型微调,刚启动就报 CUDA out of memory,或者训练到第 3 个 step 直接卡死不动时,别急着加显存——这篇 DeepSpeed多卡分布式训练踩坑指南按五个落点依次排查,多数问题在配置层就能解决。不过动手前有个前提:请先确认 DeepSpeed 版本。2026 年 8 月发布的...

云厂商集体提价下AI团队挑选GPU租用的4个评估维度

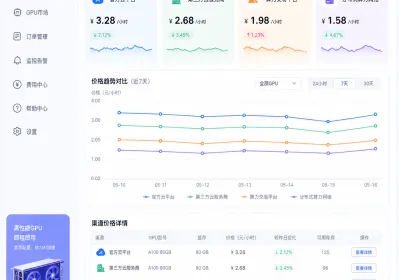
7月22日,云计算服务提供商 DigitalOcean 发布官方通告,宣布自8月1日起将旗下多款 NVIDIA 与 AMD 的 GPU 实例按需价格上调约 30%。其中 NVIDIA H100 80GB 的单时租金从 3.39 美元升至 4.41 美元,H200 以及 AMD MI300X 也迎来同步上涨。官方将原因归结为生成式人工智能(Generat...