 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
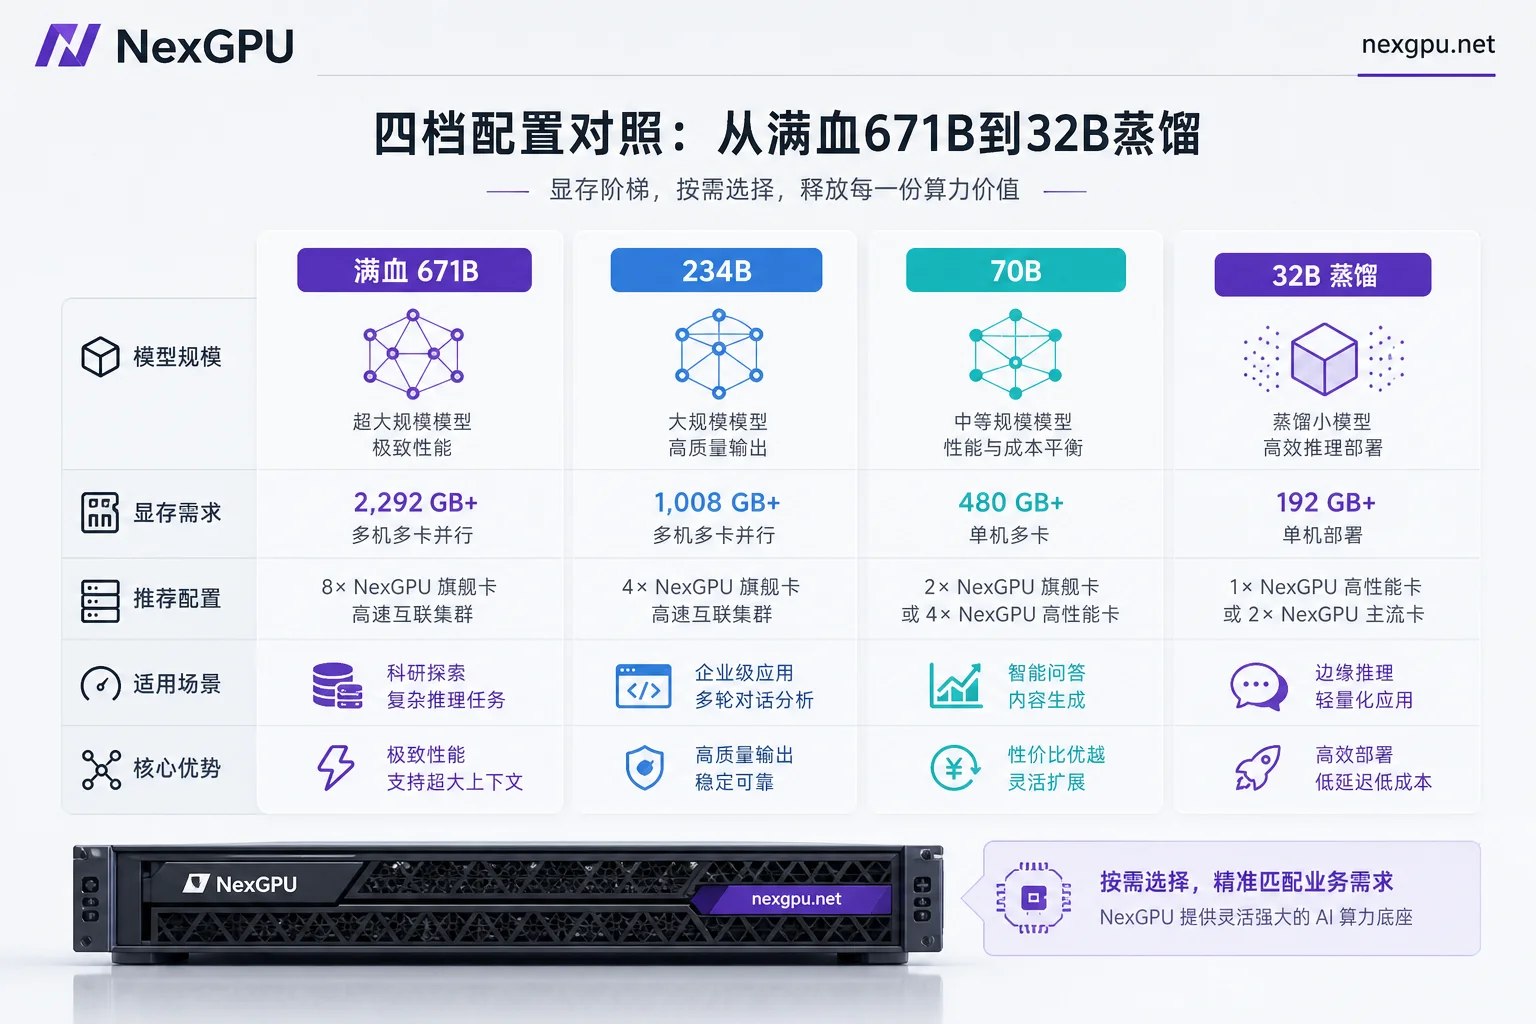
DeepSeek-R1私有化部署GPU配置并不存在唯一正确答案,按模型规模与精度可拆成四档:671B满血FP8需750GB~1000GB显存(8×H200或16×H100),671B量化后约380GB~480GB(6~8卡A100/H100 80GB),70B蒸馏量化后35GB~40GB(双卡4090或单卡A100 80GB),32B蒸馏量化后16GB~22GB(单卡4090可跑)。
2026年企业级私有化推理走向精细化选型,vLLM、SGLang、AWQ、GGUF等工具链成熟,各档硬件边界已形成公认基准。下面从模型选型开始,逐档拆解显存账本与卡型组合。
先分清:要部署的是671B满血版还是蒸馏版
DeepSeek-R1满血版是671B参数的MoE架构,推理时单Token激活约37B参数,这常让人误以为显存需求不大。但所有专家权重必须常驻显存,因此"DeepSeek-R1蒸馏版和满血版部署差多少"的核心在于显存差一到两个数量级:满血版动辄数百GB,蒸馏版则从几十GB到几GB。
蒸馏版按参数规模分为70B、32B等,适合业务场景相对聚焦、对通用推理能力要求不极致的团队。选型顺序应是:先定模型规模与精度,再倒推DeepSeek-R1私有化部署GPU配置,而不是反过来。
第一档:671B原生FP8为什么落在8×H200或16×H100
按FP8每参数约1字节粗算,671B权重本身即接近700GB量级,叠加长上下文KV Cache后,实际部署显存落在750GB~1000GB区间(Google Cloud AI Hypercomputer部署指南给出的标准配置口径),因此标准生产部署推荐单机8×H200(每卡141GB)或跨节点16×H100(每卡80GB)。
8卡H200是否足够,取决于上下文长度与并发:单机8卡方案节点内通信效率高,部署简单;跨节点16卡则需额外考虑节点间通信开销,网络带宽不足会明显拖慢生成速度。若你的业务长上下文或高并发,建议按上限预留。
第二档:671B 4-bit量化后要几张A100
采用AWQ或GGUF做4-bit量化后,671B模型的显存需求可压至380GB~480GB,这使单台6~8卡A100/H100 80GB节点成为可能。Prem AI在2026年3月的自托管指南中给出了这一区间。
换算到卡数,4-bit量化后的671B大致需要6~8张80GB卡。注意这是社区与厂商的基准范围,实际值随上下文长度、并发数与量化精度(如INT4还是FP8)浮动。上线前务必用目标负载实测,避免按理论值配卡导致OOM。
第三档:70B蒸馏版,双卡4090与单卡A100 80GB怎么选
70B蒸馏版在BF16/FP16下权重约需140GB显存,4-bit量化后降至35GB~40GB。这带来两种典型组合:双卡RTX 4090(2×24GB)或单卡A100/H100 80GB。
双卡4090需要张量并行,卡间通信(NVLink或PCIe)和显存碎片会影响实际可用容量,但成本门槛低。单卡80GB部署更简单,稳定性和吞吐更可控,但硬件成本不同。如果你预算有限且任务并发不高,可参考GPU显存怎么选中的经验;若追求推理性能一致性,建议选单卡80GB。
第四档:32B蒸馏版单卡4090能不能跑
"DeepSeek-R1 32B单卡4090能跑吗"?答案是能,但有限制条件。BF16精度下显存约需64GB,单卡24GB显然不够;而INT4/4-bit量化后降至约16GB~22GB,可以在RTX 4090上独立运行。
要注意长上下文与高并发会大幅增加KV Cache占用,挤占剩余显存。建议先用短上下文、低并发验证,再逐步增加负载。若需更长的上下文窗口,可考虑Qwen2.5-72B多卡量化部署教程中提到的多卡方案。32B量化档对显存余量敏感,可先用NexGPU的单卡按量资源按目标上下文长度跑一轮验证再决定是否长期占用。
常见误判:MoE激活37B为何显存仍按671B算
这是最典型的规划错误。虽然单Token只激活37B参数,但推理时全部671B专家权重必须常驻显存,否则无法在Token间快速切换。显存预算必须按全量权重加KV Cache计算,不能按激活参数缩减。
另外两个常见误判:忽略KV Cache的线性增长,以及按理论权重值配卡不留余量。多卡并行时,张量并行会复制部分权重,显存占用可能高于单卡理论值。
量化降档的代价:上线前该验证哪些指标
4-bit量化不是零成本。671B量化后虽能适配更少卡,但在复杂长链推理与代码生成任务中,存在细微困惑度上升与边界对齐波动。不能声称与原生FP8完全一致,需实测验证。
上线前建议按以下清单逐项检查:目标任务准确率(用测试集对比量化前后输出)、长上下文稳定性(压力测试)、显存峰值(监控工具)、并发下的吞吐与首Token延迟。尤其当业务对推理质量敏感时,谨慎选择量化精度。
DeepSeek-R1私有化部署GPU配置四档对照表与显存峰值实测清单
下表汇总四档配置,供快速决策:
| 部署档位 | 模型规模/精度 | 显存需求 | 典型卡型 | 卡数 |
|---|---|---|---|---|
| 满血FP8 | 671B FP8 | 750GB~1000GB | H200 141GB | 8 |
| 满血FP8 | 671B FP8 | 750GB~1000GB | H100 80GB | 16(跨节点) |
| 671B量化 | 671B INT4/AWQ | 380GB~480GB | A100/H100 80GB | 6~8 |
| 70B蒸馏 | 70B INT4 | 35GB~40GB | RTX 4090 | 2 |
| 70B蒸馏 | 70B INT4 | 35GB~40GB | A100/H100 80GB | 1 |
| 32B蒸馏 | 32B BF16 | ~64GB | A100 80GB | 1 |
| 32B蒸馏 | 32B INT4 | 16GB~22GB | RTX 4090 24GB | 1 |
选定档位后,建议在目标GPU上跑一次峰值实测,记录以下指标:测试上下文长度、并发数、KV Cache实际占用、显存峰值、是否出现OOM及临界点。这些数据能帮你验证理论区间,并为后续扩缩容提供依据。
若你处于选型初期,可参考H100与H200推理性能对比理解单卡差异,再结合vLLM多卡张量并行配置指南规划并行方案。NexGPU提供单卡按量、多卡节点与预制模板,32B/70B蒸馏档可用单卡或双卡按量快速验证,671B量化档对应多卡80GB节点,满血档则匹配H200/H100集群。建议先用按量资源跑一次显存峰值实测,再决定长期规格。
常见问题
部署671B满血版最少需要几张卡?
DeepSeek-R1私有化部署GPU配置的最低门槛取决于精度:若用FP8且接受较低上下文,8张H200(141GB)是最低配置;若用H100 80GB则需16张。量化为4-bit后,6~8张A100/H100 80GB即可满足基础运行,但性能会打折。
单卡4090跑32B蒸馏版会OOM吗?
取决于上下文长度和量化精度。INT4下理论显存16GB~22GB,24GB显存有余量,但长上下文(如8K以上)或高并发时可能OOM。建议先用短上下文测试,监控显存占用。
70B蒸馏版和满血版在硬件成本上差多少?
70B量化后仅需双卡4090或单卡A100 80GB,而满血版至少需要8卡H200级别集群。硬件成本差距可达数倍甚至数十倍,但精度和通用能力也差一个量级。
量化后模型效果会下降很多吗?
不会零损失,但复杂任务可能表现出困惑度上升或边界对齐波动。建议用业务测试集对比量化前后输出,尤其关注长链推理和代码生成,若质量不达标可退回FP8。
如何估算私有化部署的总成本?
无法直接给数字,但可按卡时租金和运行时长估算。例如先按8卡A100跑一档量化版本,记录峰值显存和吞吐,再乘以目标使用时长的租金单价。建议先用按量资源做PoC。本文不提供具体时租数字,价格随卡型、地域与计费方式差异较大,请以所选平台当期公开报价为准。



评论(0)