 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
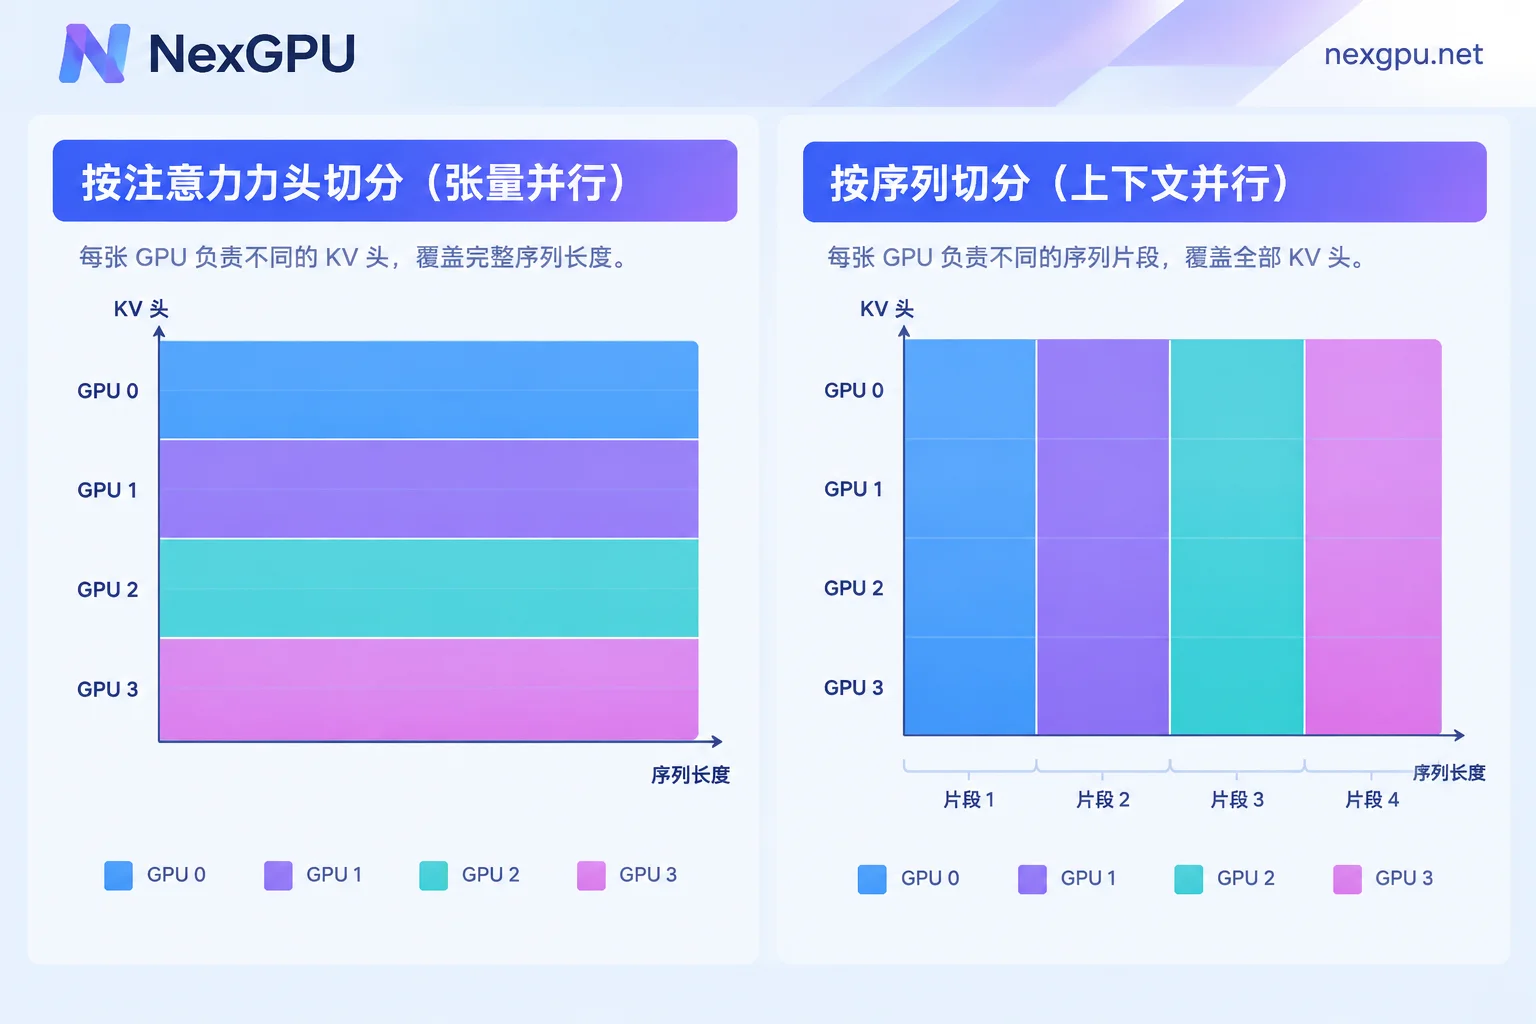
简单说,KV Cache 按序列切分,就是把同一个请求的 KV Cache 按 token 位置(序列长度这一维)拆开,分给多张 GPU 保存。比如一个 128K token 的请求放到 4 张卡上,每张卡只存其中约 32K 个位置的键(K)和值(V),不用每张卡都保留完整的 128K 上下文。
框架文档和论文里一般把这种做法叫上下文并行(Context Parallelism,CP)。如果只在解码阶段这样切,通常叫解码上下文并行(Decode Context Parallelism,DCP)。
它主要解决一种情况:上下文太长,单卡放不下 KV Cache,而按注意力头切分(张量并行)又已经到了上限。这时按序列切分仍然可以靠加卡来分摊显存。
先看 KV Cache 有哪几个维度
KV Cache 的张量一般有五个维度:层数、批量大小、KV 头数、序列长度(seq_len)、头维度。说 KV Cache 怎么切,其实就是选一个维度拆到多张卡上:
- 按 KV 头数切:张量并行(TP)的做法
- 按 层切:流水并行的做法
- 按 seq_len 切:本文说的按序列切分
常规推理中,即使用了张量并行,每张卡上的 KV Cache 也覆盖这个请求的全部 token 位置,TP 只是让每张卡少存几个头。上下文变长时,每张卡上的 KV Cache 会随 token 数一起增长。
估算方法很直接,每个 token 占用的 KV 字节数 = 2(K 和 V)× 层数 × KV 头数 × 头维度 × 每个元素的字节数。
以一个 80 层、8 个 KV 头、头维度 128 的模型为例,这和 70B 级 GQA 模型的常见配置接近。用 FP16 时,每个 token 的 KV 约 320KB:
- 128K token 的单个请求约 40GB
- 到 1M token 约 320GB,已经超过这个模型 FP16 权重本身(约 140GB)
所以在 128K 到百万 token 的场景里,KV Cache 往往比权重更占显存。具体怎么算、有哪些更省事的手段,可以看长上下文推理显存不够怎么办。
和张量并行有什么不同
张量并行沿注意力头切分,问题出在现在主流模型的结构上。GQA(分组查询注意力)和 MQA 把 KV 头压得很少,常见只有 8 个,MQA 甚至只有 1 个。按头切,切分路数基本被 KV 头数卡住:8 个 KV 头最多有效切成 8 份。
再多加卡,多出来的卡上通常只能复制 KV 头,单卡的 KV 显存不会继续下降。具体行为以所用框架为准。
按序列切分不受头数限制。序列越长,能切的份数越多,显存压力可以按卡数分摊下去。两者也不冲突,可以先用 TP 切头,再用 CP 切序列,实际能怎么组合要看框架支持。张量并行和流水并行本身怎么选,可以参考这篇对比。
切开以后,注意力怎么还能算对
注意力要求每个 token 看到它前面的所有 token,而这些 token 的 KV 现在分散在不同的卡上,所以必须靠卡间通信来补齐。Prefill 和 Decode 两个阶段的做法不同。
Prefill(预填充)阶段:把长 prompt 切成几段,分给不同 GPU 并行计算各自的投影和局部 KV,再用以下两种方式之一完成全局注意力:
- Ring Attention:各卡把自己的 KV 块沿环形传给下一张卡,边传边算,转完一圈,每张卡都和全部 KV 算过一遍
- DeepSpeed-Ulysses:用 All-to-All 通信把按序列切分临时转成按头切分,算完注意力再转回来
这样,长 prompt 的预填充可以由多卡分担,首字延迟(TTFT)会明显下降。
Decode(解码)阶段:每生成一个新 token,它的 Query 都要和全部历史 KV 计算注意力。做法如下:
- 每张卡用本地那一段历史 KV 和这个 Query,算出局部注意力结果,同时记录这一段的 LogSumExp(LSE)
- 通过通信把各卡的结果收集起来
- 用 LSE 做修正和归一化后合并
softmax 的分母本来要对所有位置求和,LSE 正好记录了每一段的归一化量,所以合并后在数学上和单卡算出的结果一致,不是近似。这样每张卡都不需要复制一份完整的上下文。
和 PagedAttention 不是一回事
这两个概念经常被混在一起:
- PagedAttention 在单卡内部管理显存。它借鉴操作系统的分页,把 KV Cache 放进固定大小的块里,减少碎片和浪费,但解决不了一张卡总量不够的问题。
- 按序列切分是跨卡、跨节点的并行策略,解决的就是单卡总量放不下的问题。
两者可以同时使用。vLLM、AWS Neuron 等推理框架就是在分页管理的基础上,再叠加上下文并行。
代价:通信在注意力的关键路径上
按序列切分没有免费的部分。每一层注意力都要做一次跨卡通信,而且这一步不做完就算不下去,所以速度很依赖卡间互联:
- 有 NVLink 等高速互联的单机多卡,代价相对可控
- 只走 PCIe,或者跨节点走普通网络,通信时间可能吃掉大部分收益
- 上下文不长时,切分省下的显存和计算可能还抵不上通信开销
加卡后速度没跟上的常见原因,可以看多卡推理为什么吞吐没有翻倍。如果你的问题主要是延迟,先分清是首字慢还是出字慢,参考大模型推理延迟高怎么优化。
什么时候值得考虑
下面几条大部分符合时,按序列切分才值得认真评估:
- 单个请求的上下文在几十万 token 以上,算下来 KV Cache 单卡放不下
- 张量并行已经切到 KV 头数的上限,再加卡显存也降不下来
- 有高速卡间互联,或者愿意为此选这样的节点
- 长 prompt 的首字延迟是主要痛点,需要多卡一起做 Prefill
如果上下文只有几万 token,或者显存只差一点,通常先试代价更低的办法更划算:KV Cache 量化、限制最大上下文长度、降低并发。这些办法不需要额外的卡,也不引入跨卡通信。
落到租卡上怎么做
- 先估算再选卡:用上面的公式算出目标上下文下的 KV Cache 总量,加上权重,判断需要几张卡、每张卡多大显存。
- 选有高速互联的多卡节点:在 价格与可租节点页 查看多卡节点的配置,重点确认卡间互联方式,不要只看显存总和。
- 选推理镜像并核对版本:在 镜像模板页 选 vLLM 或 TGI 镜像。不同引擎和版本对 CP/DCP 的支持程度不同,参数名称和默认是否开启,以对应版本的文档为准。
- 分两步验证:先用常规张量并行跑通,记录显存占用、首字延迟和出字速度;再开启上下文并行,用同样的长 prompt 对比。如果明显改善,再把它用到正式配置里。
多卡调试按小时计费。对比测试结束后,用不到的实例要及时处理:停机后仍会收存储费,销毁后才全部停止计费,需要保留的模型和数据要在销毁前先存好。


