只是一个默认分类
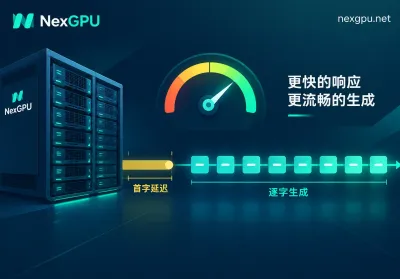
推理延迟高,先别急着换卡。建议先把延迟拆成两段:首字延迟(TTFT)和逐字延迟(TPOT,也叫 ITL)。首字慢通常出在预填充阶段,原因多是 prompt 太长,或者请求在排队。出字卡顿通常出在解码阶段,常见原因是显存带宽不够,或者正在生成的请求被新请求打断。这两类问题的瓶颈不同,处理方法也不同,搞错方向时调参往往没有效果。下面按排查顺序展开:先测,再...
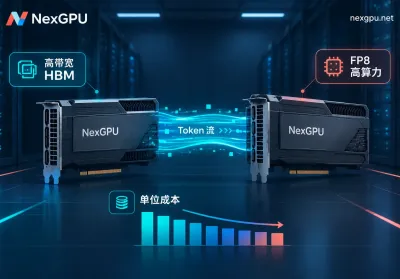
先说结论:请求并发高、模型能放进单卡(7B/13B,或 FP8 量化后的 30B 级),并且推理框架能开启 FP8 时,L40S 的每百万 Token 成本通常更低。并发低、要求逐字输出快、上下文很长,或者要把 70B 以上未量化模型切到多张卡上跑,A100 80GB 更合适,多卡时最好选 SXM 版本。两张卡的优势对应的是推理过程中的不同阶段。弄清楚...
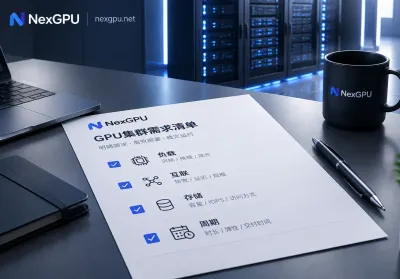
咨询GPU集群或预留资源时,不要只报一个显卡型号和数量。先把这批卡要跑什么、卡之间要不要高速通信、数据怎么读写、要用多久、平均能用满多少写成一份清单,再通过企业对接入口提交。这样对方能直接判断有没有合适的节点、多久能交付、怎么计费,不用反复追问。下面按实际顺序讲:先判断需不需要咨询,再整理清单,最后说明沟通时要问清哪些事。先判断:你的需求需要人工对接吗...
先给答案:要不要实名认证、要不要提前申请配额,取决于你租的是哪一类平台,而不是"租 GPU"这件事本身有统一规则。三句话版本:国内传统公有云(阿里云、腾讯云这类):实名认证是硬前置,GPU 实例的配额通常还要单独申请,两道门都得过。海外大厂(以 AWS 为例):不需要交中国身份证做实名,但 GPU 机型受 vCPU 限额管着,新账号常常连一台完整 GP...
消费级显卡(RTX 3090、4090 这类 24GB 档位)不是「玩具」,单卡轻量推理、LoRA/QLoRA 小参数微调、常规图像视频生成,它的性价比都很好。真正会卡住的是四种情况:模型权重就放不下 —— 70B 级别的模型即使 4-bit 量化也装不进 24GB。微调把显存需求翻了好几倍 —— 推理能跑的模型,全参数微调未必能跑。上下文拉长或并发上...
0 条留言
 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客