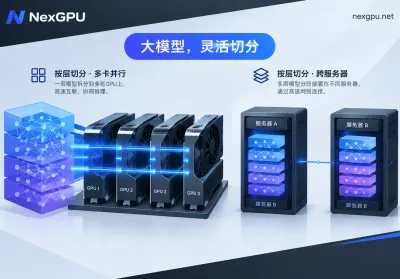
多数情况可以按这条规则选:单台机器里的多张卡,并且卡之间有 NVLink 这类高速互连,就优先用张量并行(TP);模型大到一台机器装不下、需要跨机时,机内用 TP,机器之间用流水并行(PP)。 如果模型和 KV Cache 一张卡就能装下,先别切分模型。这种情况下用单卡,或者开几个独立副本,通常更省事。下面说明这条规则的依据,以及几种需要另做判断的情况...
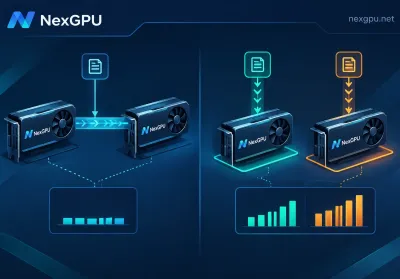
多卡推理吞吐要接近翻倍,前提是新增的卡在处理更多请求,而不是和原来的卡一起算同一个请求。很多人从 1 卡换成 2 卡时,只把 tensor-parallel-size 从 1 改成 2。这是张量并行(TP):两张卡各算模型的一半,每一层都要交换中间结果。它主要解决两件事:模型单卡放不下,以及单个请求太慢。它的设计目标不是把吞吐翻倍。如果模型本来就能装进...
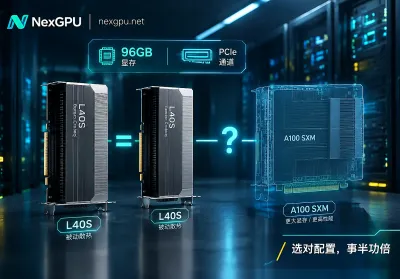
先给结论两张 L40S 凑在一起是 96GB 显存(单张 48GB),FP8 和 BF16 算力都高过单张 A100 80GB;代价是两张卡之间没有 NVLink,只能走 PCIe 4.0,单卡显存带宽 864 GB/s,大约只有 A100 HBM2e 的一半。所以能不能替代,取决于你的任务卡在哪一头:卡在算力和显存总量上,两张 L40S 更划算;卡在...
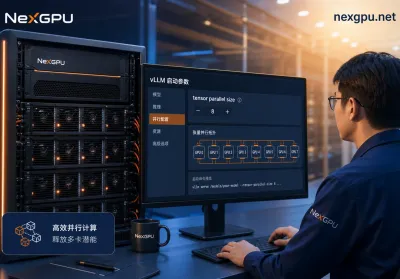
先给结论:vLLM多卡张量并行配置指南的参数决定顺序很多人以为把 --tensor-parallel-size 调得越大,多卡推理就一定越快,但实际上 TP 设多少要由显存分账和模型注意力头数共同决定,不是越大越好。正确的思路是:先按四笔显存账算出 TP 下限,再按注意力头数整除约束和卡间互联确定上限,然后依次调整 --gpu-memory-utili...
多卡推理优化的正确做法,是先按 Prefill 与 Decode 两段负载分别算账,再决定切分方式与加卡时机。很多团队直接翻倍卡数,结果 8 卡反而比单卡慢,归根结底是加的卡越多,通信税越重。这句话不是空谈。2026 年 8 月,vLLM 发布 v0.27.0,深入集成 FlashAttention 4,为 Blackwell SM100 提供 FP8...
 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客