 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
多卡推理时 GPU 利用率上不去,大多数情况下卡没有坏。问题通常出在下面五件事之一:
- 看错了指标
- 请求太少,GPU 没被喂饱
- 卡间通信在拖慢计算
- 并行方式和模型、硬件不匹配
- CPU 来不及把数据送给 GPU
建议按这个顺序排查。前两步几乎不用改配置,却能排除一大半误判。
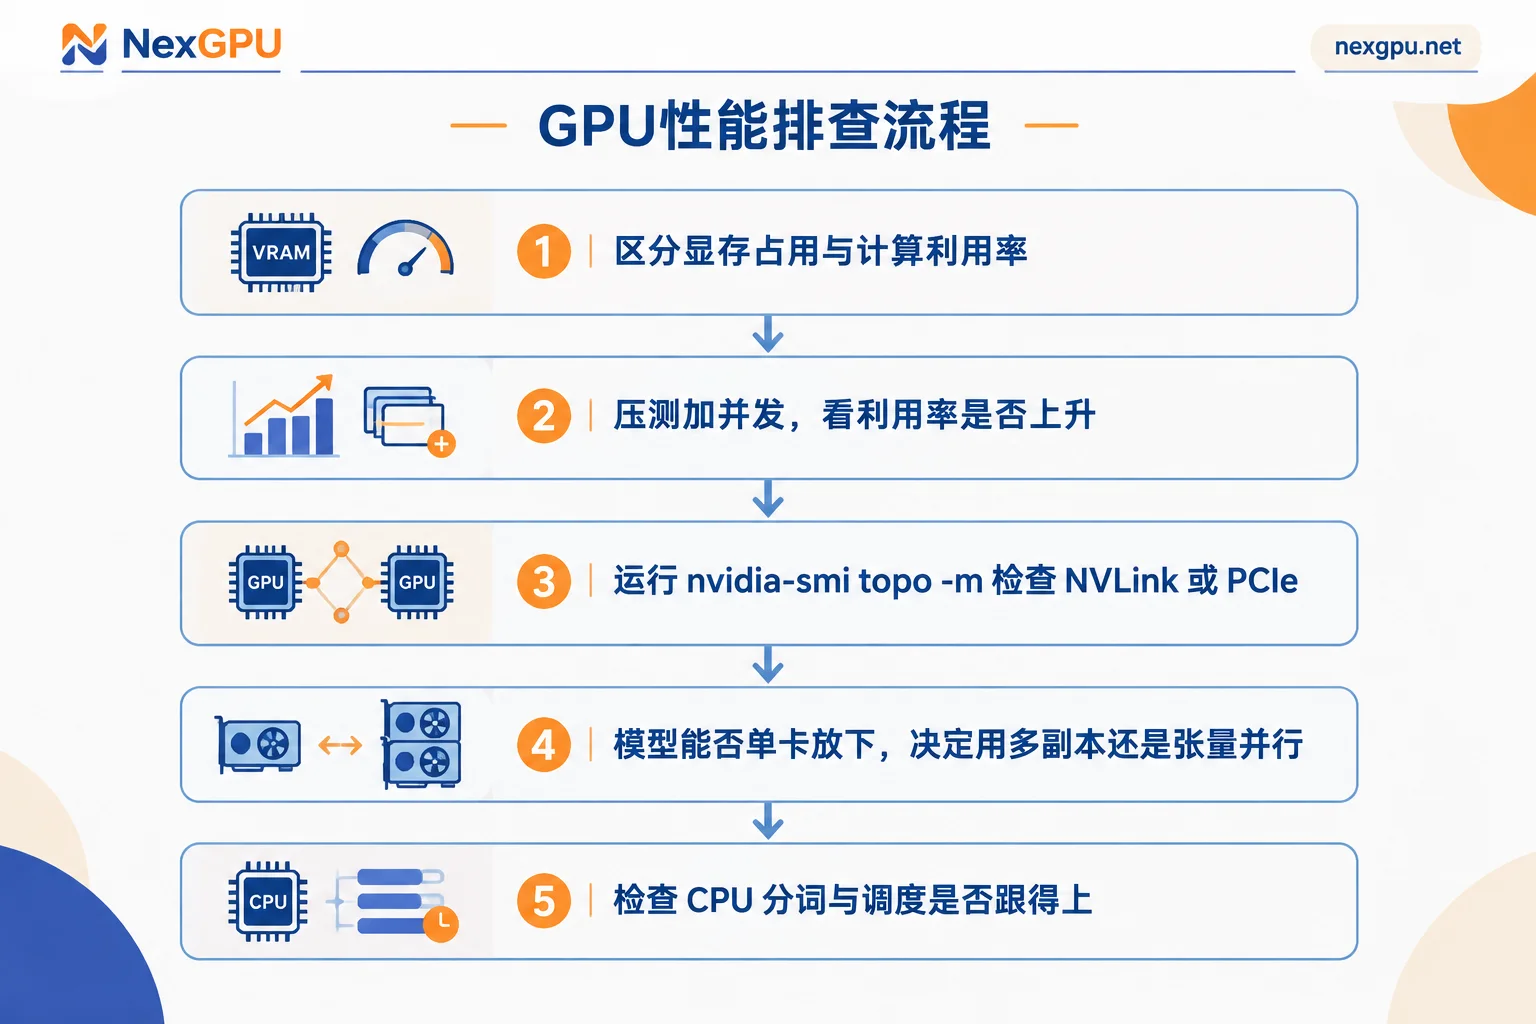
第一步:确认你看的是哪一种「利用率」
显存占满,不等于算力在跑。 以 vLLM 为例,--gpu-memory-utilization 默认是 0.9。服务一启动,就会预先占下约 90% 的显存,用来放模型权重和 KV Cache 池,所以 nvidia-smi 里显存会立刻显示接近满载。这只是提前把显存划好,计算单元并没有开始干活。没有请求进来时,计算利用率就是 0。
nvidia-smi 的 GPU-Util 也只是个粗略指标。 它反映的是采样周期内 GPU 有多少时间在执行任务,看不出计算单元实际忙到什么程度。要判断 GPU 到底卡在计算、显存读写还是通信上,最好用 DCGM 或 Nsight Systems 查看 SM 活跃度、显存带宽占用和通信时间。
第二步:先加够负载,再下结论
大模型推理分两个阶段:
- Prefill:一次性处理整段输入,计算量大,GPU 核心容易跑满。
- Decode:逐个生成输出 Token。每生成一个 Token,都要把模型权重从显存读一遍,但每次只算很少的东西。
所以 Decode 阶段的瓶颈主要在显存带宽,不在算力。并发低时,计算单元大部分时间都在等数据从显存送过来,计算利用率偏低是正常现象。这时如果查看显存带宽,往往已经接近上限。
提高利用率靠的是加大批次:同时处理的请求越多,读一次权重能完成的计算就越多。判断方法很直接:
- 压测看变化。 用接近真实业务的输入和输出长度做压测,逐步增加并发,观察吞吐和利用率是否一起上升。如果一起上升,说明之前只是负载不够,配置本身没问题。
- 线上流量本来就低。 那多卡本来就会闲着。优化参数帮助不大,更应该考虑减少卡数。
- 检查
--max-num-seqs。 这个参数限制同时处理的序列数,设得太小,会把批大小压住。适当调大能填满 GPU,但上限受 KV Cache 可用显存制约,上下文越长,能同时处理的序列越少。显存怎么估算可以参考长上下文推理显存不够怎么办。 - 利用率剧烈波动时,试试分块预填充(Chunked Prefill)。 它把长输入拆成小块,和正在生成的请求一起调度,避免长 Prompt 独占一段时间、其他请求干等。vLLM 用
--enable-chunked-prefill控制,部分版本已默认开启,以你所用版本的文档为准。
第三步:查卡间拓扑,看通信是否拖了后腿
加了并发,利用率还是上不去,而且用的是张量并行(TP),下一步就该查卡间连接。
TP 把每一层的计算拆到多张卡上,Transformer 每一层都要做多次 All-Reduce,也就是各卡同步一次计算结果。卡之间如果有 NVLink,同步很快。如果只走 PCIe,或者要经过 CPU 跨 NUMA 节点中转,通信延迟会成倍上升。GPU 算完一段就得停下来等同步完成,利用率自然掉下来。
先运行:
nvidia-smi topo -m输出矩阵里两张卡交叉位置的标记含义如下:
NV#:两卡之间有 NVLink,适合做 TP。PIX/PXB:经过 PCIe 交换芯片,能用,但通信明显慢于 NVLink。PHB:经过 CPU 的 PCIe 主桥。SYS:跨 CPU 插槽(NUMA 节点),通信最慢。
如果做 TP 的几张卡之间是 PHB 或 SYS,而且 TP 规模还不小,那么低利用率很可能主要来自通信等待。这时可以用 Nsight Systems 的时间线再确认一下,看 NCCL 通信在每一步里占了多大比例。
第四步:模型能单卡放下,就别切张量并行
很多利用率问题其实是并行方式选错了。
- 中小模型(如 7B~14B),或量化后(AWQ、GPTQ、FP8 等)能单卡放下的模型:把它强行切到多卡做 TP,只会多出通信和同步开销。如果追求总吞吐,更好的做法通常是多副本数据并行:每张卡独立跑一个完整实例(用
CUDA_VISIBLE_DEVICES把实例绑定到不同的卡),前端做负载均衡。各卡之间不用同步,更容易各自跑满。 - 模型大到必须拆分:尽量让 TP 只在 NVLink 互联的卡之间进行。在没有 NVLink 的机器上开很大的 TP,效果通常不理想。
- 流水线并行(PP):需要足够多的请求把流水线填满。并发不足时,各阶段之间会出现大量空等(流水线气泡),利用率同样上不去。
TP 和 PP 的具体选法见张量并行和流水并行怎么选;如果你关心的是加卡后吞吐为什么没翻倍,可以看多卡推理为什么吞吐没有翻倍。如果跑的是 MoE 模型,还要额外考虑专家路由带来的通信和专家负载不均,参考 MoE 模型专家负载不均怎么排查。
第五步:看 CPU 是否喂不上数据
如果利用率时高时低,周期性地一下子掉到底,同时 CPU 某个核心长期占满,就要怀疑 CPU 端成了瓶颈。
常见原因有:CPU 核数少或主频低;高并发时输入分词(Tokenize)和输出还原文本(Detokenize)没有充分异步化;Python 全局解释器锁(GIL)限制了调度线程。结果是推理引擎来不及给 GPU 补充新任务,GPU 只能空转。
处理思路:
- 给推理进程留出足够的 CPU 核,不要和其他重负载服务混跑。
- 升级框架版本。各版本在异步分词、调度方面的改进不同,以官方文档为准。
- 尽量把可以提前做的文本预处理放到服务前端完成。
症状对照
| 现象 | 更可能的原因 | 先做什么 |
|---|---|---|
| 显存接近满、计算利用率为 0 | 显存预分配,没有请求 | 接入请求或压测后再看 |
| 低并发时利用率低,加并发后上升 | Decode 受显存带宽限制,负载不足 | 调大 max-num-seqs,或减卡 |
| 加并发也上不去,用了 TP | 卡间通信瓶颈 | 跑 nvidia-smi topo -m,看是否走 PCIe 或跨 NUMA |
| 小模型多卡 TP,单卡利用率都偏低 | 并行方式不合适 | 改为单卡多副本 |
| 利用率周期性断崖下跌,CPU 某核满载 | CPU 喂不上数据 | 增加 CPU 资源,检查分词与调度 |
利用率低,直接影响账单
按小时计费的机器,GPU 空转的时间同样计费。排查完如果确认是业务流量本身不够,比起调参,更省钱的办法是减少卡数,或者换成单卡加量化。
在 NexGPU 上,算力按小时计费、按秒计量。停机后算力不再计费,但存储费仍会继续收取;实例销毁后,所有费用才会全部停止。测试阶段开的多卡机器,如果确认用不上,记得在保存好数据后销毁。
如果排查后确认确实需要大规模 TP,就要选卡间有 NVLink 的机型。可以先到价格页查看可租节点;机器租到后,第一件事是跑一遍 nvidia-smi topo -m,确认互联方式后再部署模型。需要长期使用多卡或评估集群方案时,可以直接联系我们沟通配置。


