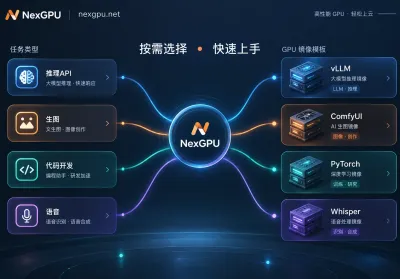
云 GPU 镜像模板怎么选:按任务定模板,避开编译坑和存储费陷阱

先问自己要跑什么任务租云 GPU 之前,先明确交付目标:是对外提供高并发 API 推理服务,还是自己做创意生图生视频,或是写代码做微调实验,还是批量转写音频?任务性质直接决定镜像模板的类型。生产级大模型推理或高并发 API 服务:直接选 vLLM 或 TGI(Text Generation Inference)镜像。这类镜像预编译好 PagedAtte...

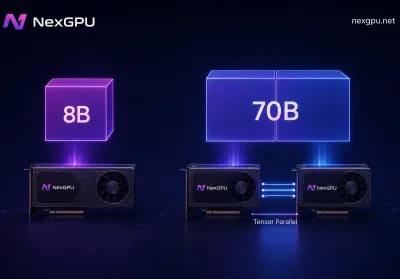
Llama 模型部署实操:选卡、vLLM 开服、多卡切分与停机费用边界

自部署 Llama 系列,真正卡住人的不是命令,而是三个判断:这个模型在你选的精度下要多少显存、单机单卡还是得切多卡、以及跑完之后账单从哪一刻停。把这三件事定下来,剩下的部署过程大概二十分钟就能跑通。下面按你实际动手的顺序来。先把显存账算完,再去挑卡显存需求由两部分构成:权重占用 + KV 缓存。权重那部分可以直接估算,参数量 × 每参数字节数,FP1...

Qwen2.5-72B多卡量化部署教程:4步完成

Qwen2.5-72B多卡量化部署教程可以压缩成四步:按卡型倒推量化档位 → 定 tensor parallel size → 写启动参数 → 用自建对照集验证。开源主力模型在企业端加速落地,显存分账成为部署核心矛盾。动手前先打开终端执行 nvidia-smi,记下卡数、单卡显存与卡间互联方式。FP16 精度下 72B 权重加运行时开销大约需要 140...
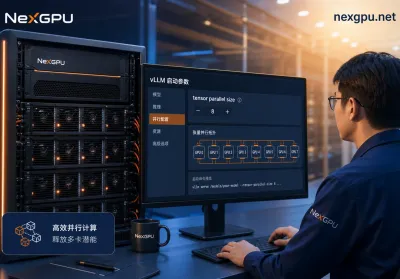
vLLM多卡张量并行配置指南:TP设多少与5步排查

先给结论:vLLM多卡张量并行配置指南的参数决定顺序很多人以为把 --tensor-parallel-size 调得越大,多卡推理就一定越快,但实际上 TP 设多少要由显存分账和模型注意力头数共同决定,不是越大越好。正确的思路是:先按四笔显存账算出 TP 下限,再按注意力头数整除约束和卡间互联确定上限,然后依次调整 --gpu-memory-utili...

GPU利用率优化怎么做?5步定位算力空转真原因

GPU利用率优化不是把利用率数字拉高,而是先打开监控面板,把 GPU 利用率、请求排队时长和前缀缓存命中率三个指标并列出来,再按下面的顺序排查:利用率数字→排队→带宽→重复计算→引擎选型。只看 nvidia-smi 的静态占用已经不够,需要结合请求分布和引擎参数做系统化判断。先给结论:GPU利用率优化的排查顺序是什么第一步,确认你看到的“利用率”数字到...