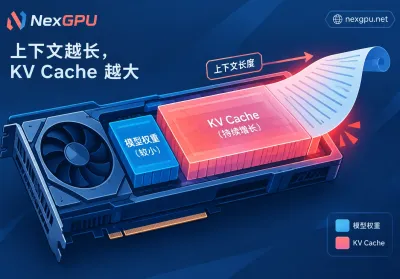
简单说,KV Cache 按序列切分,就是把同一个请求的 KV Cache 按 token 位置(序列长度这一维)拆开,分给多张 GPU 保存。比如一个 128K token 的请求放到 4 张卡上,每张卡只存其中约 32K 个位置的键(K)和值(V),不用每张卡都保留完整的 128K 上下文。框架文档和论文里一般把这种做法叫上下文并行(Context...
长上下文推理报 OOM,多数时候不是模型权重装不下,而是 KV Cache 随上下文长度和并发数一起增长,占满了显存。可以按这个顺序处理:先确认 OOM 出在哪一步,再估算 KV Cache 有多大,然后按改动代价从低到高依次尝试:限制长度和并发、把 KV Cache 量化成 FP8、开启分块 Prefill 和前缀缓存、把 KV Cache 卸载到 ...
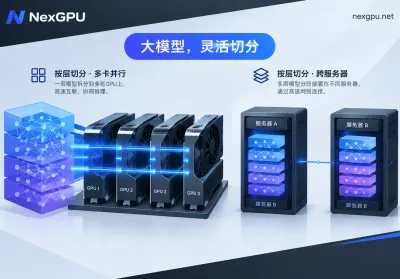
多数情况可以按这条规则选:单台机器里的多张卡,并且卡之间有 NVLink 这类高速互连,就优先用张量并行(TP);模型大到一台机器装不下、需要跨机时,机内用 TP,机器之间用流水并行(PP)。 如果模型和 KV Cache 一张卡就能装下,先别切分模型。这种情况下用单卡,或者开几个独立副本,通常更省事。下面说明这条规则的依据,以及几种需要另做判断的情况...
多卡推理吞吐要接近翻倍,前提是新增的卡在处理更多请求,而不是和原来的卡一起算同一个请求。很多人从 1 卡换成 2 卡时,只把 tensor-parallel-size 从 1 改成 2。这是张量并行(TP):两张卡各算模型的一半,每一层都要交换中间结果。它主要解决两件事:模型单卡放不下,以及单个请求太慢。它的设计目标不是把吞吐翻倍。如果模型本来就能装进...
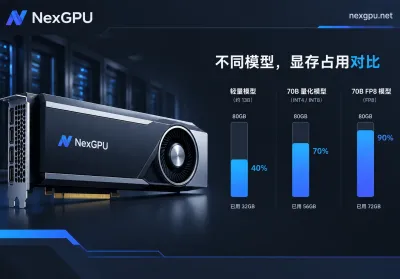
先说结论是否浪费,要看你跑的是什么模型、同时有多少请求、上下文有多长。多半浪费的情况:跑 7B、13B、14B 这类中小模型,自己调试或只有少量并发。这时显存大量闲置,算力利用率也很低,换成 RTX 4090(24GB)或 L40S(48GB)通常就够用,每小时租金也明显更低。值得用的情况:单卡跑 70B 级别的 INT4 或 AWQ 量化模型,要做大...
 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客