 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
只是一个默认分类
DeepSeek-R1私有化部署GPU配置怎么选?4档卡型显存对照
DeepSeek-R1私有化部署GPU配置并不存在唯一正确答案,按模型规模与精度可拆成四档:671B满血FP8需750GB~1000GB显存(8×H200或16×H100),671B量化后约380GB~480GB(6~8卡A100/H100 80GB),70B蒸馏量化后35GB~40GB(双卡4090或单卡A100 80GB),32B蒸馏量化后16GB...
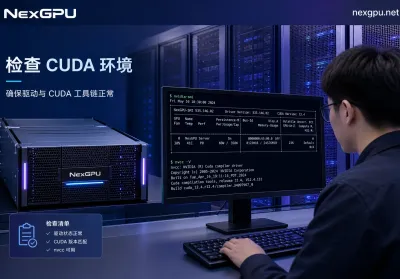
CUDA Toolkit加速大模型训练配置怎么核对?四层顺序
拿到云 GPU 实例后,先别急着敲安装命令,按四层顺序核对环境:驱动支持上限 → Toolkit 编译器版本 → 框架编译版本 → 算子是否真正走加速路径。CUDA Toolkit 加速大模型训练配置的核心,就是把这四层版本对应关系查清楚,再决定要不要装完整 Toolkit。先给结论:三个版本号各管什么,核对顺序怎么排很多人误以为 nvidia-smi...
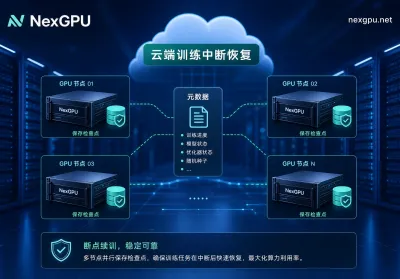
云端GPU长任务中断恢复与Checkpoint设置:4步配置
先估算两笔时间:单次保存检查点的耗时,以及中断后回退重算的耗时。把这两笔账合起来,除以平均中断间隔(MTBI),得到的就是业界通用的 Checkpointing Badput 指标。配置云端GPU长任务中断恢复与Checkpoint设置,就是把 Badput 压到可接受区间。下面按四步操作。先算两笔账:写检查点的时间与中断回退的时间在配置之前,先把中断...
FlashAttention-3显存与速度优化怎么做?4步实测
FlashAttention-3显存与速度优化只压缩注意力中间矩阵的 HBM 读写,不减权重和 KV Cache,且加速收益绑定 Hopper 架构(H100/H200)。PyTorch 官方博客 2024 年 7 月的测试数据显示,FP16 下 H100 算力利用率从 FA2 的 35% 提升到 75%(740 TFLOPS),FP8 吞吐接近 1....

